6.1 查询生命周期全解
6.1 查询生命周期全解
本节摘要:一条查询从文本到结果经过六个阶段:提交与解析、编译优化(云服务层,不计费)、仓库唤醒、排队、分布式执行(计费计时)、结果缓存。绝大多数"慢"可以归入三类——编译慢、排队慢、执行慢,三类的药方完全不同。本节走完全程,并给出查询画像(Query Profile)的五个必读指标。
一条查询的六段旅程
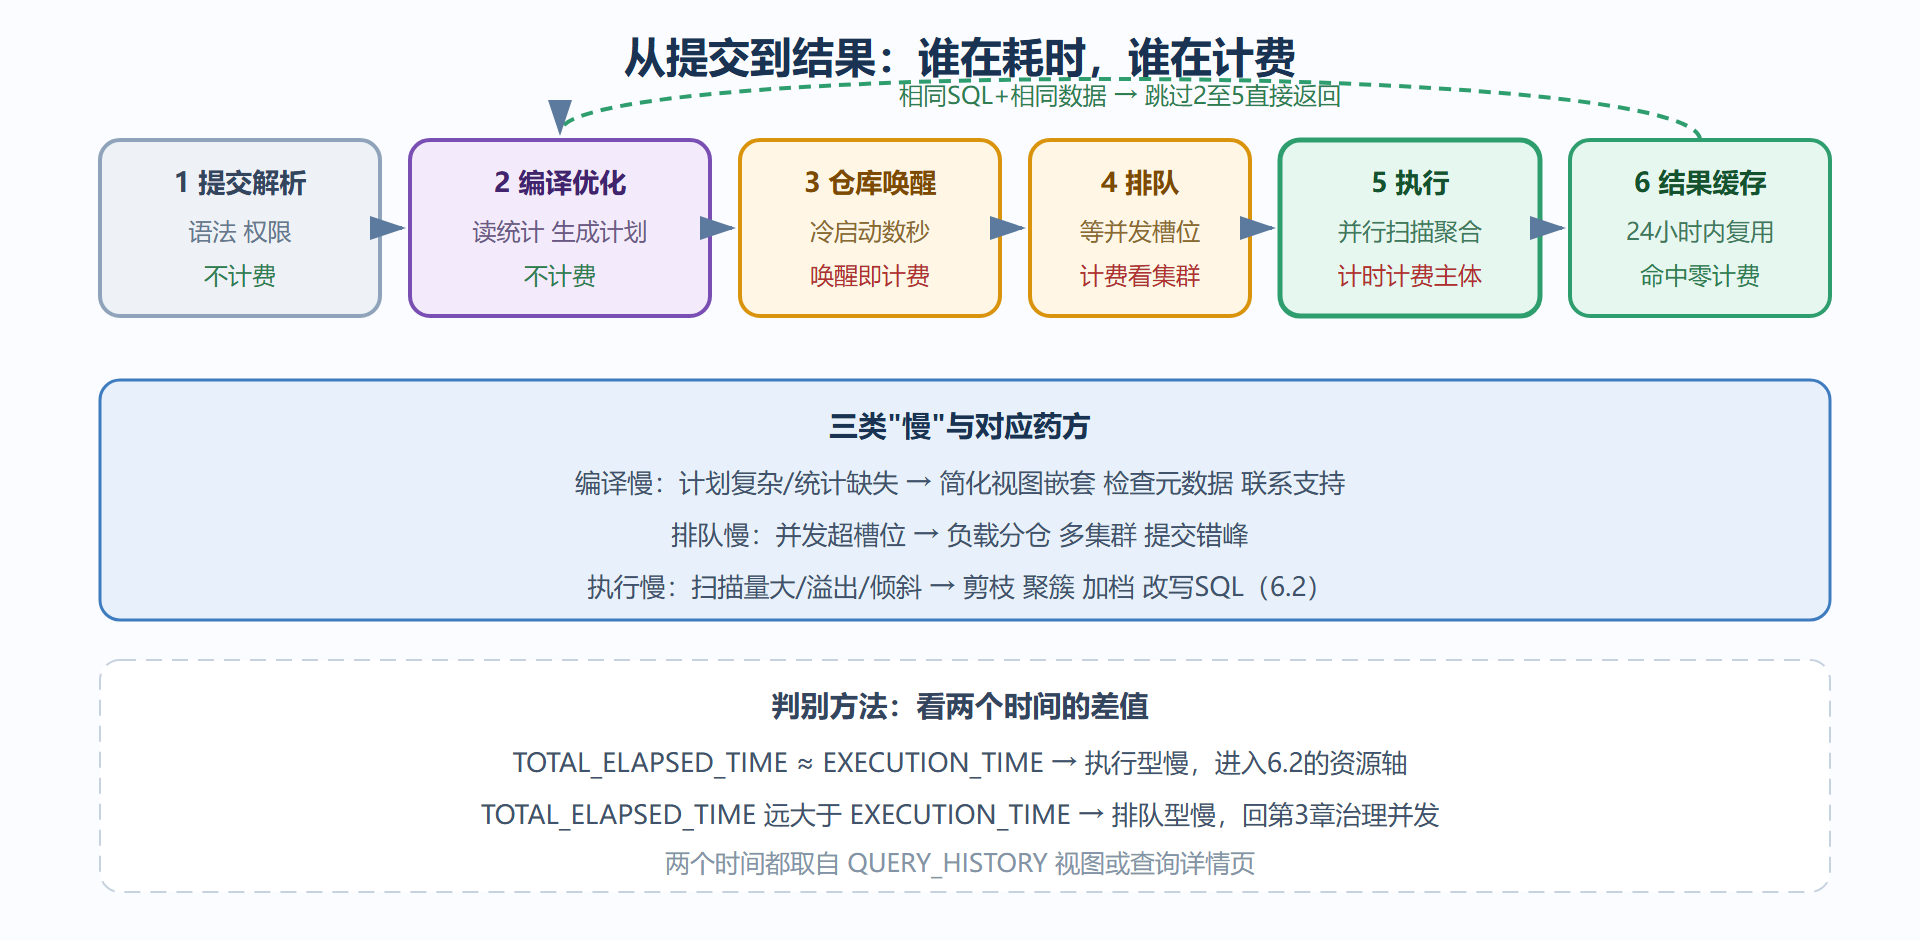
2.1 交代过查询穿越三层的粗轮廓,现在按时间轴展开成六个阶段。记住这段旅程,等于随身带了一张性能问题的地图:
- 提交与解析:SQL 文本到达云服务层,语法解析、对象名解析、权限检查。此阶段出错通常直接报错返回,不产生性能问题。
- 编译与优化:从元数据服务读取表结构、微分区统计,生成执行计划——决定扫描哪些分区、用什么连接顺序与策略。这一步完全在云服务层,不消耗仓库 credit。
- 仓库唤醒:仓库若在挂起,先冷启动(秒级)。冷启动期间查询状态显示为
RESIZING_OR_STARTING_WAREHOUSE。 - 排队:仓库运行中但并发槽位已满,查询排队等位;多集群仓库在此时触发扩容判定。
- 执行:计划切片分发给计算节点并行执行,扫描、连接、聚合,数据从对象存储或本地缓存流入。计时计费从这一段开始。
- 结果缓存与返回:完整结果集缓存 24 小时;相同文本与参数的查询直接命中返回。
图:查询生命周期六阶段与计费边界
查询画像:五个必读指标
执行慢的查询值得打开画像逐算子看。五个指标覆盖了绝大多数场景:
| 指标 | 看什么 | 典型异常与方向 |
|---|---|---|
| Partitions scanned / total | 剪枝效果 | 扫描占比高 → 过滤列没剪枝价值,考虑聚簇(6.2) |
| Percentage scanned from cache | 本地缓存命中 | 长期为 0 → 冷数据或缓存被冲掉 |
| Spilling to local/remote storage | 中间结果溢出 | 远程溢出是重灾信号 → 加档位或减少一次性物化 |
| Joining on / skew | 连接与数据倾斜 | 单节点耗时占比畸高 → 分布不均,检查连接键 |
| Operators 的耗时排行 | 瓶颈算子 | 最贵算子是否值得:聚合在扫全表,还是连接策略选错 |
一个实际读法示例:画像显示 TableScan 扫了 98% 的分区、Join 节点远程溢出 2GB——这两个信号叠加,说明问题不在算力而在扫描量:先修剪枝(过滤列的统计分布),剪不动再谈聚簇,最后才考虑升档位。顺序反了,钱花了,查询照样慢。
排队与超时的参数面
排队治理的参数集中在仓库与会话两级:
-- 仓库级:并发槽位与语句超时 ALTER WAREHOUSE bi_wh SET MAX_CONCURRENCY_LEVEL = 8; -- 默认8 ALTER WAREHOUSE bi_wh SET STATEMENT_QUEUED_TIMEOUT_IN_SECONDS = 300; -- 排队超过5分钟直接失败,避免用户面对"永远转圈" -- 会话级:单语句超时(交互场景保护) ALTER SESSION SET STATEMENT_TIMEOUT_IN_SECONDS = 600;
STATEMENT_QUEUED_TIMEOUT_IN_SECONDS 常被忽略,但它是"队列雪崩"的保险丝:BI 端失控的循环刷新会把队列堆到数百条,有了排队超时,堆不住的查询快速失败,反而保护了队列里已获槽位的查询。
结果缓存的命中条件
结果缓存是最便宜的性能(命中时零计算),但它的命中条件比想象中严格,四条同时满足才命中:
- SQL 文本与参数完全一致(差一个空格都算新查询);
- 底表数据未变化(任何 DML、行级策略变更都会使其失效);
- 结果未超缓存期限(24 小时)与大小限制;
- 用户对底表权限未变。
由此推出两个实用结论:BI 仪表盘里"完全相同的查询"命中率远高于人手写的即席查询;想在批处理里利用结果缓存,就要让 SQL 文本参数化生成而不是拼字符串——拼出来的"看似相同"文本,在缓存眼里都是陌生人。
💡 关键直觉:查询慢的排查顺序应当是"先分阶段、再看画像、最后调资源"。跳过定位直接升档位,就像头痛医脚——多数时候无效,偶尔碰巧,长期很贵。
本节要点回顾
- 六阶段:解析、编译、唤醒、排队、执行、缓存;只有唤醒之后涉及计费。
- 三类慢:编译慢、排队慢、执行慢,用 ELAPSED 与 EXECUTION 的差值初判。
- 画像五指标:分区扫描比、缓存命中、溢出、倾斜、算子耗时排行。
- 缓存四条件:文本一致、数据未变、期限未过、权限未变。
执行慢的病根在扫描量。下一节打开存储侧的武器库:剪枝、聚簇、缓存与搜索加速。
三条真实查询的画像解读练习
把画像方法变成肌肉记忆,靠的是重复解读。三条典型画像及其诊断:
画像一:TableScan 扫描占比 3%,聚合算子占时 80%。诊断:剪枝优秀,慢在聚合本身——数据倾斜或分组基数过大,考虑预聚合或改写分组键。
画像二:Join 节点提示远程溢出 3GB,整体耗时随并发波动。诊断:中间结果超出节点内存,先缩小两侧扫描量(列裁剪、谓词下推),确需大连接再升档位;升档前先看溢出是否消失于列裁剪之后。
画像三:执行时间 2 秒,总耗时 90 秒。诊断:排队型慢,与 SQL 质量无关,回到第3章查仓库并发与队列,用排队超时参数止血。
三个练习的共同点:先定位阶段,再谈手段。把这条纪律固化进团队的排障模板,能省掉大量无效升档。
把生命周期映射到监控告警
生命周期不只是排障地图,也是监控指标的分层框架。按阶段选指标,告警才不会互相淹没:编译阶段关注编译耗时分位数(P95 突涨多半是元数据或服务层事件,找平台而非改 SQL);排队阶段关注排队查询数与最长等待(突增指向并发结构变化,动作在分仓与多集群);执行阶段关注扫描量与溢出(劣化通常对应数据增长或 SQL 变更,动作在 6.2);缓存层关注命中率(骤降常伴随上游加载频率变化)。四个阶段四组指标,值班同学拿到告警先问"哪个阶段",再按阶段对应的责任人派单——监控体系与生命周期同构,归因路径自然清晰。
一个常见误解的澄清
"查询慢是因为表太大了"是排障对话里出现频率最高的说法,但生命周期框架下它多数时候不成立:同样的表大小,剪枝良好时扫描量可能只是零头,缓存命中时甚至零成本。表大小决定的是扫描量的上限,不是耗时本身。把这句话从团队的口头禅里删掉,换成"这条查询扫了多少分区"——问题的形态一变,解法往往自己浮现。