6.2 剪枝、聚簇、缓存与Search Optimization
6.2 剪枝、聚簇、缓存与Search Optimization
本节摘要:执行阶段的性能由"一次扫描读多少数据"决定。本节把存储侧的四大武器排成递进关系:剪枝是免费的默认能力;聚簇键是花钱修复剪枝的手段;缓存是让重复访问变快的机制;Search Optimization 则是给点查专设的加速索引。每个武器都给出启用条件、验证方法与成本警示。
从剪枝开始:免费的默认能力
4.2 已经讲过原理:每个微分区对每列记录 min/max 统计,查询条件与统计比对,未命中的分区根本不读。这里补上"怎么验证与怎么用":
-- 验证一条查询的剪枝效果 SELECT PARTITIONS_SCANNED, PARTITIONS_TOTAL, ROUND(100 * PARTITIONS_SCANNED / PARTITIONS_TOTAL, 2) AS scanned_pct FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY WHERE QUERY_ID = '<刚才的查询ID>'; -- 看一张表的分区分布质量:返回每个分区统计区间的重叠情况 SELECT SYSTEM$CLUSTERING_INFORMATION('orders', '(order_date)'); -- 关注 average_overlaps(平均每分区与几个分区区间重叠):越接近1剪枝越好
average_overlaps 是聚簇质量的量化口径:1 表示各分区按该列完全分层(理想),数值越大说明分区区间越纠缠。剪枝好的表不需要聚簇——先把这句刻进肌肉记忆,再谈花钱的事。
聚簇键:花钱修数据顺序
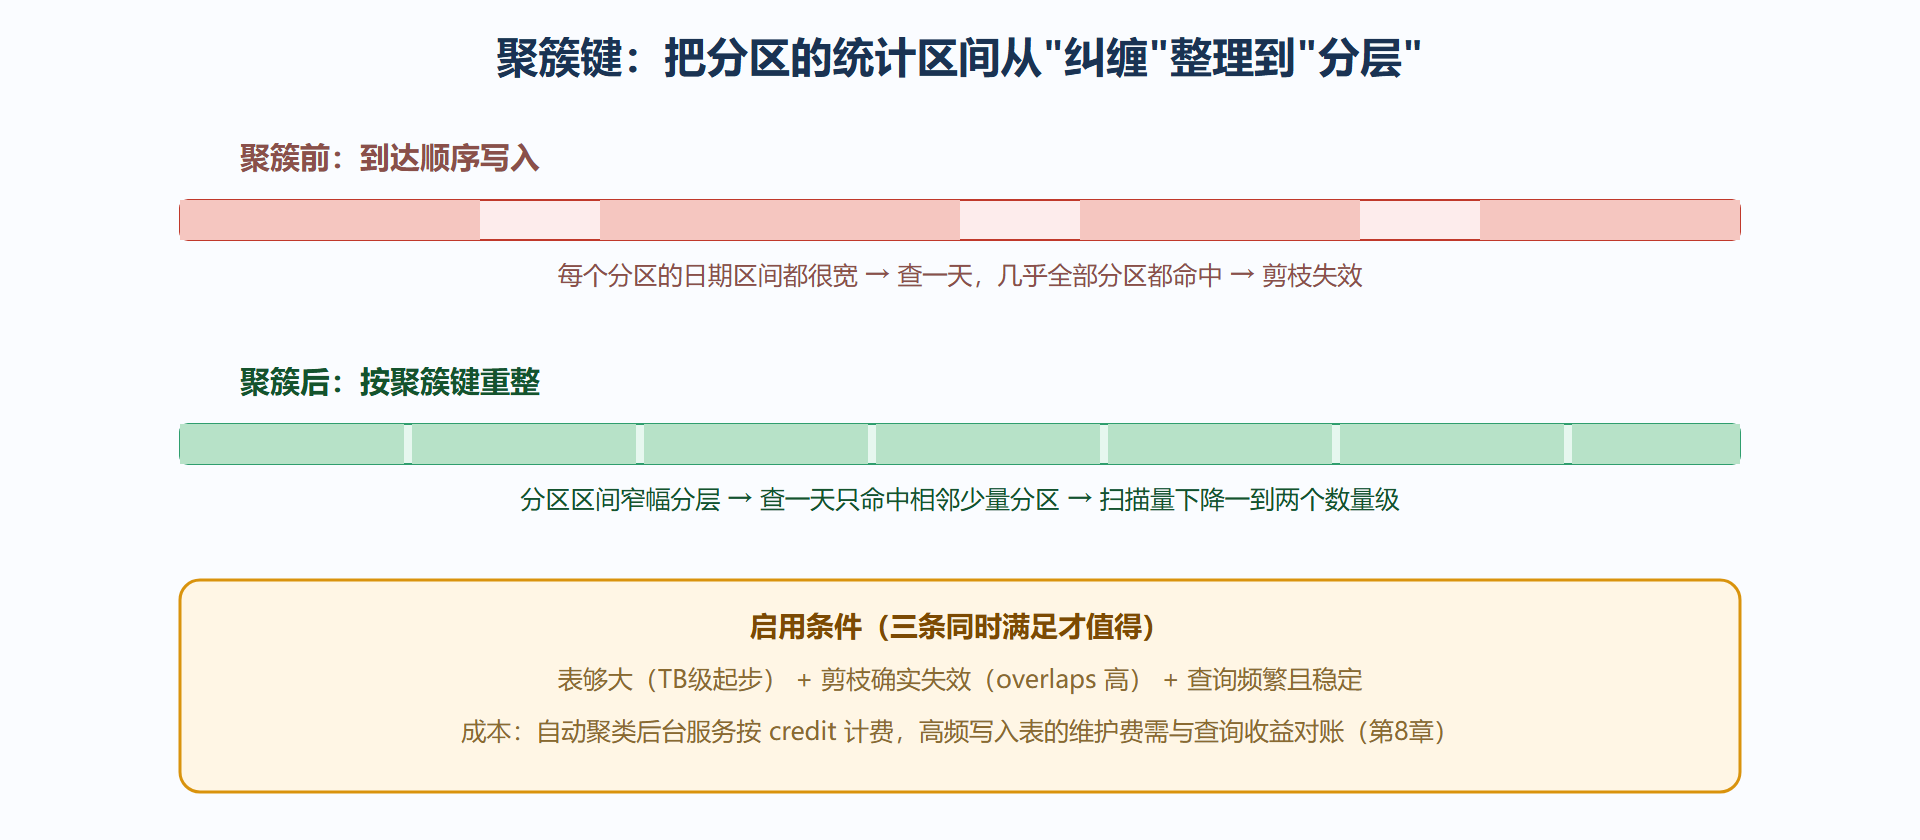
当剪枝失效(分区统计区间宽幅重叠)且查询频繁按某几列过滤时,聚簇键登场:
-- 给大表定义聚簇键:先低基数(年月),后高基数(客户) ALTER TABLE events CLUSTER BY (TO_DATE(event_time), customer_id); -- 定义后由后台自动聚类服务逐步重整分区 -- 观察重整效果 SELECT SYSTEM$CLUSTERING_INFORMATION('events', '(TO_DATE(event_time), customer_id)');
两个设计要点。列序有讲究:先放基数低、常做范围过滤的列(日期),再放基数高的列(ID),让分区先按粗粒度分层、再在层内细分。成本是持续性的:自动聚类是后台服务,每次数据写入触发分区重整都要消耗 credit 与临时存储;一张高频写入的大表,聚簇维护费可能赶上甚至超过查询收益。
聚簇的投入产出判断流程值得背下来:
查询慢 + 扫描占比高 → 过滤列的统计区间是否重叠(CLUSTERING_INFORMATION) → 不重叠:剪枝没生效?检查过滤条件是否用了函数包列(如 DATE(ts) = ...) → 重叠且表大(TB级)且查询频繁:上聚簇,观察一周聚类credit与查询credit的此消彼长 → 表不大或查询稀少:别上,先优化SQL
图:聚簇前后分区区间对比
三级缓存:让重复访问变便宜
Snowflake 的缓存在三个位置各司其职,命中条件与失效规则不同:
| 缓存层级 | 位置 | 存什么 | 失效时机 |
|---|---|---|---|
| 结果缓存 | 云服务层(全局) | 完整查询结果 | 24小时到期、底表变化、权限变化 |
| 本地数据缓存 | 仓库计算节点 SSD | 刚扫过的微分区列块 | 仓库挂起、节点替换 |
| 元数据缓存 | 云服务层 | 表结构与统计 | 对象被修改 |
本地缓存的隐性影响常被低估:同一个查询,跑在"刚扫过这张表的仓库"上明显快于冷仓库,差异不是玄学而是缓存。这也解释了两个现象:一是把查询打散到多个仓库时,每个仓库都要重新"暖机";二是批处理窗口开始的第一批任务总是偏慢——前一晚仓库挂起,缓存全空。
Search Optimization:给点查的专属武器
剪枝与聚簇优化的是"范围扫描",而 WHERE order_id = 'X' 这类点查在 TB 大表上即使剪枝也只能扫大量分区。Search Optimization Service 为指定列构建专用搜索索引结构,把等值点查从秒级拉到毫秒级:
-- 在表级开启,指定要加速的列(按需,别全表开启) ALTER TABLE orders ADD SEARCH OPTIMIZATION ON EQUALITY(order_id); -- 检查加速是否已就绪(索引构建是异步后台过程) SELECT SYSTEM$SEARCH_OPTIMIZATION_PROGRESS('orders');
代价同样直白:额外存储(通常为表的一小部分比例,随指定列数增长)与后台构建维护的计算。适用判据:等值点查频繁、对延迟敏感、行级定位需求真实存在——如果点查只是偶尔的管理操作,一个 CLONE 出的小表或应用侧缓存更划算。它也是"Snowflake 免索引"叙事的精确边界:免的是"人人都要建的 B+ 树",不免"确有必要的专用索引"。
⚠️ 常见坑:在过滤条件里用函数包住列,如
WHERE DATE(event_time) = '2024-06-01'。函数改变了列值的形态,min/max 统计对不上,剪枝直接失效。改成区间写法WHERE event_time >= '2024-06-01' AND event_time < '2024-06-02',剪枝立刻复活。这是成本最低、见效最快的优化,没有之一。
本节要点回顾
- 四大武器递进:剪枝(免费)→ 聚簇(付费修顺序)→ 缓存(重复访问变快)→ Search Optimization(点查专用)。
- 聚簇三条件:表大、剪枝失效、查询稳定频繁;用 average_overlaps 量化判断。
- 缓存三级:结果、本地数据、元数据;仓库挂起即清空本地缓存,批处理第一波任务偏慢是物理规律。
- 函数包列是大敌:WHERE 里对列套函数会废掉剪枝,改区间写法立竿见影。
性能的账算完了,效率与成本的天平也露头了。下一章转向天平的另一端永远绕不开的主题:谁能碰这些数据——安全与治理。