3.1 虚拟仓库与T恤档位:弹性伸缩机制
3.1 虚拟仓库与T恤档位:弹性伸缩机制
本节摘要:虚拟仓库是一组无状态、按需启停、独立计费的计算资源。本节讲清它的三个"虚拟"属性,给出 XS 到 6XL 的完整档位阶梯(每档 credit 消耗翻倍),并解释纵向升档的适用边界——查询不是越大越快,数据扫描量不足时升档纯属烧钱。最后拆解 auto_suspend 与 auto_resume 这两个决定账单弹性成色的参数。
仓库到底"虚拟"在哪
上一章把仓库定位成"查询处理层的实例"。现在把这个词掰开:
- 虚拟:它不是一台固定的物理机,也不是一组长期绑定的节点。仓库被调度到云上任意空闲算力上,节点故障即时替换;"仓库"更像一个资源配额与计费标签,而非一件固定资产。
- 无状态:节点不持久保存数据、索引或事务日志。仓库挂起再唤醒,能力与之前完全等价;删掉重建也没有任何数据代价。
- 独立:每个仓库有独立的队列、独立的本地缓存、独立的计费计数。ETL 仓库跑批量转换不会让报表仓库多等一毫秒。
这三个属性合成一个结果:创建仓库是秒级、零风险、无数据迁移的操作。 你可以随时为一个新业务方开一个专属仓库,也可以为一次月末结算临时开一个特大号仓库,用完即删。
档位阶梯:翻倍的艺术
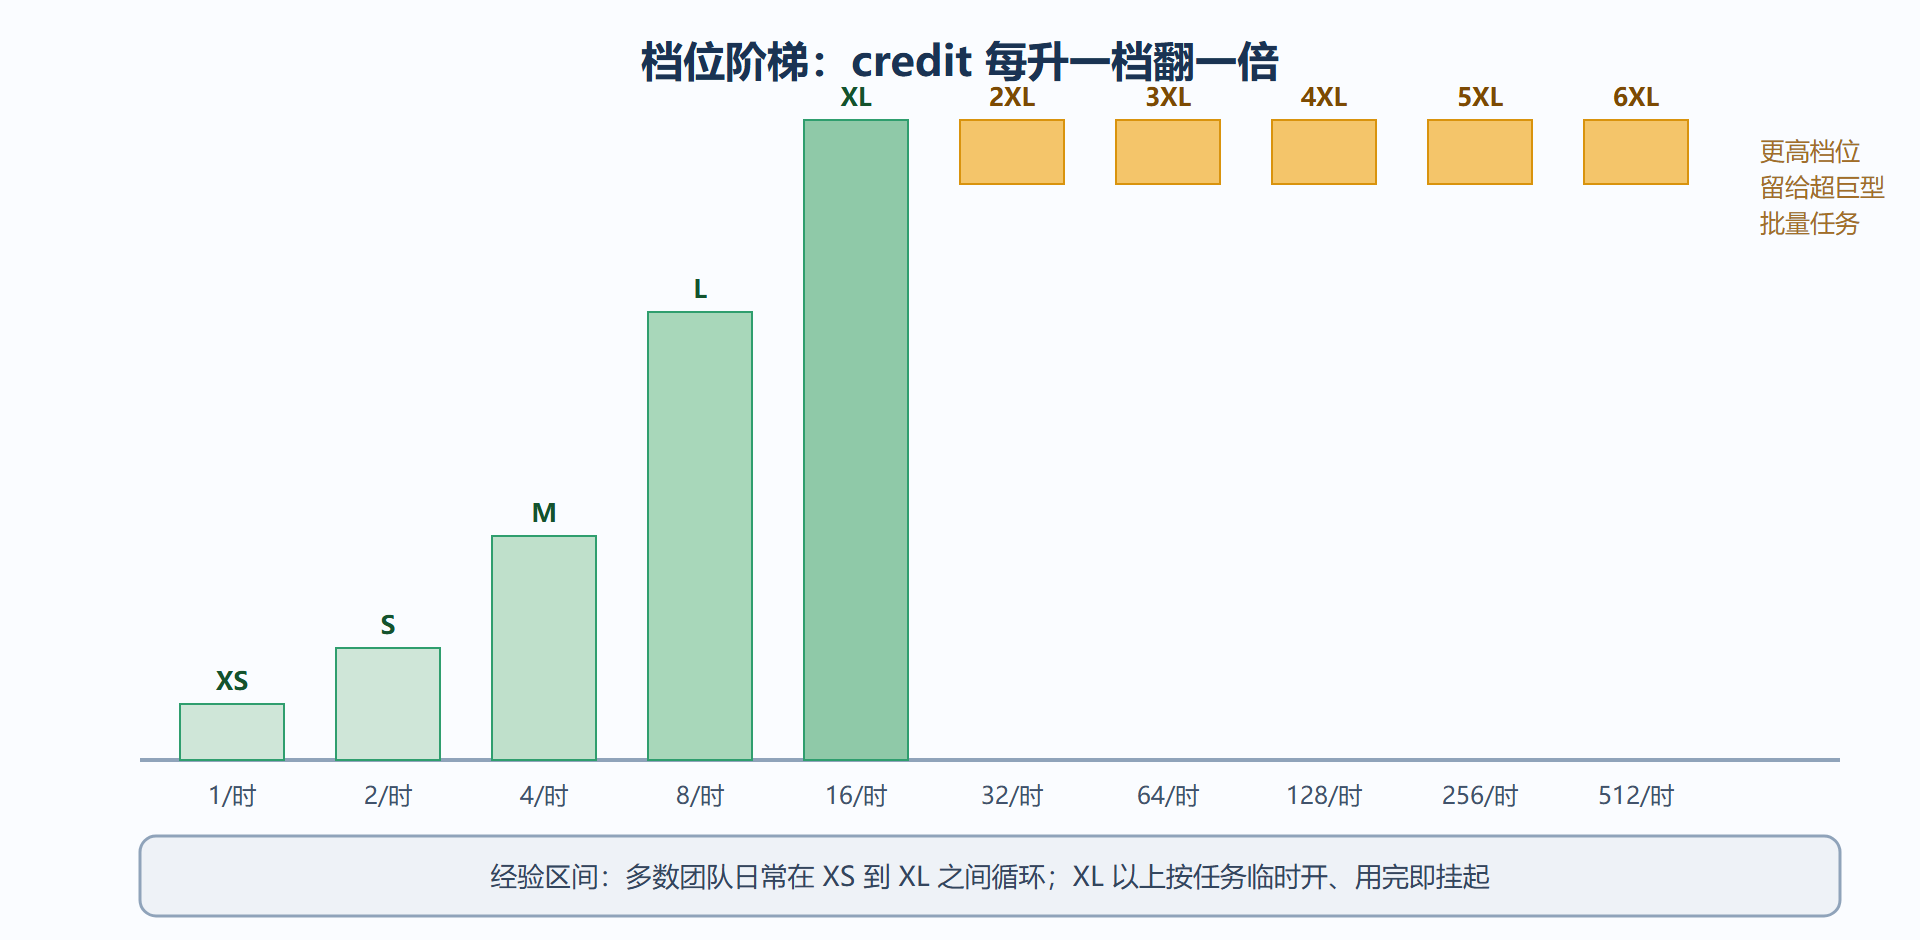
仓库档位用 T 恤尺码命名,规则简单到可以背下来:XS 为 1 credit/小时,每升一档翻一倍。完整阶梯如下:
| 档位 | credit/小时 | 典型用途 |
|---|---|---|
| X-Small | 1 | 轻量即席查询、开发测试 |
| Small | 2 | 常规 BI 报表 |
| Medium | 4 | 中型转换任务、较复杂查询 |
| Large | 8 | 大表聚合、批量 ELT |
| X-Large | 16 | 全量重算、大范围扫描 |
| 2X-Large | 32 | 超大表构建、月度重算 |
| 3X-Large | 64 | 数据湖级批量加载 |
| 4X-Large | 128 | 超大规模初始加载 |
| 5X-Large | 256 | 极端批量场景 |
| 6X-Large | 512 | 罕见的超巨型任务 |
credit 单价因云平台与区域而异(常见区间每 credit 约 2 到 3 美元量级),所以 XL 跑一小时大约是 XS 跑一小时费用的 16 倍。但注意关键洞察:升档提高的是并行度,单条查询的总扫描量不变。一小时的 XS 查询如果完美并行,理论上 3.75 分钟就能在 XL 上跑完(16 倍算力),总费用几乎一样。这就是"档位换时间"的本质——用同样的钱,买不同长度的墙钟时间。
图:虚拟仓库档位阶梯与弹性伸缩
动手:档位与计时的实证
空口说"翻倍"不如跑一把。下面的会话演示"同一查询、不同档位"的对照方法,以及自动挂起的计费表现:
-- 用 Small 档位跑一次全表聚合,记录耗时 ALTER WAREHOUSE demo_wh SET WAREHOUSE_SIZE = SMALL; SELECT /* 计时对照-S */ o.status, SUM(o.amount) FROM orders o GROUP BY o.status; -- 升到 Large 再跑同样查询(注意:先清结果缓存才能测出真实差异) ALTER SESSION SET USE_CACHED_RESULT = FALSE; ALTER WAREHOUSE demo_wh SET WAREHOUSE_SIZE = LARGE; SELECT /* 计时对照-L */ o.status, SUM(o.amount) FROM orders o GROUP BY o.status; -- 查看两条查询的实际耗时与扫描量 SELECT QUERY_TEXT, TOTAL_ELAPSED_TIME, PARTITIONS_SCANNED, PARTITIONS_TOTAL FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY WHERE QUERY_TEXT ILIKE '%计时对照%' ORDER BY START_TIME DESC;
预期结论分两种情况。如果表在 GB 量级:Large 与 Small 耗时接近(并行度给够了但活不够分),升档纯属浪费——这正是"小表用大仓库"的经典误区。如果表在 TB 量级且查询可并行:Large 耗时大约降到 Small 的四分之一附近,总 credit 消耗与 Small 相当甚至更低(省掉了排队与机器开销)。判断依据就在 PARTITIONS_SCANNED:扫描的微分区越多,升档收益越大。
自动挂起与自动恢复:账单的弹性成色
仓库的成本公式其实是"档位 × 运行时长",时长一半由业务决定,另一半由两个参数决定:
CREATE OR REPLACE WAREHOUSE bi_wh WAREHOUSE_SIZE = LARGE AUTO_SUSPEND = 60 -- 空闲 60 秒挂起:BI 常用值 AUTO_RESUME = TRUE -- 查询到达自动唤醒 STATEMENT_TIMEOUT_IN_SECONDS = 3600; -- 单查询超时上限 1 小时
- AUTO_SUSPEND:设太长(如 600 秒),一波查询结束后仓库空转十分钟,白烧钱;设太短(如 5 秒),两次查询的间隙稍微拉长就触发挂起-唤醒循环,唤醒需要几秒且缓存被清空,热缓存反复重建反而更慢。报表型负载 60 到 120 秒是常见平衡点;密集批量任务可以设 300 秒以上甚至不挂起。
- AUTO_RESUME:除纯批处理仓库外基本都应开启。挂起的仓库不会"漏接"查询——查询到达即触发唤醒,代价只是几秒冷启动。
💡 关键直觉:评估仓库配置时别只看"每小时多少钱",看"每天跑完所有活总共多少钱"。一个挂起 20 小时的 XL,账单可能远低于 24 小时不眠不休的 Small——弹性红利全部藏在"时长"里。
本节要点回顾
- 三个虚拟属性:无状态、独立、按需——仓库是资源标签,不是固定资产。
- 档位规则:XS 起步每小时 1 credit,逐档翻倍至 6XL 的 512;升档买的是并行度与时间。
- 升档判据:看分区扫描量与数据规模,小表升档只有成本没有收益。
- 两个时间参数:auto_suspend 决定闲时烧不烧钱,auto_resume 决定忙时接不接得住。
单仓库的纵向调节讲完了。可当几十条查询同时涌向同一个仓库呢?下一节把镜头拉到横向——多集群。
问题:credit 单价在哪里确认?不同区域差多少?
以平台公开价格表为准,按云平台与区域列出;同档位在不同区域与不同云上的单价有差异,做跨云比价或预算上报时必须查自己账户所在区域的数值。查询历史与账单里显示的是 credit 数量,金额换算由账户所在区域的价格决定——先看 credit 用量做优化判断,金额只做预算语言。