3.2 多集群并发与高可用
3.2 多集群并发与高可用
本节摘要:升档解决"单条查询慢",多集群(Multi-cluster Warehouse)解决"多条查询排队"。本节拆解多集群的工作方式:min/max 集群数、Standard 与 Economy 两种伸缩策略、队列与超时的关系;并把高可用一并讲清——无状态设计让单仓库天然免疫节点故障,跨区容灾则交给复制与故障转移组。读完后你应当能为"高并发 BI"和"月初批处理风暴"分别给出配置方案。
为什么升档救不了排队
先立体系坐标:3.1 末尾留下的问题是"几十条查询同时涌来"。升档(比如从 L 到 XL)确实让每条查询都跑得更快,单条查询占用的时长变短,间接提高吞吐——但吞吐上限仍受单集群并行度约束。当并发查询数量持续超过集群的并行槽位,后来的查询只能排队。排队的表现是:查询本身的执行很快,TOTAL_ELAPSED_TIME 却远大于 EXECUTION_TIME,多出来的全是队列等待。
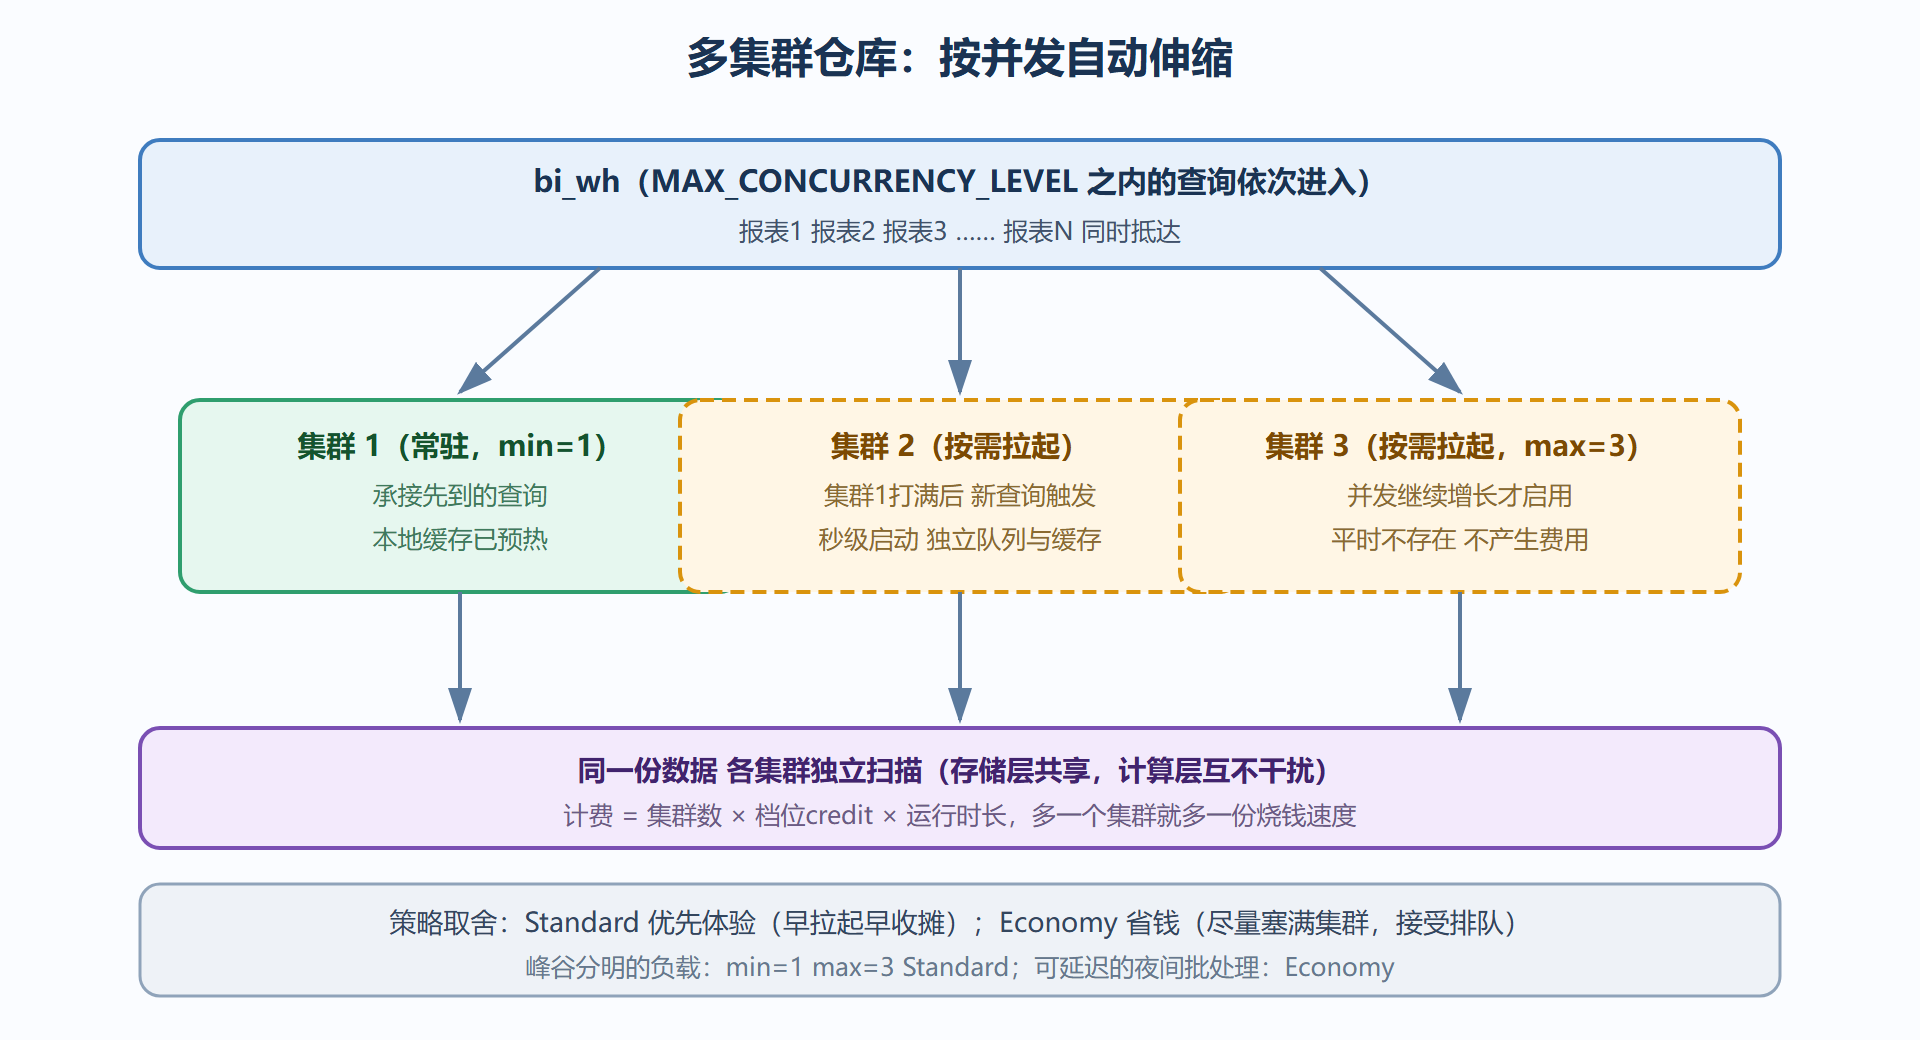
多集群仓库的解法直白粗暴:同一个仓库名下面挂多个同规格集群,并发超阈值时自动多起一个集群分担新来的查询。对用户完全透明——他们始终连同一个仓库名。
图:多集群仓库的并发分流
两个参数与两种策略
多集群仓库只有两根旋钮加一个策略开关,但组合出的行为差异很大:
-- 高并发 BI 场景:宁多花钱,不要排队 CREATE WAREHOUSE bi_wh WAREHOUSE_SIZE = LARGE MIN_CLUSTER_COUNT = 1 -- 平时 1 个集群 MAX_CLUSTER_COUNT = 3 -- 高峰最多扩到 3 个 SCALING_POLICY = STANDARD -- 倾向尽快拉起新集群,减少排队 AUTO_SUSPEND = 120; -- 可延迟的批处理场景:宁排队,不多花钱 CREATE WAREHOUSE batch_wh WAREHOUSE_SIZE = XLARGE MIN_CLUSTER_COUNT = 1 MAX_CLUSTER_COUNT = 2 SCALING_POLICY = ECONOMY; -- 集群打满才扩,扩了就尽量塞满
- MIN_CLUSTER_COUNT:常驻集群数。设 1 以上意味着仓库永不完全挂起(每个常驻集群持续计费)。除非 24 小时并发都很高,多数场景设 1。
- MAX_CLUSTER_COUNT 与 SCALING_POLICY:Standard 策略下,系统一发现并发偏高就提前拉起新集群,用户体验好、费用略高;Economy 策略下系统会尽量把查询塞进现有集群,实在满载才扩集群,省钱但响应延迟波动大。
一个实战组合口诀:白天型负载用 Standard,夜间型负载用 Economy;拿不准就先用 Standard 跑一周,从账单里看多集群扩容发生的时段,再决定要不要收窄。
治理排队:三个层次
多集群不是万能药,排队的治理应当分层考虑:
- 负载分仓(首选,零成本):把互相竞争的工作负载拆到不同仓库。ETL、BI、即席探索各用各的仓库,从源头消灭争抢——这是 Snowflake 与传统单实例数仓在运维哲学上的最大差异。
- 调并发参数:
MAX_CONCURRENCY_LEVEL控制单集群的并发槽位,默认 8;提高它对短小查询有效,但每个查询分到的资源变少,复杂查询反而变慢。 - 多集群兜底:前两层做完仍有高峰溢出,才轮到多集群。它解决的是"波峰那几天"的问题,用钱换平滑。
⚠️ 常见坑:用多集群掩盖负载分仓的缺失。有团队把 ETL 与 BI 挤在同一个多集群仓库里,高峰时自动扩到 5 个集群,账单翻了几倍——拆成两个仓库后,成本立刻回落。多集群是缓冲器,不是垃圾桶。
高可用与容灾:两层保障
虚拟仓库的高可用几乎"免费":节点无状态,坏一个补一个;单可用区基础设施故障,仓库整体迁到别的可用区重建,查询重新排队即可。真正需要规划的是区域级故障,方案是复制与故障转移组:
-- 把整个账户的关键对象复制到另一区域(跨区复制消耗数据传输费) CREATE FAILOVER GROUP prod_fg OBJECT_TYPES = DATABASES, WAREHOUSES ALLOWED_DATABASES = (core_dw) ALLOWED_ACCOUNTS = org_acct.backup_account REPLICATION_SCHEDULE = '10 MINUTE'; -- 主区域故障时,备用账户提升为主(分钟级 RTO) ALTER FAILOVER GROUP prod_fg PRIMARY;
要点有三:复制以秒级到分钟级的快照持续进行,RPO 取决于复制周期,对多数分析场景十分钟级可以接受;仓库本身无需复制数据,要复制的只是元数据与对象定义;跨区复制的数据传输按量计费,且只从主库流向备库。
💡 关键直觉:Snowflake 的高可用分两层——计算层的"自愈"不需要你做任何事,灾备层的"跨区"需要你主动配置故障转移组并定期演练切换。没演练过的容灾方案等于没有。
本节要点回顾
- 排队的本质:并发超过单集群并行槽位;
TOTAL_ELAPSED_TIME远大于执行时间是排队信号。 - 两根杠杆:档位调深度(单查询快),多集群调宽度(并发不排队),正交可组合。
- 两种策略:Standard 重体验,Economy 重成本;按负载时段选择。
- 高可用两层:节点级自愈是默认能力,区域级容灾要靠故障转移组与演练。
至此计算侧的弹性机制完整了。接下来四章转入数据本身:先看数据怎么进来、怎么落地、怎么穿越时间。
高可用演练清单
容灾方案的价值取决于演练频率,一份可直接落地的最小演练清单:
- 每季度核对故障转移组的复制延迟,确认 RPO 在业务可接受范围内;
- 每半年在备用区域做一次只读验证——用消费账户或克隆查询确认数据可用;
- 每年做一次完整切换演练并回切,把切换步骤写成台账,明确每个环节的负责人与预计时长;
- 演练后复核复制配额与传输费用,跨区流量的账目变化是复制健康度的间接信号。
未演练过的切换方案不是容灾,是愿望。这份清单的每一条都不难,难的是写进日历。