5.2 Streams与Tasks:流式与实时处理
5.2 Streams与Tasks:流式与实时处理
本节摘要:Snowflake 没有"流式引擎",却能用两个原语搭出准实时管线:Streams 以偏移量记录表自上次读取以来的增量(insert/update/delete 三类),Tasks 按计划或依赖关系定时执行 SQL。两者组合就是库内 CDC 加工管道,延迟分钟级,且与批处理共用同一套表、权限与计费体系。本节含一个从原始层到清洗层的完整可运行案例。
管线为什么要"自己会走"
承上:4.1 把数据装进了表,4.4 把 JSON 拉平成了建模层。但谁来定时执行这些加工?传统答案是外部调度器(crontab、工作流平台)远程驱动 SQL——调度逻辑在库外,失败重试、依赖管理、可观测性都要另建一套。Snowflake 的选择是把调度内化:Streams 负责"什么变了",Tasks 负责"什么时候做",两者都在库内、用 SQL 定义、被同一套 RBAC 管理。
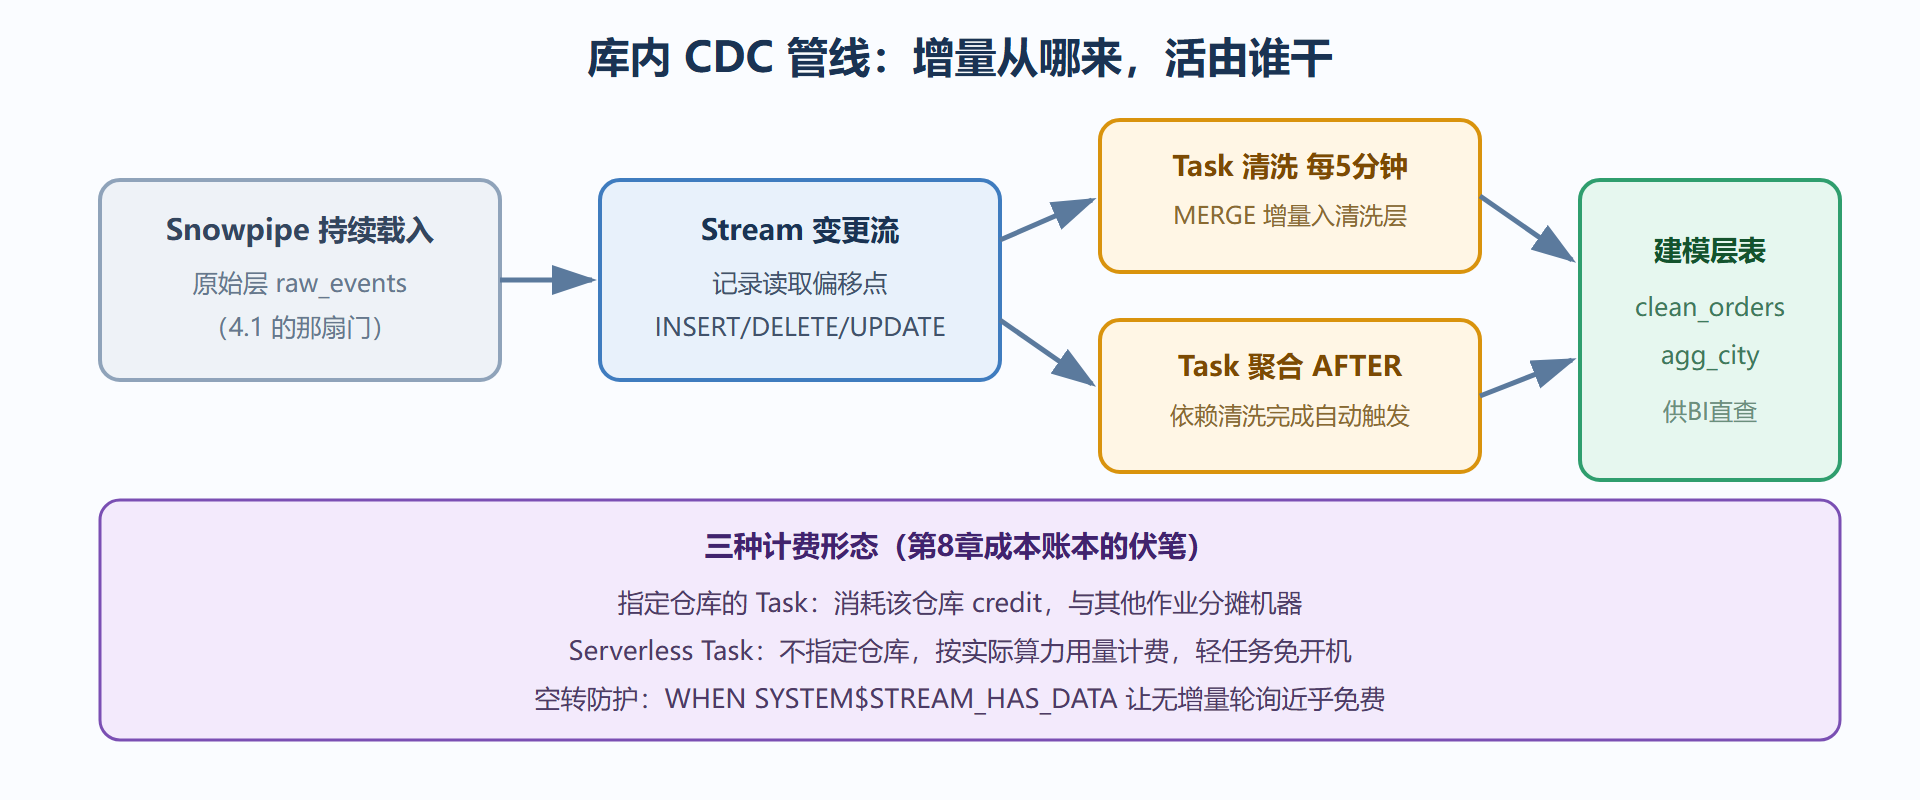
先看 Streams。一个 Stream 挂在源表上,记录一个"读取偏移点":每当有人消费这个 Stream,它返回偏移点以来的全部变更,并把偏移点前移。变更分三类,用 METADATA$ACTION 区分:
-- 在原始层表上建 Stream CREATE OR REPLACE STREAM raw_events_stream ON TABLE raw_events SHOW_INITIAL_ROWS = FALSE; -- 消费一次:看到建 Stream 之后的增量 SELECT METADATA$ACTION, METADATA$ISUPDATE, v:city::STRING AS city FROM raw_events_stream; -- METADATA$ACTION 取值 INSERT / DELETE / UPDATE -- UPDATE 会拆成一行 DELETE + 一行 INSERT,两行共享同一个查询ID便于配对
Stream 的本质利用了 4.2 讲过的微分区不可变性:表的每次变更都留下版本,Stream 只是记住了"我从哪个版本开始看"。所以它不占额外存储、不影响源表性能,未消费的增量会在 Time Travel 保留期到期后失效——Stream 的有效窗口受源表保留期约束,这是一个容易被忽略的耦合。
Tasks:给 SQL 上发条
Task 是"定时执行的 SQL",支持创建后手动恢复(默认挂起)、按 cron 或按间隔调度:
-- 每 5 分钟把原始层增量合并进清洗层 CREATE OR REPLACE TASK t_clean_events WAREHOUSE = etl_wh -- 用指定仓库执行(消耗该仓库 credit) SCHEDULE = '5 MINUTE' WHEN SYSTEM$STREAM_HAS_DATA('raw_events_stream') -- 没增量就不白跑 AS MERGE INTO clean_orders c USING ( SELECT v:order_id::STRING AS order_id, v:city::STRING AS city, v:order:amount::NUMBER(10,2) AS amount FROM raw_events_stream WHERE METADATA$ACTION = 'INSERT' ) s ON c.order_id = s.order_id WHEN MATCHED THEN UPDATE SET c.amount = s.amount WHEN NOT MATCHED THEN INSERT (order_id, city, amount) VALUES (s.order_id, s.city, s.amount); ALTER TASK t_clean_events RESUME; -- 建完记得恢复,否则永远不跑
三个工程要点:WHEN SYSTEM$STREAM_HAS_DATA(...) 让空转近乎零成本;MERGE INTO 是增量消费的标准姿势(幂等,重跑不重复);Task 建好后默认挂起,忘记 RESUME 是新手第一大坑。
Tasks 还能组成 DAG:用 AFTER 声明依赖,父任务完成自动触发子任务:
CREATE TASK t_aggregate_city WAREHOUSE = etl_wh AFTER t_clean_events -- 依赖:清洗完成后才跑聚合 AS INSERT INTO agg_city SELECT city, SUM(amount), CURRENT_DATE() FROM clean_orders GROUP BY city; SELECT SYSTEM$TASK_DEPENDENTS_ENABLE('t_clean_events'); -- 一键启用整条 DAG
图:Streams 与 Tasks 组成的加工管线
延迟的真相:分钟级,不是毫秒级
把预期校准一下:这套管线的端到端延迟 = Snowpipe 的约一分钟 + Task 的调度间隔。调低 Task 间隔(比如 1 分钟)可以逼近"近实时",但每次执行都有排队与启动开销,任务极碎反而拉高平均延迟与成本。它的甜点区是分钟级;秒级毫秒级的真流式场景请交给专门的流系统,Snowflake 负责承接流系统的输出。
运维清单
- Stream 失效:源表保留期缩短或 TRUNCATE 会截断 Stream 偏移量,消费前先查
SYSTEM$STREAM_HAS_DATA与 Stream 的 stale 状态; - Task 卡住:查
TASK_HISTORY视图,关注 SCHEDULED 与 COMPLETED 时间差——差值大说明在排队,仓库规格不够或并发挤兑; - DAG 断链:父任务失败默认跳过子任务,重跑要在父任务上补完成,或手动
EXECUTE TASK逐级触发; - 权限:Task 以"所有者权限"执行,跑不动多半是所有者角色缺目标表的写权限,与执行人无关。
💡 关键直觉:Streams/Tasks 的价值不在"高性能流处理",而在把管线的定义收进 SQL 与 RBAC 体系——调度、依赖、重试、审计都在库内,数据团队不再维护第二套库外调度系统的状态。
本节要点回顾
- 分工:Stream 记增量(偏移量模型),Task 定时机(cron/DAG);组合成库内 CDC。
- 姿势:消费增量用 MERGE 保幂等;WHEN 检查让空转免费;建完 RESUME。
- 窗口耦合:Stream 有效性受源表 Time Travel 保留期约束。
- 延迟定位:分钟级甜点区;毫秒级场景让位给真流系统。
SQL 表达不动加工逻辑时怎么办?下一节把 Python 搬进库内。