5.3 Snowpark与AI集成
5.3 Snowpark与AI集成
本节摘要:SQL 表达不了、或表达出来面目全非的加工逻辑(文本处理、调用模型、复杂统计),Snowpark 让它们以 Python/Java/Scala 的形态在数据库内部执行:DataFrame API 负责开发体验,UDF 与存储过程负责部署形态。本节讲清"代码下推到数据"与"数据拉到代码"的本质差异,给出 UDF 的完整示例与三类 AI 集成路径,并标注成本与依赖管理的边界。
当 SQL 撞墙
上一节的管线有一个隐含假设:加工逻辑能用 SQL 写出来。现实里有三堵墙——正则与分词之类的文本处理写 SQL 极其痛苦;统计与机器学习逻辑根本没有 SQL 表达式;调用外部模型的推理更无从谈起。传统解法是把数据拉出数据库,用 Spark 或本地 Python 处理完再写回去:数据出库两次网络传输、两套安全边界、两个需要运维的计算集群。
Snowpark 的思路相反:把代码推进数据所在的仓库执行。你在客户端写 Python,但 DataFrame 操作被翻译成 SQL 在服务端跑;真正的自定义逻辑编译成 UDF(用户自定义函数)或存储过程,随查询在仓库的计算节点上执行。数据不动,代码动。
DataFrame API:长得像 pandas,跑在仓库里
# 客户端代码:连接 Snowflake 后的 Snowpark 会话 from snowflake.snowpark import Session session = Session.builder.configs({...}).create() # 连接配置从密钥管理读取 orders = session.table("clean_orders") # 惰性执行:这几行只是构建执行计划,没有数据回到本地 result = ( orders.filter(orders["amount"] > 100) .group_by("city") .agg([(orders["amount"].sum(), "total")]) .sort("total", ascending=False) .limit(10) ) result.show() # 此刻才下发执行,返回的也只是这 10 行
这段代码的关键属性是惰性:filter/group_by/agg 都只是拼接逻辑计划,最终生成一条服务端 SQL 执行。只有 show、to_pandas 这类"要结果"的动作才触发计算。因此十亿行的表也不会撑爆你的笔记本——除非你把整表 to_pandas 拉下来,那是用法错误,不是框架缺陷。
UDF:自定义逻辑的部署形态
真正需要 Python 生态的逻辑(分词、调用第三方库、模型打分)写成 UDF:
from snowflake.snowpark.functions import udf from snowflake.snowpark.types import StringType, FloatType # 注册为 UDF:函数体被上传到库内,在仓库节点执行 @udf(name="risk_score", input_types=[FloatType(), FloatType()], return_type=FloatType(), is_permanent=True, stage_location="@my_models", # 依赖与函数体存放的内部暂存区 replace=True) def risk_score(amount: float, days_since_last: float) -> float: import math return round(1 / (1 + math.exp(-(amount / 500 - days_since_last / 30))), 4)
部署后它就是一个 SQL 函数,数据分析用原生语法调用:
SELECT order_id, RISK_SCORE(amount, days_since_last) AS score FROM clean_orders ORDER BY score DESC LIMIT 20;
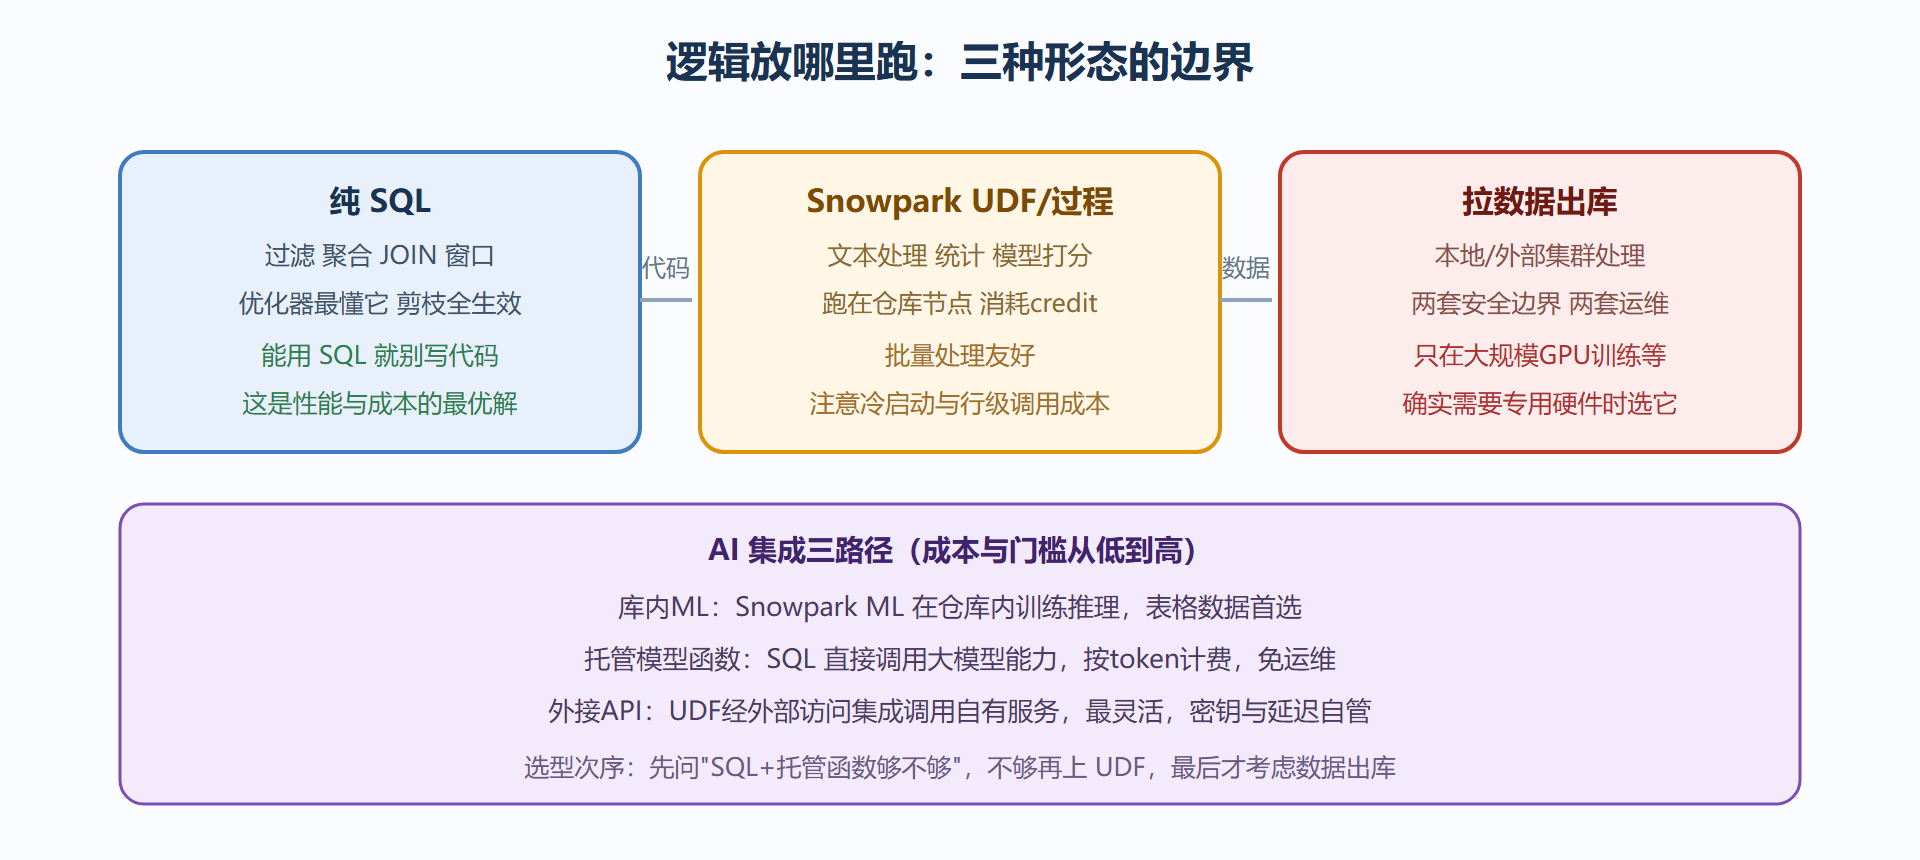
与"拉数据出库打分"相比,这条链路的收益在工程侧:没有数据落地出库(安全边界完整)、没有第二个集群要运维(跑在既定仓库上)、版本随函数统一管理。代价也要标清:UDF 在仓库节点执行会消耗 credit,且 Python 冷启动(导入依赖)有秒级开销——它适合批量打分,不适合每行毫秒级的在线服务调用。
AI 集成的三条路径
模型能力接入 Snowflake,目前有三条梯度不同的路:
- 库内机器学习:用 Snowpark 的 ML 库在库内完成训练与推理(数据不出库),适合表格类建模场景;配合 5.2 的 Tasks 定期重训。
- 托管大模型函数:平台提供的大模型函数(摘要、分类、情感、补全)直接以 SQL 调用,按 token 计费,无需自己管 GPU——把"非结构化文本变结构化字段"这类活的门槛降到了一个 SELECT。
- 外接模型服务:UDF 内通过外部访问集成(External Access)调用自建或第三方 API,灵活但要自己管密钥、延迟与配额。
-- 第2条路径的样子:把客服工单标题分类,一个 SELECT 完成 SELECT ticket_id, AI_CLASSIFY(title, ['退货', '物流', '账户', '其他']):category::STRING AS cat FROM support_tickets WHERE created_at >= CURRENT_DATE - 7;
图:三种计算形态的位置与边界
依赖与成本的边界
Snowpark 的 Python 运行环境内置了常用的科学计算包,第三方包通过 Anaconda 通道按名声明、由平台解析安装——不需要自建镜像仓库。受限也要标出来:不能装任意 pip 包(走审核通道)、单 UDF 运行有时长与内存上限、依赖解析在部署时完成而非运行时。
成本上记住一条主线:Snowpark 不改变计费模型,它只是让仓库里的 credit 消耗变得"更能干"。同样的转换,SQL 一条语句与 Python UDF 逐行调用,credit 差距可能有一个数量级——把逻辑能用 SQL 表达的部分留在 SQL,只在必要处下沉到 UDF,是 Snowpark 使用的第一戒律。第8章的资源监控就是给这条戒律兜底的闸门。
本节要点回顾
- 方向:代码下推到数据(Snowpark),优于数据拉到代码;DataFrame 惰性执行拼计划。
- 部署形态:UDF 是 SQL 可调用的函数,存储过程承载流程控制;跑在仓库节点、消耗 credit。
- AI 三路径:库内 ML、托管模型函数、外接 API;门槛与自由度递增。
- 第一戒律:能用 SQL 写的不用 UDF;UDF 注意冷启动与行级调用成本。
管线能力集齐了。最后一节换一个视角:别人的工具怎么接到这套架构上。