8.1 成本三构成:计算、存储、数据传输
8.1 成本三构成:计算、存储、数据传输
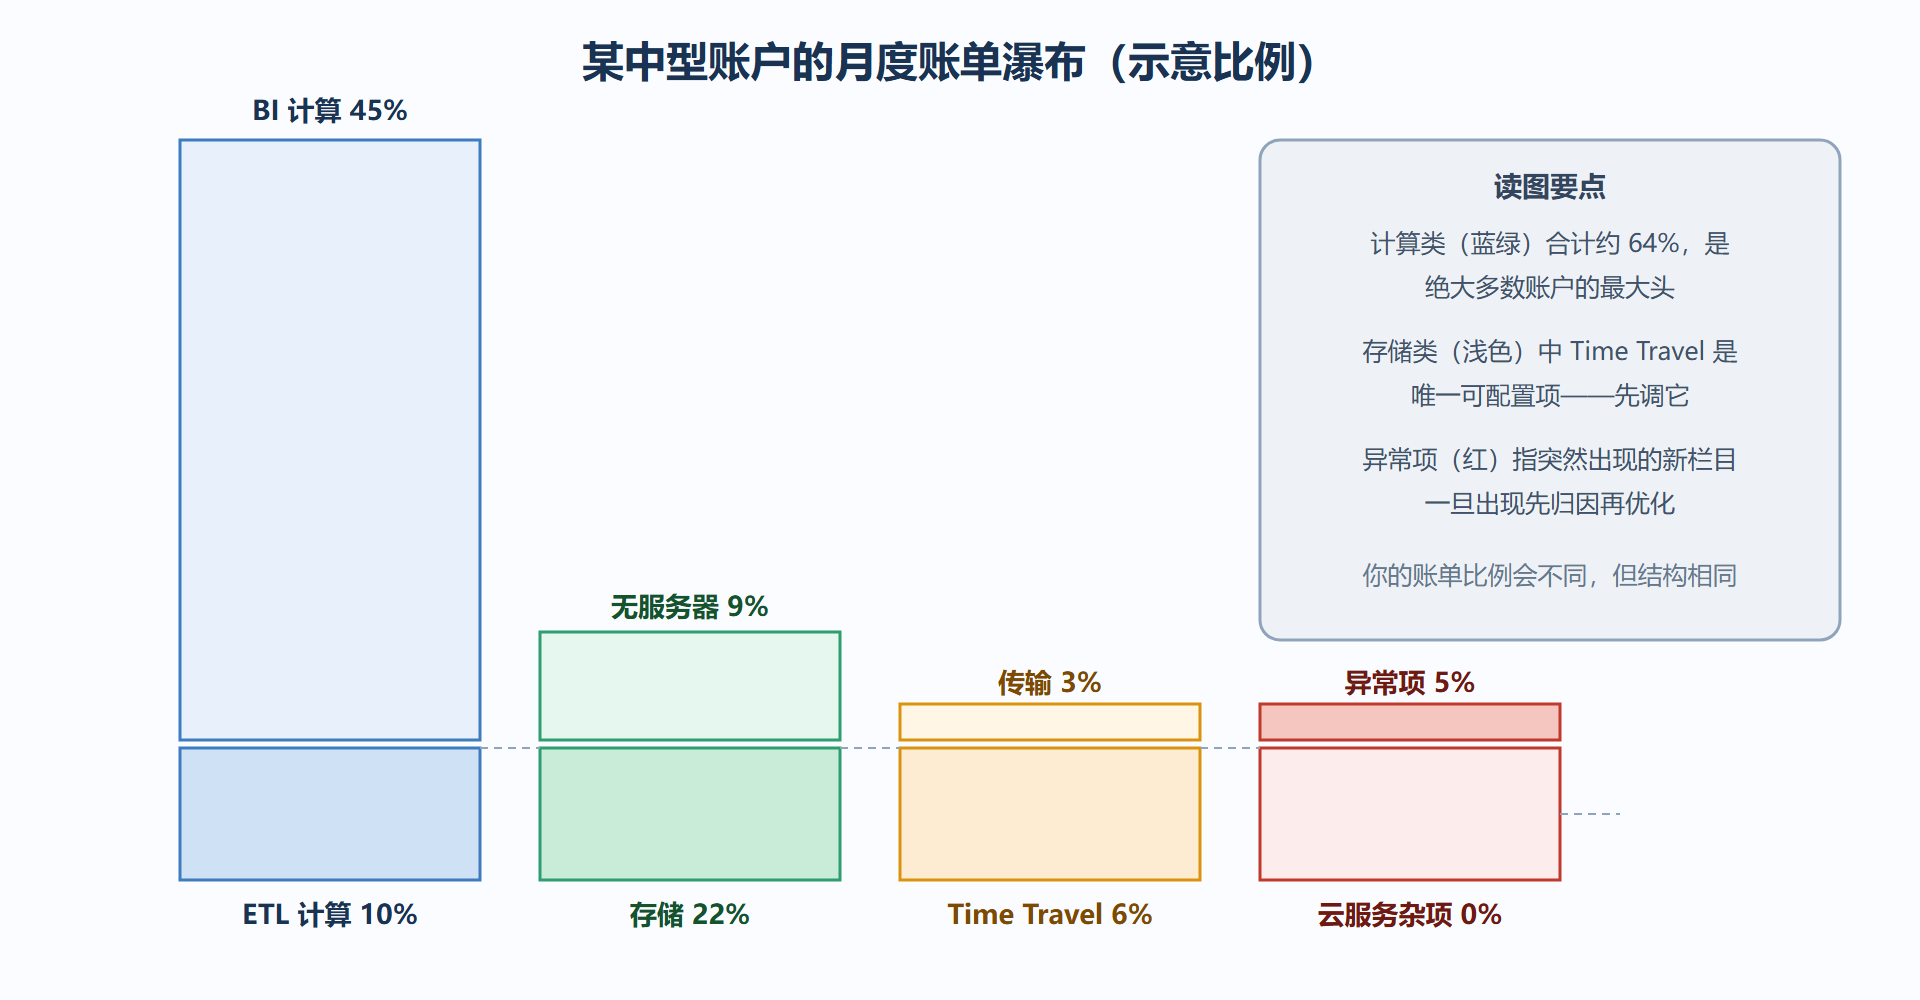
本节摘要:Snowflake 的账单无论多长,拆到头只有三本账:计算按 credit 计量(仓库按秒累计,无服务器功能单列),存储按压缩后的平均容量按月计,数据传输按跨区跨云的流量计。本节给出三本账的精确口径、对应的 ACCOUNT_USAGE 视图与各自最强的优化杠杆,并用一张瀑布图展示一个月度账单的典型构成。
三本账的口径
第一本:计算账(credit)。仓库运行时按"档位 credit/小时 × 实际运行秒数"累计,多数区域单价在每个 credit 约 2 到 3 美元量级(以官方价格表为准),计费粒度到秒、有最小计费时长。除你亲手开的仓库外,无服务器功能(自动聚类、物化视图维护、未绑仓库的 Task、Search Optimization 构建、Snowpipe)消耗平台算力,单独记在计算账的"无服务器"栏目下。
第二本:存储账(TB/月)。按压缩后的日平均容量计费,常见量级每月每 TB 约 23 到 40 美元(因云与区域、预付与按需而异)。注意两个含金量高的细节:一是计的是压缩后容量——源数据 10TB 压到 3TB 就只按 3TB 算,列存与压缩(4.2)直接变现;二是 Time Travel 保留期内的旧版本与 Fail-safe 期的数据都计入这张账,高频更新表的"存储费"里可能藏着大比例的历史版本。
第三本:数据传输账。同区内的绝大多数读写不单独收传输费;跨区、跨云的流量按 GB 计价,典型来源是 3.2 的跨区复制和跨云共享。
图:月度账单的典型构成瀑布
查账的 SQL:把账单拆到责任人
账单透明是平台的优势——三本账都有视图可查,能拆到仓库、拆到查询、拆到用户:
-- 计算账:按仓库看本月 credit 消耗(前 10 名) SELECT WAREHOUSE_NAME, SUM(CREDITS_USED) AS credits FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY WHERE START_TIME >= DATE_TRUNC('month', CURRENT_DATE) GROUP BY 1 ORDER BY 2 DESC LIMIT 10; -- 无服务器账:聚类、管道等后台消耗 SELECT SERVICE_TYPE, SUM(CREDITS_USED) AS credits FROM SNOWFLAKE.ACCOUNT_USAGE.USAGE_IN_CURRENCY_DAILY -- 或 SERVERLESS_TASK_HISTORY 等专项视图 WHERE USAGE_DATE >= DATE_TRUNC('month', CURRENT_DATE) GROUP BY 1 ORDER BY 2 DESC; -- 存储账:容量按构成拆分(活数据 / 时间旅行 / Fail-safe) SELECT STORAGE_USAGE_DATE, AVG( STORAGE_BYTES / POWER(1024,4)) AS active_tb, AVG( TIME_TRAVEL_BYTES / POWER(1024,4)) AS time_travel_tb, AVG( FAILSAFE_BYTES / POWER(1024,4)) AS failsafe_tb FROM SNOWFLAKE.ACCOUNT_USAGE.STORAGE_USAGE WHERE STORAGE_USAGE_DATE >= DATE_TRUNC('month', CURRENT_DATE) GROUP BY 1 ORDER BY 1 DESC LIMIT 30; -- 计算账再下钻:单条查询的 credit 归因(是谁、哪个仓库、烧了多少秒) SELECT q.QUERY_ID, q.USER_NAME, q.WAREHOUSE_NAME, q.TOTAL_ELAPSED_TIME / 1000 AS elapsed_sec, m.CREDITS_USED FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY q JOIN SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m ON q.WAREHOUSE_ID = m.WAREHOUSE_ID WHERE q.START_TIME >= DATE_TRUNC('month', CURRENT_DATE) ORDER BY q.TOTAL_ELAPSED_TIME DESC LIMIT 20;
STORAGE_USAGE 的三列拆分特别值得每周看一眼:FAILSAFE_BYTES 持续增长通常说明有表在被频繁删除重建;TIME_TRAVEL_BYTES 占比高就是 4.3 说的保留期一刀切问题在报信。
每本账的杠杆排序
三本账的优化杠杆各不相同,按"见效快、代价小"排序:
计算账:第一杠杆是 auto_suspend(白送的优化,3.1);第二是负载分仓(3.2,让 BI 与批处理互不拖长运行时间);第三是 SQL 与剪枝优化(6.2,缩短单查询时长);第四才是降档位(确认扫描量小之后才有意义)。
存储账:第一杠杆是按表调 Time Travel 保留期(4.3 的分档表);第二是清理"僵尸表"——用访问历史找出长期无人查询的表,归档或删除;第三是接受压缩红利而不是手工压缩——不要在入库前再做一遍 gzip,文件压缩与列存压缩叠加反而降低压缩率。
传输账:量小就忽略;量大的唯一正解是减少跨区跨云复制频率,或把消费方引到数据所在区域的共享。
💡 关键直觉:三本账里只有计算账是"行为驱动"的——存储涨数据、传输涨拓扑,而计算涨的是"谁在什么时候跑了什么"。所以成本文化的核心动作是让计算账可归因:每个仓库有主人,每条大查询能追到人。
本节要点回顾
- 三本账口径:credit 秒级(含无服务器栏目)、压缩后容量月费(含 Time Travel 与 Fail-safe)、跨区跨云流量。
- 查账三视图:WAREHOUSE_METERING_HISTORY、STORAGE_USAGE(三列拆分)、QUERY_HISTORY 归因。
- 杠杆排序:计算先挂起与分仓、存储先保留期与僵尸表、传输先降复制频率。
- 经验数字:credit 单价 2 到 3 美元量级、压缩率 3 到 4 倍、auto_suspend 常用 60 秒。
三本账的口径立住了。下一节进入实战:两个真实案例、一道熔断闸门,以及"账单为什么涨了"的归因流程。