8.2 成本优化实战与常见陷阱排错
8.2 成本优化实战与常见陷阱排错
本节摘要:本节把 8.1 的三本账变成临床工具:先配资源监控器这道熔断闸门,再走两个完整案例(BI 仓库账单翻倍归因、Time Travel 存储泄漏治理),最后给出一套"账单突然上涨"的四类归因流程与高频陷阱清单。所有案例都标注了用到的视图与参数,可以直接在你的账户里复演。
先装保险丝:资源监控器
优化是慢功夫,闸门是快保险。资源监控器(Resource Monitor)给账户或单个仓库设 credit 配额,触发点可以只是通知,也可以直接挂起:
-- 账户级月度预算:90% 通知、100% 挂起非关键负载 CREATE RESOURCE MONITOR rm_monthly WITH CREDIT_QUOTA = 2000 -- 月配额 2000 credit FREQUENCY = MONTHLY START_TIMESTAMP = IMMEDIATELY TRIGGERS ON 90 PERCENT DO NOTIFY -- 90%:邮件通知账户管理员 ON 100 PERCENT DO SUSPEND; -- 100%:挂起绑定的仓库(不杀正在跑的语句) ALTER WAREHOUSE batch_wh SET RESOURCE_MONITOR = rm_monthly; -- 绑定到仓库 ALTER ACCOUNT SET RESOURCE_MONITOR = rm_monthly; -- 也可绑定到账户级 -- 关键批次怕被误伤:给核心仓库单独配"只通知不挂起"的监控器 CREATE RESOURCE MONITOR rm_core WITH CREDIT_QUOTA = 800 FREQUENCY = MONTHLY START_TIMESTAMP = IMMEDIATELY TRIGGERS ON 80 PERCENT DO NOTIFY ON 100 PERCENT DO NOTIFY; ALTER WAREHOUSE core_wh SET RESOURCE_MONITOR = rm_core;
SUSPEND 与 SUSPEND_IMMEDIATE 的差别要分清:前者等当前语句跑完再挂起(温和,默认推荐),后者立即掐断(仅用于失控场景,正在跑的长查询直接失败)。另外注意监控器的配额只统计绑定它的仓库与无服务器功能,账户级绑定覆盖所有仓库——"监控器设了却没拦住"多半是只绑了某个仓库,漏网的仓库在别处烧。
案例一:BI 仓库账单翻倍
背景:某团队月度 credit 消耗从 900 涨到 1900,涨幅集中在报表仓库(L 档位,auto_suspend 600 秒)。归因过程分三步,每步一条 SQL:
-- 第一步:按天看消耗曲线,确认是缓涨还是跳涨 SELECT DATE_TRUNC('day', START_TIME) AS d, SUM(CREDITS_USED) FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY WHERE WAREHOUSE_NAME = 'BI_WH' AND START_TIME >= CURRENT_DATE - 45 GROUP BY 1 ORDER BY 1; -- 第二步:按查询文本聚合,找时长大户 SELECT LEFT(QUERY_TEXT, 80) AS q, COUNT(*) AS runs, SUM(TOTAL_ELAPSED_TIME) / 1000 / 3600 AS total_hours FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY WHERE WAREHOUSE_NAME = 'BI_WH' AND START_TIME >= CURRENT_DATE - 14 GROUP BY 1 ORDER BY 3 DESC LIMIT 10; -- 第三步:看这些查询的扫描量与缓存命中率 SELECT QUERY_ID, PARTITIONS_SCANNED, PARTITIONS_TOTAL, PERCENTAGE_SCANNED_FROM_CACHE FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY WHERE QUERY_TEXT ILIKE '%仪表盘主查询%' AND START_TIME >= CURRENT_DATE - 14;
结果与解读:第二步揪出一个上游工具的"健康检查"查询——每 60 秒执行一次 SELECT COUNT(*) 全表扫描。因为文本恒定本应命中结果缓存,但底表正被高频加载(缓存条件之二"数据未变"不成立),于是每分钟都真扫一遍。L 档位仓库因此全天不眠。处置:健康检查改查轻量的元数据计数、报表仓库 auto_suspend 收紧到 120 秒、加载作业挪到独立仓库。次月账单回到 980。教训:涨幅往往不是"业务变多了",而是某个不起眼的调用模式变了——归因到查询文本,比对着账单发愁有用得多。
案例二:Time Travel 存储泄漏
背景:存储账单三个月连涨,但"活数据"总量没变。归因直接用 8.1 的 STORAGE_USAGE 三列拆分:FAILSAFE_BYTES 占比从 3% 涨到 28%。Fail-safe 增长的典型来源是高频删除重建——继续追查发现某团队的数据回填作业用"先 DROP 再 CREATE 全量重灌"的方式每天刷新一张大表:每次重建都把旧表的全部数据推入 Fail-safe 七天,账单上等于同时养着三到四份全量副本。处置:回填逻辑改为 INSERT OVERWRITE(不删表、直接覆盖写入),保留期维持 1 天;存量等 7 天 Fail-safe 自然排空。次周存储曲线掉头向下。教训:DROP+CREATE 是 Fail-safe 的头号制造机;凡是"定期全量刷新"的需求,优先找覆盖写、SWAP 或克隆方案。
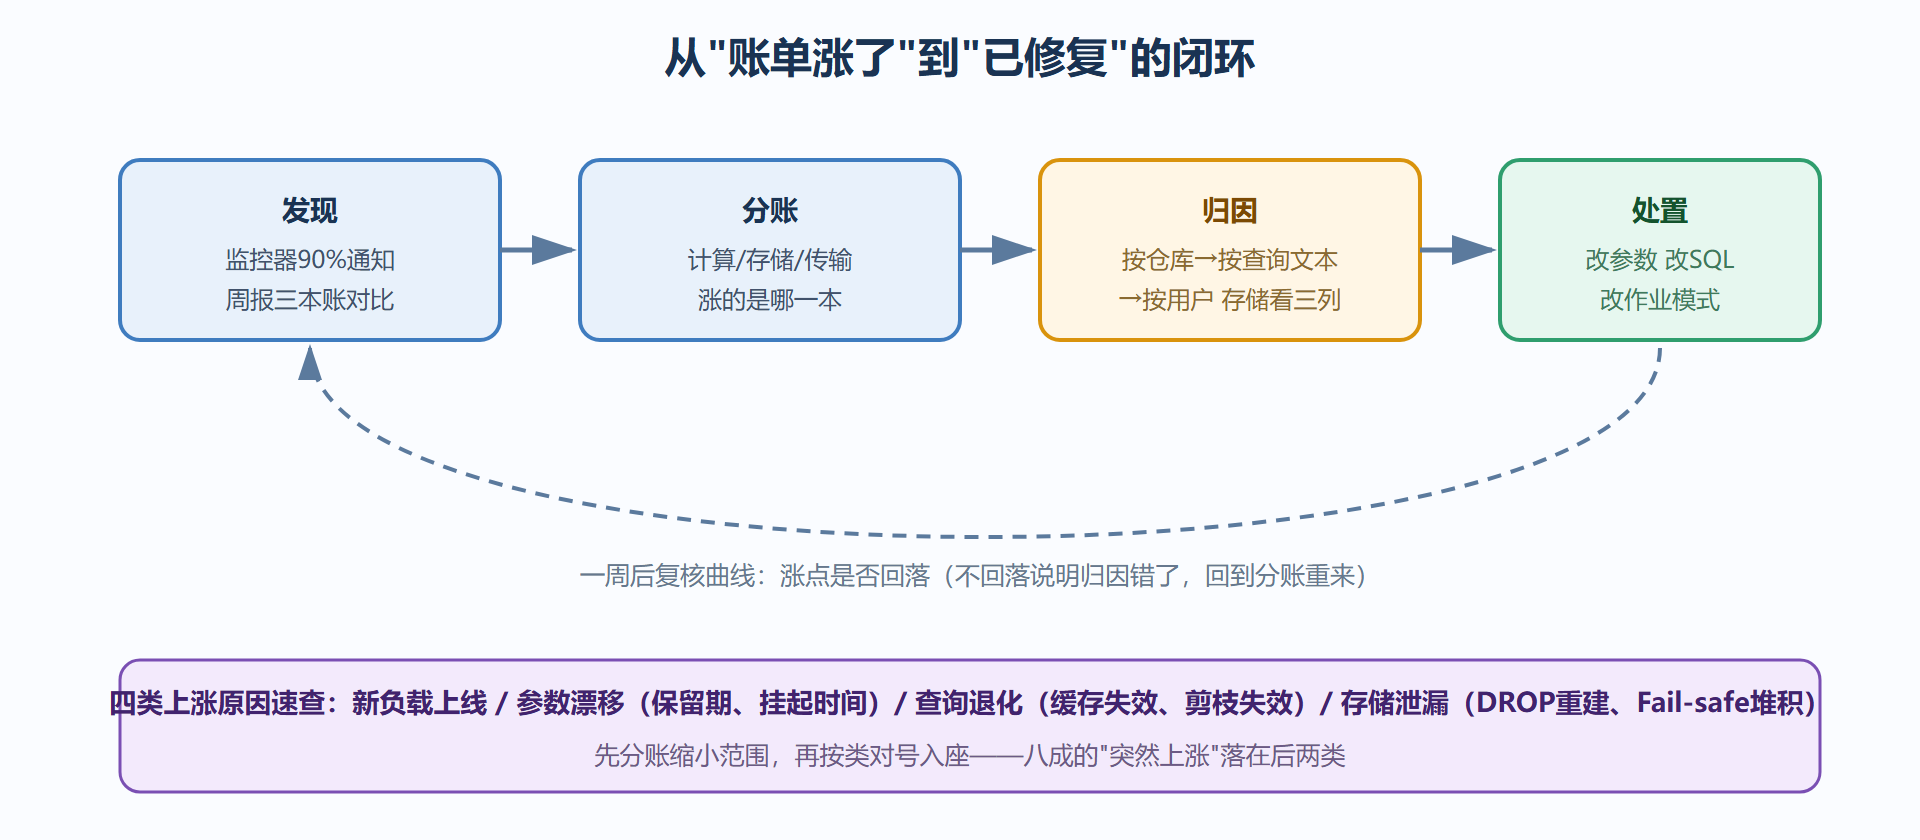
图:成本监控与归因闭环
高频陷阱清单
以下每一条都在真实账户里反复出现,按"犯过的人数"排序:
- SELECT * 惯性。列存架构下多读一列就多读一片数据;BI 工具里"顺手全选"的代价是真金白银。镜像查询只选需要的列。
- 小表大仓库。GB 级表跑 XL 仓库,扫描时间不变、credit 快 16 倍(3.1 的升档判据没过)。
- 结果缓存被模式破坏。拼字符串生成的 SQL 文本每次不同,缓存永远打不中(6.1 的四条件)。
- 自动聚类上瘾。给几十张表全上聚簇键,后台聚类 credit 悄悄爬到账单前三——聚簇只给"表大、剪枝失效、查询频繁"的少数表(6.2 的三条件)。
- 测试仓库不挂起。开发联调的仓库忘了 auto_suspend,周末两天烧掉一个月配额。
- 把 Fail-safe 当备份。4.3 说过了,再说一遍:Fail-safe 不可自助、按天计费、只有 7 天——它不是备份,是保险。
- 一个账户一个角色跑所有作业。7.1 的角色设计缺失让成本无法归因,也是安全审计的红旗。
从省钱到架构演进
把视角再拉高一层:成本优化做深之后,会自然走向架构选择。同一条管线,COPY INTO 与 Snowpipe 的分界是"延迟与计费模型"的权衡(4.1);聚合表物化与否,是"存储换计算"的权衡;跨区共享与复制的拓扑,是"传输账与体验"的权衡。没有一劳永逸的便宜,只有算得清的取舍——这也是全册用"概念筑基"的顺序走到这里想留下的习惯:先懂机制,再谈参数;先看账本,再动手优化。
至于平台本身的演进(更细粒度的无服务器化、AI 能力的原生内嵌、开放表格式的互操作),判断标准始终没变:新形态改变的只是三本账的记法,账还是那三本。 用三本账的框架去看任何新功能,一眼就能看出它省的是哪本账、花的是哪本账。
💡 关键直觉:成本治理的最高形态不是"找到最大的那笔浪费",而是让每个使用数据的人都看得见自己行为的价格。监控器管住失控,归因流程管住异常,透明化管住日常——三件事都齐了,账单才会进入平稳期。
本节要点回顾
- 先装闸门:资源监控器双层配置——普通负载挂起、核心负载只通知;SUSPEND 与 IMMEDIATE 分清。
- 归因三板斧:按天看曲线、按查询文本聚合、看扫描与缓存指标;存储直接看三列拆分。
- 两大案例病灶:隐性高频调用拖长仓库运行时长;DROP+CREATE 制造 Fail-safe 堆积。
- 四类上涨:新负载、参数漂移、查询退化、存储泄漏——先分账,再对号。
全册到此收束:从存算分离的第一性原理出发,途经仓库、存储、共享、性能、安全,最终落回三本账。概念的地基打牢之后,剩下的都是在这套框架里继续添砖。