8.1 性能优化技巧:基准数据与反模式对照
8.1 性能优化技巧:基准数据与反模式对照
本节摘要:js-framework-benchmark 把框架开销拆成创建、局部更新、替换、交换、删除等操作桶,量出各框架相对原生 JavaScript 的倍率。本节给出读法:Solid 整体落在 1.1 前后的第一梯队,React hooks 版本多在 1.4 到 1.6 区间,差距集中在"界面大、变化小"的桶。之后是两套优化哲学的对照与一张反模式清单。
弱设备上的发布会暴露一切。一台三年前的安卓机,打开一个 React 管理后台,列表翻页能感到迟滞;同样的界面换成 Solid 之后,迟滞消失——这类实测 anecdote 在迁移团队里流传很广,但要把"为什么"讲清,还是得回到基准数据。传闻给方向,数字给证据,本节两者都给。
基准怎么读:分桶比总分有用
js-framework-benchmark 的呈现方式是"各操作相对原生 JavaScript 的耗时倍率",几何均值只是汇总。读它要按桶读,因为差距分布极不均匀:创建一千行、局部更新每行、整表替换、行交换、行删除、清空——每个桶考察的机制不同。量级参照(多轮中位的常见区间):Solid 全桶落在 1.1 上下,个别桶与原生几乎重合;React hooks 版本整体 1.4 到 1.6,其中"局部更新"与"部分替换"两桶通常是最慢的,个别轮次能到更高。启动维度(脚本解析与首交互)与内存维度,Solid 同样占优。
图:分桶倍率对照——差距藏在哪几桶
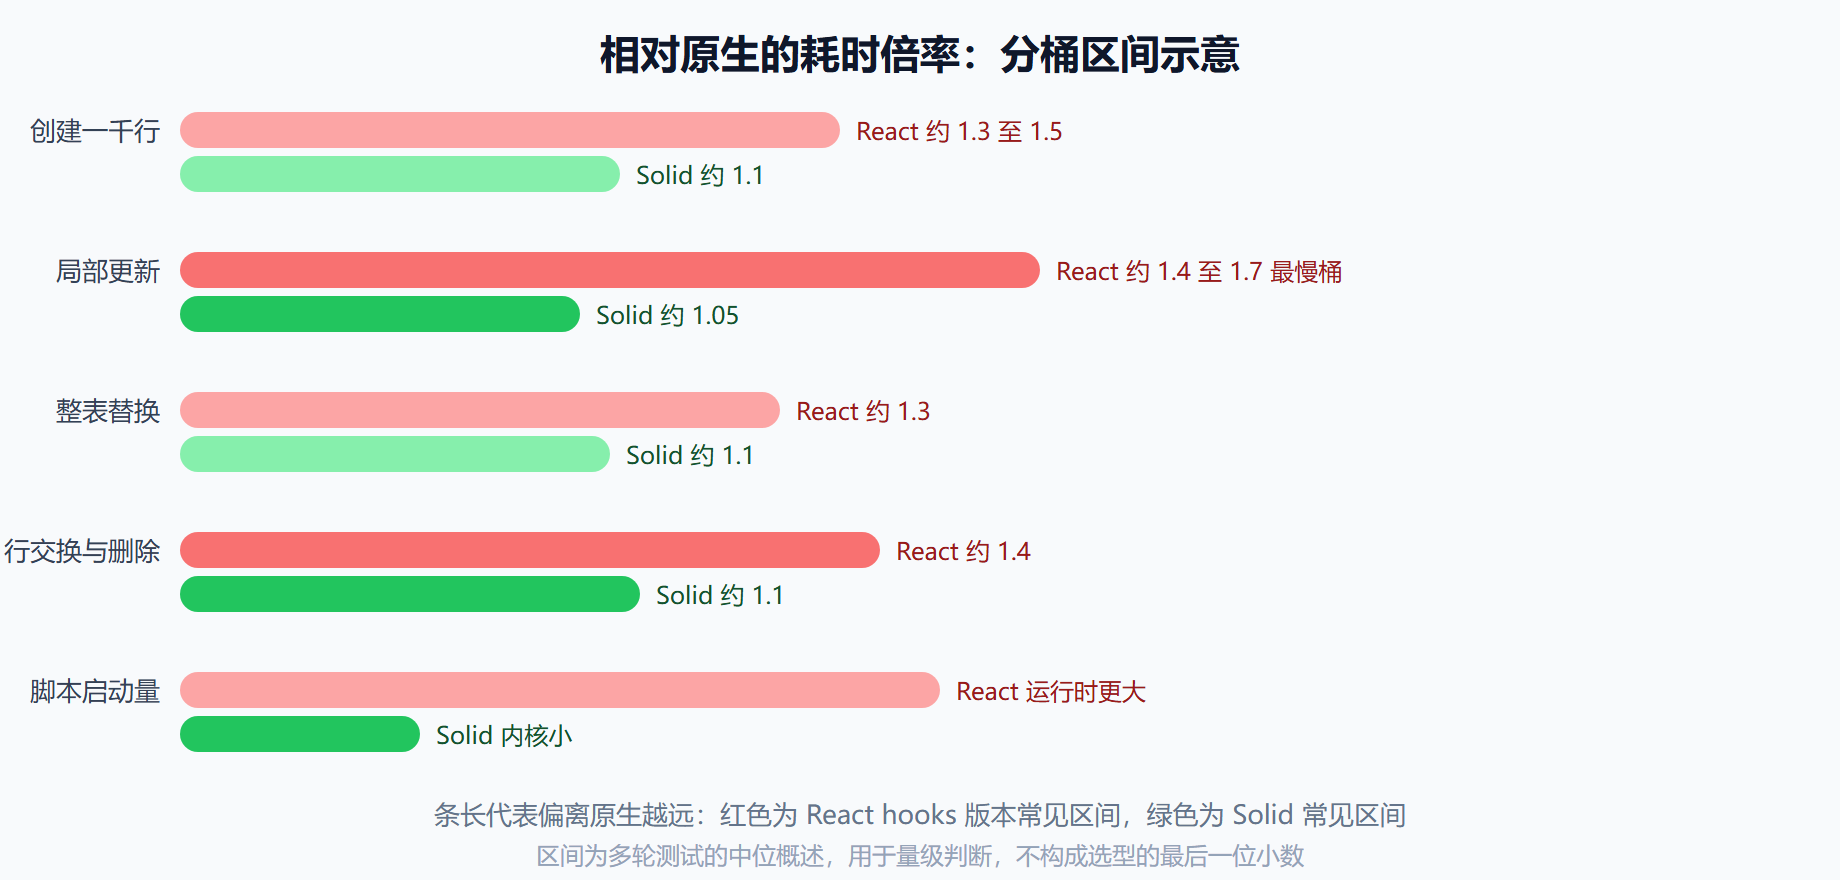
分桶读法的应用价值在"对号入座":你的应用里最高频的操作是哪一桶,那一桶的差距就是迁移收益的上限。天天局部更新的实时表格,收益最大;创建后只读的内容站,差距感知有限——首屏指标反而要看脚本体积与渲染策略(第 6 章)。
两套优化哲学
React 的优化动作全部围绕"减少不必要的重渲染":memo 挡住子树、useMemo 缓存计算、useCallback 稳住引用、状态下移或上移缩小重渲染范围。这套哲学的前提是"重渲染是常态",优化是给常态踩刹车。
Solid 里重渲染不存在,优化哲学换成"依赖图修枝":让每个绑定的依赖面尽可能窄、每个计算尽可能便宜。落到手法上就四条:
// 手法一:计算重时用 Memo 挡住重复求值 const sorted = createMemo(() => [...rows()].sort((a, b) => b.score - a.score) // 大数组排序,Memo 保证只在数据变时算 ); // 手法二:绑定表达式保持便宜,重活下沉到 Memo // 反例:<span>{rows().filter(x => x.hot).length}</span> 每次行变化都全表过滤 // 手法三:高频事件写入用 batch 合并冲刷 onPointerMove(e => batch(() => { setX(e.clientX); setY(e.clientY); })); // 手法四:长列表交给 For 与社区虚拟列表方案,可视区外不渲染 // <VirtualList each={rows()}>{row => <RowItem row={row} />}</VirtualList>
对照表把两套哲学的动作并排放好:
| 目标 | React 手段 | Solid 手段 |
|---|---|---|
| 避免无关更新 | memo、状态位置调整 | 天然满足,无对应需求 |
| 重计算缓存 | useMemo | createMemo |
| 引用稳定 | useCallback | 不需要 |
| 高频更新合并 | 自动批处理加 flushSync | batch |
| 长列表 | react-window 等库 | For 加社区虚拟列表 |
| 按需加载 | lazy 加 Suspense | 同名原语,用法一致 |
反模式清单
Solid 侧自己的反模式,按出现频率排:
- 绑定表达式里写重逻辑:过滤、排序、格式化直接内联在 JSX。修法:下沉 createMemo。
- store 对象展开或深解构:断开路径订阅,更新静默失效(还常伴随"咦怎么不刷新"的假性能问题)。修法:保持路径访问。
- 全局 Effect 撒网:在根作用域建读取宽泛的 Effect,任何风吹草动都执行。修法:收窄依赖或用 on 指定来源。
- 巨型 store 单仓:把整个应用状态塞一个 store,依赖图失去结构,等于把 React 的全局重渲染换成全局重算。修法:按业务域拆仓。
- 信号粒度过粗:一个信号包整个表单对象,改一个字段全体重算。修法:按变化时机拆(2.1 的粒度法则)。
⚠️ 性能排查的最后一步永远是怀疑"与框架无关":网络瀑布、未压缩图片、强制同步排版,这些问题的占比常年高于框架开销。先看性能面板的时间都花在哪,再决定要不要动代码。
一次真实体检:从症状到修复的全过程
把方法论落到一次完整体检。症状:客服后台的订单列表页,筛选条件变化后界面明显卡顿,低端机上可感知地掉帧。
第一步,面板定位:录制约五秒的操作,发现长任务集中在脚本段,单段几百毫秒;进一步看函数级耗时,大头是排序与过滤的重复执行。第二步,代码归因:排序逻辑写在 JSX 绑定表达式里——{rows().slice().sort(...).map(...)}——按 8.1 的反模式清单第一条对号入座:任何一行数据的任何字段变化,都会触发整表排序重算。
第三步,修复:
// 修复前:表达式内联重活,依赖面宽到整表 <tbody>{rows().slice().sort(cmp).map(r => <Row row={r} />)}</tbody> // 修复后:排序下沉 Memo,且依赖收窄到排序键 const sorted = createMemo(() => { const key = sortKey(), dir = sortDir(); return [...rows()].sort((a, b) => dir * (a[key] > b[key] ? 1 : -1)); }); <tbody><For each={sorted()}>{r => <Row row={r} />}</For></tbody>
第四步,复测:同样五秒操作,长任务从多段几百毫秒降到多段个位数毫秒,低端机掉帧消失。第五步,归档:把"绑定表达式内禁排序过滤"写进 8.2 的评审清单,让修复沉淀为规范。整个体检五步——症状、定位、归因、修复、归档——值得作为团队性能问题的标准作业程序。
本节要点回顾
- 按桶读基准:高频操作所在桶的倍率差距,才是你的应用能吃到的收益。
- 修枝哲学取代刹车哲学:缩窄依赖面、压低单次计算成本是 Solid 优化的主线。
- 五条反模式:重逻辑内联、store 展开、Effect 撒网、单仓巨型 store、粒度过粗。
- 先量再改:性能面板定位在前,代码手术在后。
下一节把正确写法固化成团队规范——一份可以直接进评审模板的差异清单。