1.2 五层内核对照
1.2 五层内核对照
本节摘要:SQLite 把内核切成五层:接口层、编译层、虚拟机、B-Tree、页缓存与操作系统抽象。本节自顶向下走一遍这五层,并回答一个对比性问题:MySQL 与 PostgreSQL 在每一层的对应物是什么,哪些层 SQLite 特意做薄了,做薄的收益与代价各是什么。
自顶向下走一遍五层
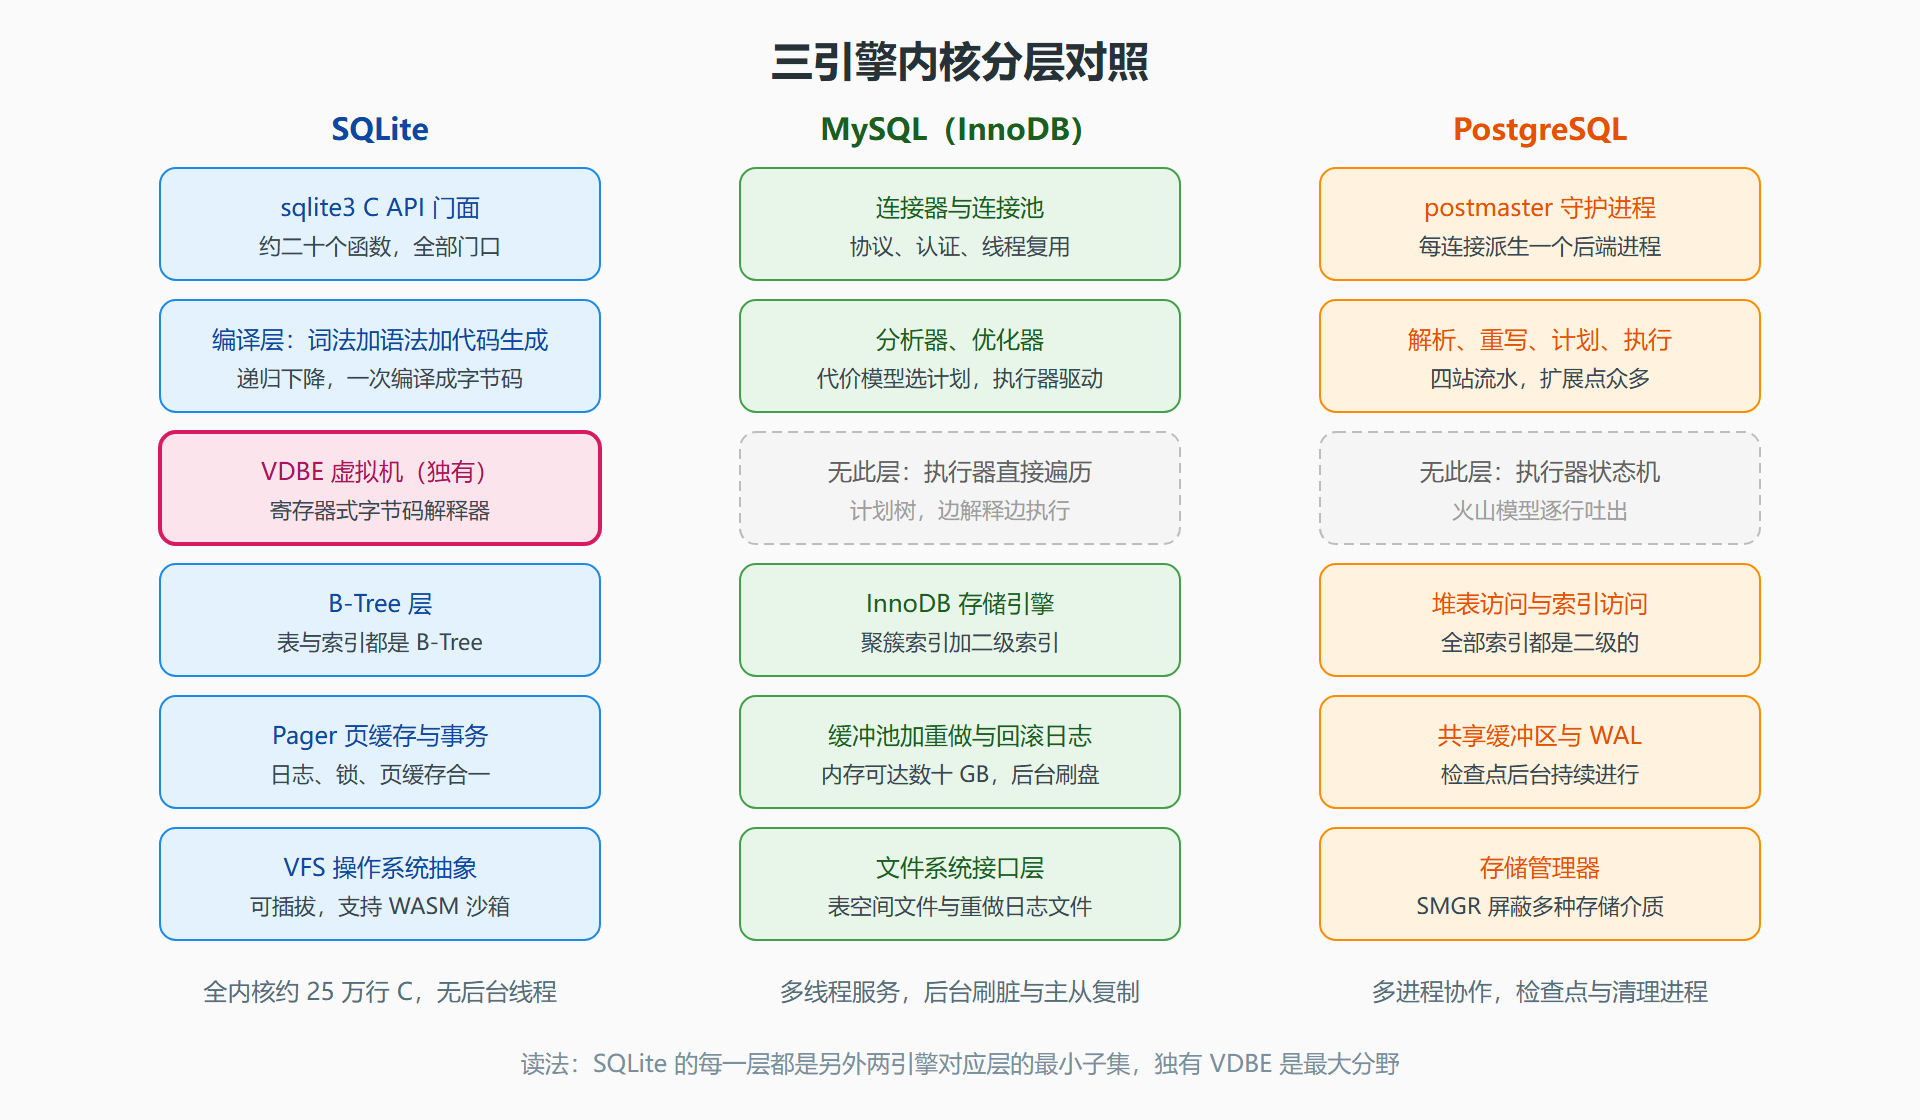
SQLite 官方架构图自上而下是五块,用一句话概括每块在做什么:
- 接口层(Core 之上的 sqlite3 API):二十来个 C 函数——打开、准备、绑定、步进、重置、关闭。它是整个引擎的全部"门面",没有第二扇门。
- 编译层(Tokenizer、Parser、Code Generator):把 SQL 文本切成词元,递归下降解析出语法树,再遍历语法树生成虚拟机字节码。MySQL 的对应物是分析器加优化器,PostgreSQL 的对应物是解析分析、重写、计划三站。
- 虚拟机(VDBE,Very Fast Database Engine):一个寄存器式字节码解释器,SQLite 的一切执行都发生在它的指令循环里。这是 SQLite 最独特的层:MySQL 与 PostgreSQL 直接遍历计划树执行,没有"先把查询编译成完整指令序列"这一步。
- B-Tree 层:把表和索引组织成按页寻址的 B-Tree。三个引擎在这层惊人地相似——都靠 B+ 树变体组织数据——相似之下又各有立场,第 2 章专门展开。
- 页缓存与操作系统接口(Pager、VFS):页缓存负责事务、日志、锁与内存中的页;VFS 是操作系统接口的抽象,让同一份内核跑在 Windows、POSIX 嵌入式系统甚至 WASM 沙箱里。MySQL 的对应物是 InnoDB 的缓冲池加文件系统接口,PostgreSQL 的对应物是共享缓冲区加存储管理器。
把三层引擎的分层画在一张图上,SQLite 的"薄"一目了然:
图:三引擎内核分层对照矩阵
薄是一种武器,也有代价
SQLite 的接口层薄到什么程度?下面这段 C 代码执行一条查询,只用了五个调用——这就是接口层的全部习惯用法:
sqlite3 *db; sqlite3_stmt *stmt; sqlite3_open("app.db", &db); /* 打开或创建:得到句柄 */ sqlite3_prepare_v2(db, "SELECT name FROM users WHERE id=?1", -1, &stmt, 0); sqlite3_bind_int(stmt, 1, 42); /* 绑定参数,杜绝拼接注入 */ while (sqlite3_step(stmt) == SQLITE_ROW) { /* 步进:每行调一次 */ printf("%s\n", sqlite3_column_text(stmt, 0)); } sqlite3_finalize(stmt); /* 释放编译产物 */ sqlite3_close(db);
同样的活儿,MySQL 里要先建立 TCP 连接、走一遍握手与认证,再发送查询文本、按协议分帧读结果;PostgreSQL 则先 fork 出一个后端进程(连接建立成本更高,单查询反而要靠连接池摊薄)。SQLite 里"连接"只是一个结构体指针,开和关的代价接近于零——这直接改写了应用层的连接管理策略:进程内引擎不需要连接池,每个线程开自己的连接句柄反而是官方推荐姿势。
薄的代价同样清楚。第一,没有常驻服务进程,就没人替你做后台刷脏、统计收集、死锁检测——SQLite 把这些职责都推给了调用时机(检查点发生在写事务里、统计信息靠你手动 ANALYZE)。第二,引擎与应用共享进程命运,应用内存泄漏会拖垮数据库,数据库的缓存配置要和应用抢堆空间。第三,没有网络层,也就天然没有远程访问、没有集中审计——安全模型完全建立在文件权限之上。
对照实验:观察五层的存在感
在 sqlite3 命令行里跑两句自省命令,能直接感受到分层信息是被完整暴露的:
-- 编译层与虚拟机层:显示这条 SQL 被编译成了什么 EXPLAIN SELECT name FROM users WHERE id = 42; -- 存储层信息:每张表的根页号,B-Tree 层的入口 SELECT name, rootpage FROM sqlite_schema ORDER BY rootpage;
第二条查询输出的 rootpage 列值得圈出来:每张表、每个索引都对应一个 B-Tree 根页号,这就是编译层与 B-Tree 层的接缝。MySQL 里对应的概念是 InnoDB 数据字典里的表空间页号,但普通用户很难直接查到;SQLite 把它做成了人人可查的系统表——这是嵌入式数据库"一切可见"哲学的典型体现。
常见问题速答
**SQLite 支持可插拔存储引擎吗?**不支持。MySQL 的插件式引擎(InnoDB、MyISAM 及各家衍生)是它作为服务端生态的竞争策略;SQLite 的作者立场相反——引擎就是文件格式,格式就是契约,换引擎等于换文件,没有任何场景需要这种自由。SQLite 真正开放插件的位置在两端:VFS(操作系统接口,可插拔)与虚拟表(vtabs,让外部数据源伪装成表参与查询)。FTS5 全文引擎、dbstat 统计表都是用虚拟表机制实现的——自由度被放到了"接入什么数据"而不是"数据怎么落盘"。
**五层里哪一层最值得深入学习?**取决于职业方向。做查询优化的把编译层与虚拟机吃透(第 3 章),做嵌入式可靠的把 pager 与日志吃透(第 4 章),做运维排障的把页缓存与 VFS 吃透(第 7 章)。但无论哪个方向,B-Tree 层都是公共地基——它是唯一一层在三个引擎里结构相似的,学一次可以横向复用。
本节要点回顾
- 五层结构:接口、编译、虚拟机、B-Tree、页缓存加 VFS,每层都对应 MySQL 或 PostgreSQL 的某一站。
- VDBE 是 SQLite 独有的层:先把 SQL 编译成完整字节码再执行;MySQL 与 PostgreSQL 直接解释执行计划树。
- 薄的三笔账:省掉了后台线程与连接管理,也省掉了远程访问、集中审计与自动统计维护。
- 应用层策略被架构改写:进程内引擎不需要连接池,按线程开连接是正确姿势。
**编译层的三家产物能互相转换吗?**不能,也不需要。SQLite 的字节码、MySQL 的解析树、PostgreSQL 的查询树都是各自内核的私有中间形态,设计目标就是被自家的执行层消费。跨库的可交换单元是 SQL 文本本身,以及各自 EXPLAIN 输出这种"人读的计划"。做数据库网关类产品的人对此体会最深:SQL 方言可以转译,执行形态无法移植——这也再次说明"SQL 兼容"与"内核兼容"是两回事。
下一节让一条具体的 SELECT 穿过这五层,看看"进程内一次调用"与"网络一个来回"的旅程差异。