1.3 一次 SELECT 的两种旅程
1.3 一次 SELECT 的两种旅程
本节摘要:把
SELECT name FROM users WHERE id = 42分别放进 SQLite 与 MySQL,追踪它经过的每一站并标注延迟量级。进程内旅程的关键词是"函数调用与页寻址",服务端旅程的关键词是"协议往返与执行计划"。理解两条旅程,就理解了性能优化方向为何完全不同。
同一条查询,两条路
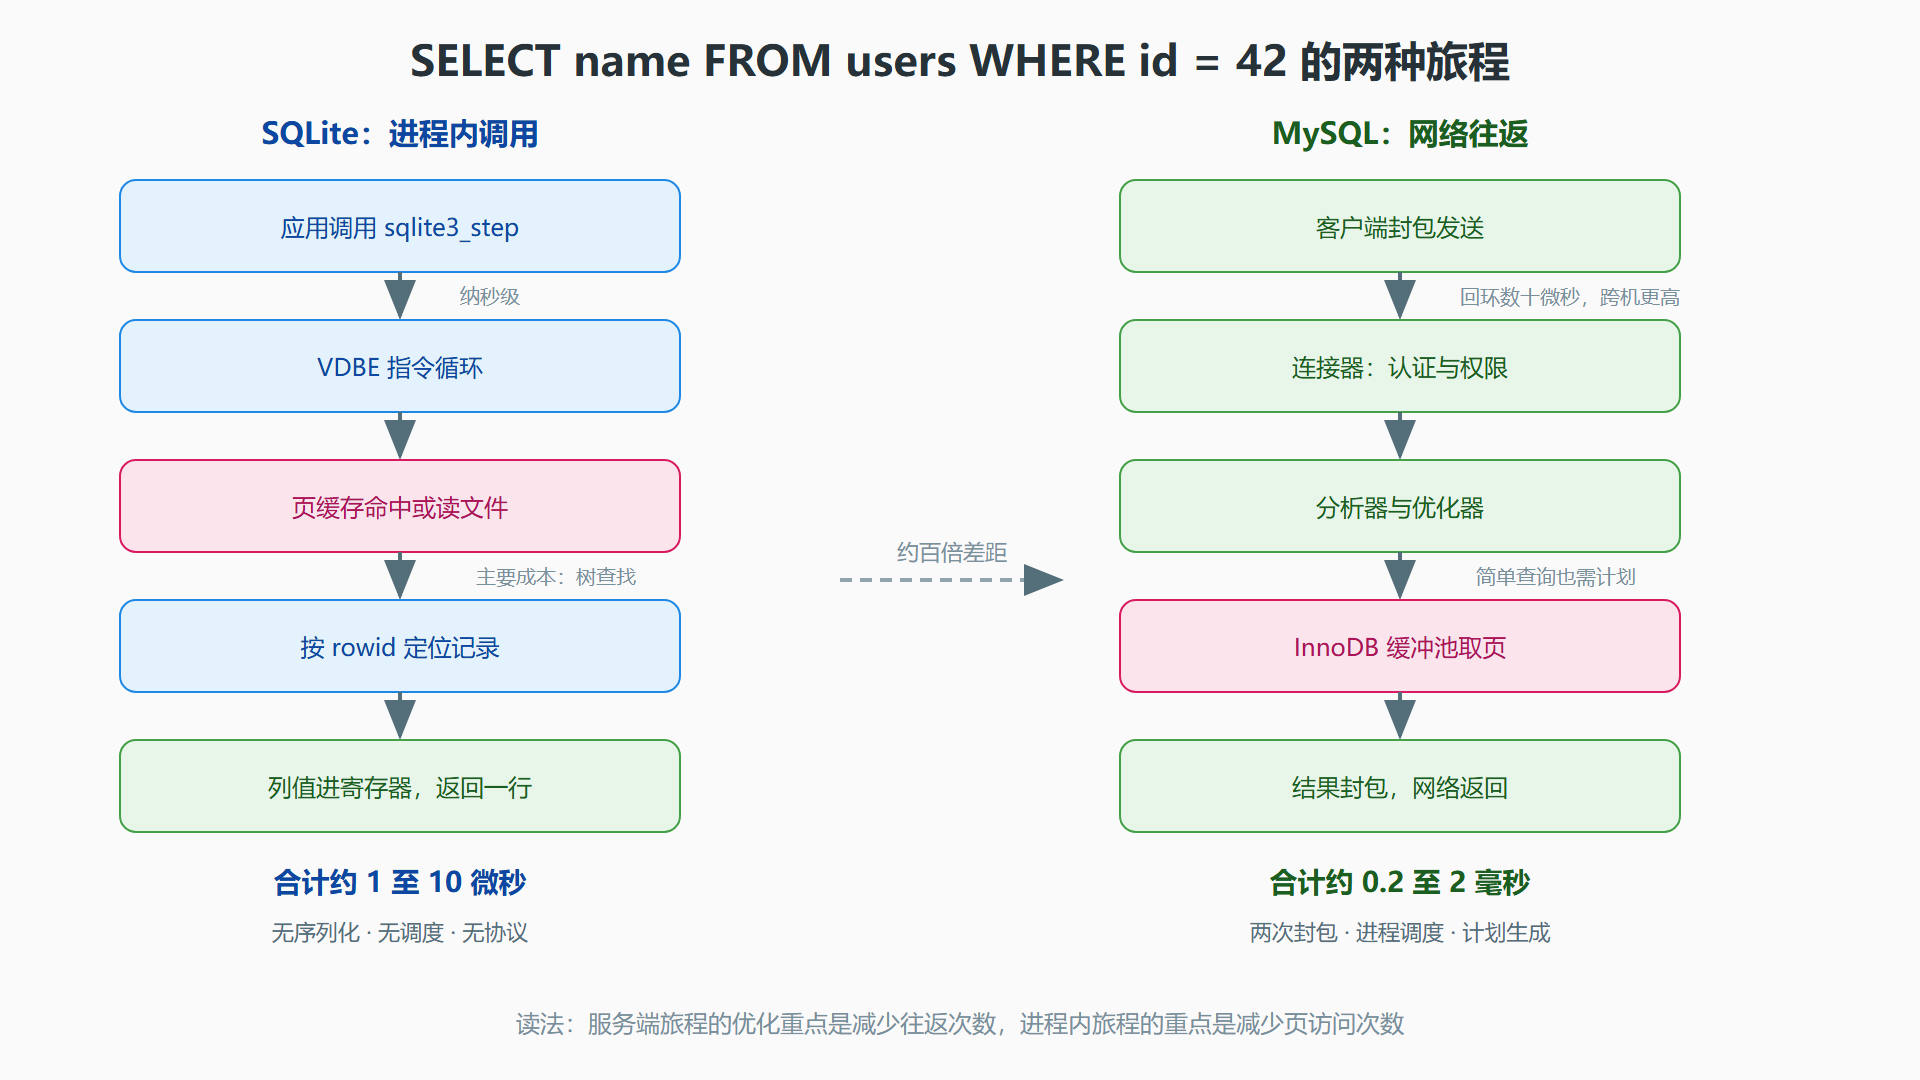
旅程从应用代码出发。两个世界里,这句 SQL 长得一模一样,走过的路却毫无相似之处。
SQLite 的旅程(进程内):sqlite3_bind_int 把 42 填进参数寄存器,sqlite3_step 一路走进 VDBE 指令循环。字节码大概率只有五六条指令:打开 users 表的 B-Tree 游标,按 rowid 定位到那条记录(如果 id 是 INTEGER PRIMARY KEY,这就是一次树查找,通常两三次页访问内完成),把 name 列拷进结果寄存器,暂停等应用取走。每一站都在当前线程的调用栈上,没有调度切换、没有序列化反序列化。整个旅程的成本通常是几微秒,其中大头是 B-Tree 层的页查找。
MySQL 的旅程(服务端):客户端把 SQL 文本(或预编译句柄)按协议封包,经过本机回环或真实网线到达 mysqld。服务器里四站接力:连接器做认证与权限校验;分析器做词法语法解析;优化器基于统计信息选择索引与连接顺序,生成执行计划;执行器调 InnoDB 接口,穿过缓冲池拿到数据页,逐行按协议封包发回。即使数据热在缓冲池里、查询简单到一眼看穿,一个来回也是零点几毫秒到几毫秒——比 SQLite 慢两到三个数量级,多出来的时间几乎全部花在旅程本身而不是数据查找上。
图:一次 SELECT 的两种旅程
延迟差异改写优化策略
两条旅程的单位成本不同,优化的着力点随之不同,这是对比驱动视角最有实用价值的推论。
服务端世界里的第一戒律是减少往返:能用一条 INSERT INTO ... VALUES (...),(...),(...) 批量插入就别循环单条插;能 JOIN 就别在应用层逐行回查;连接池之所以是标配,就是因为建连握手要几十毫秒、TLS 再添几毫秒。而在 SQLite 的世界里,往返成本是零,循环里调用一万次 sqlite3_step 毫无心理负担——真正的成本转移到页访问与事务次数:一万条各自提交的 INSERT 意味着一万次日志落盘,而包进一个大事务后只有一次,性能差距可达三个数量级。第 7 章 7.3 节会给出实测数字。
下表把两边的优化关键词并排放好:
| 优化目标 | MySQL / PostgreSQL 的抓手 | SQLite 的抓手 |
|---|---|---|
| 降低单查询延迟 | 预编译语句、执行计划、缓冲池命中率 | 页缓存大小、索引让树变矮 |
| 提升批量吞吐 | 多值插入、LOAD DATA、COPY | 大事务包裹、预编译复用 |
| 控制资源占用 | 连接数上限、内存配置 | cache_size、mmap_size |
| 减少网络影响 | 连接池、就近部署 | 不适用——没有网络 |
一个容易误判的场景
有团队把"每秒上万次点查"作为压测目标,用网络客户端压 MySQL 达不到,于是换 SQLite,结果更慢。排查发现应用开了 64 个线程,每个线程各自抢同一个写连接、每条 INSERT 单独提交——瓶颈根本不在引擎而在提交粒度。改成单写线程加大事务批量提交后,SQLite 轻松超过压测目标。这个案例值得记住:架构旅程决定成本结构,先看清成本花在哪一站,再谈引擎选型。
💡 关键直觉:服务端优化在"省路上的时间",嵌入式优化在"省找数据的时间"。混淆两者,会把力气花在最便宜的地方。
延迟预算的量级参照
把两条旅程放到同一张延迟标尺上,感受每一站的真实花费:
| 操作 | 量级 | 说明 |
|---|---|---|
| SQLite 寄存器操作、指令跳转 | 纳秒级 | 纯 CPU,无 IO |
| SQLite 页缓存命中后的一次树查找 | 约 1 微秒 | 三四层指针移动加比较 |
| SQLite 冷缓存机械盘读一页 | 5 至 10 毫秒 | 唯一可能的大头 |
| 本机回环一次简单查询往返 | 50 至 300 微秒 | 协议加调度,数据已热 |
| 跨机房一次往返 | 0.5 至 5 毫秒 | 光速与设备延迟兜底 |
| MySQL 建连加认证一次 | 5 至 50 毫秒 | 含 TCP 握手,TLS 更贵 |
两条结论可以刻进直觉。其一,服务端的世界里"次数"比"单次"更贵:把一千次往返合并成一次,收益远大于优化任何单次内部环节——这就是批量接口、JOIN 改写、连接池存在的理由。其二,SQLite 的世界里"页访问"是唯一大数:页缓存命中与否差三个数量级,所以热点数据结构与缓存预算的关系是第一等大事(第 7 章的 cache_size 算术全为此服务)。
这也解释了一个招聘面试常考的辨析题:"为什么 SQLite 不需要连接池而服务端数据库需要?"答案不在引擎能力,在旅程结构——连接在 SQLite 里只是一个指针结构体,开与关纳秒级;在服务端是 TCP 加认证加会话状态,毫秒到几十毫秒。池的本质是把"昂贵的建立"摊销到"多次的使用",没有昂贵建立就没有池的必要。
常见问题速答
**嵌入式场景还能再压延迟吗?**压不了旅程,就压数据形状。让热点索引足够小到永远热在缓存(点查稳定在微秒级);把访问模式收敛为按主键点查;避免每次查询都触发 schema 解析(复用连接与语句)。三板斧之后剩下的就是物理极限。
**网络数据库能不能通过本地缓存达到 SQLite 的延迟?**读侧可以近似(进程内缓存热点数据),写侧不行——任何写都必须走网络到真正的数据所有者,否则一致性与"数据库"二字无缘。SQLite 的微秒级写延迟(WAL 顺序追加后返回)在这个意义上不可复制,这也是本地优先(local-first)应用把权威数据放设备端 SQLite 的根本理由。
本节要点回顾
- 进程内旅程以微秒计,成本集中在 B-Tree 页查找;服务端旅程以毫秒计,成本集中在协议、调度与计划生成。
- 服务端优化的核心是减少往返,嵌入式优化的核心是减少页访问与事务提交次数。
- 批量写入在两边是完全不同的故事:MySQL 靠多值语句与 LOAD 语句,SQLite 靠大事务包裹。
- 遇到性能问题先画旅程图:确认时间花在哪一站,比换引擎更有效。
**预编译之后,SQLite 的旅程还剩什么成本?**只剩三段:bind 的参数拷贝、step 里的页访问、结果行的列提取。前两段都能优化(参数复用、索引收缩),第三段有个小技巧——按列序号取值(sqlite3_column_int)比按列名映射快,因为后者省掉了 ORM 层的名字查找。旅程越短,每一环的微小开销越显眼,这是嵌入式优化的普遍规律。