1.4 数据库文件解剖
1.4 数据库文件解剖:100 字节头与 4096 字节页
本节摘要:SQLite 的全部数据——表、索引、schema、空闲空间管理——住在一个文件里。本节用十六进制视角打开这个文件,逐段解读开头 100 字节的文件头字段,解释页大小为什么默认 4096 字节、为什么建库后修改代价高昂,并与 MySQL、PostgreSQL 的文件布局对照,看"单文件哲学"意味着什么。
先看一份字节清单
新建一个只有一张小表的数据库,用十六进制工具看前 128 字节(示意输出,字段按真实格式对齐):
00000000 53 51 4c 69 74 65 20 66 6f 72 6d 61 74 20 33 00 |SQLite format 3.| 00000010 10 00 01 01 00 40 20 20 00 00 00 0a 00 00 00 04 |.....@ .. ......| 00000020 00 00 00 00 00 00 00 00 00 00 00 01 00 00 00 04 |................| 00000030 00 00 00 00 00 00 00 00 00 00 00 01 00 00 00 00 |................| 00000040 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 |................| 00000050 00 00 00 00 00 00 00 00 00 00 00 04 00 2e 24 06 |..............$.|
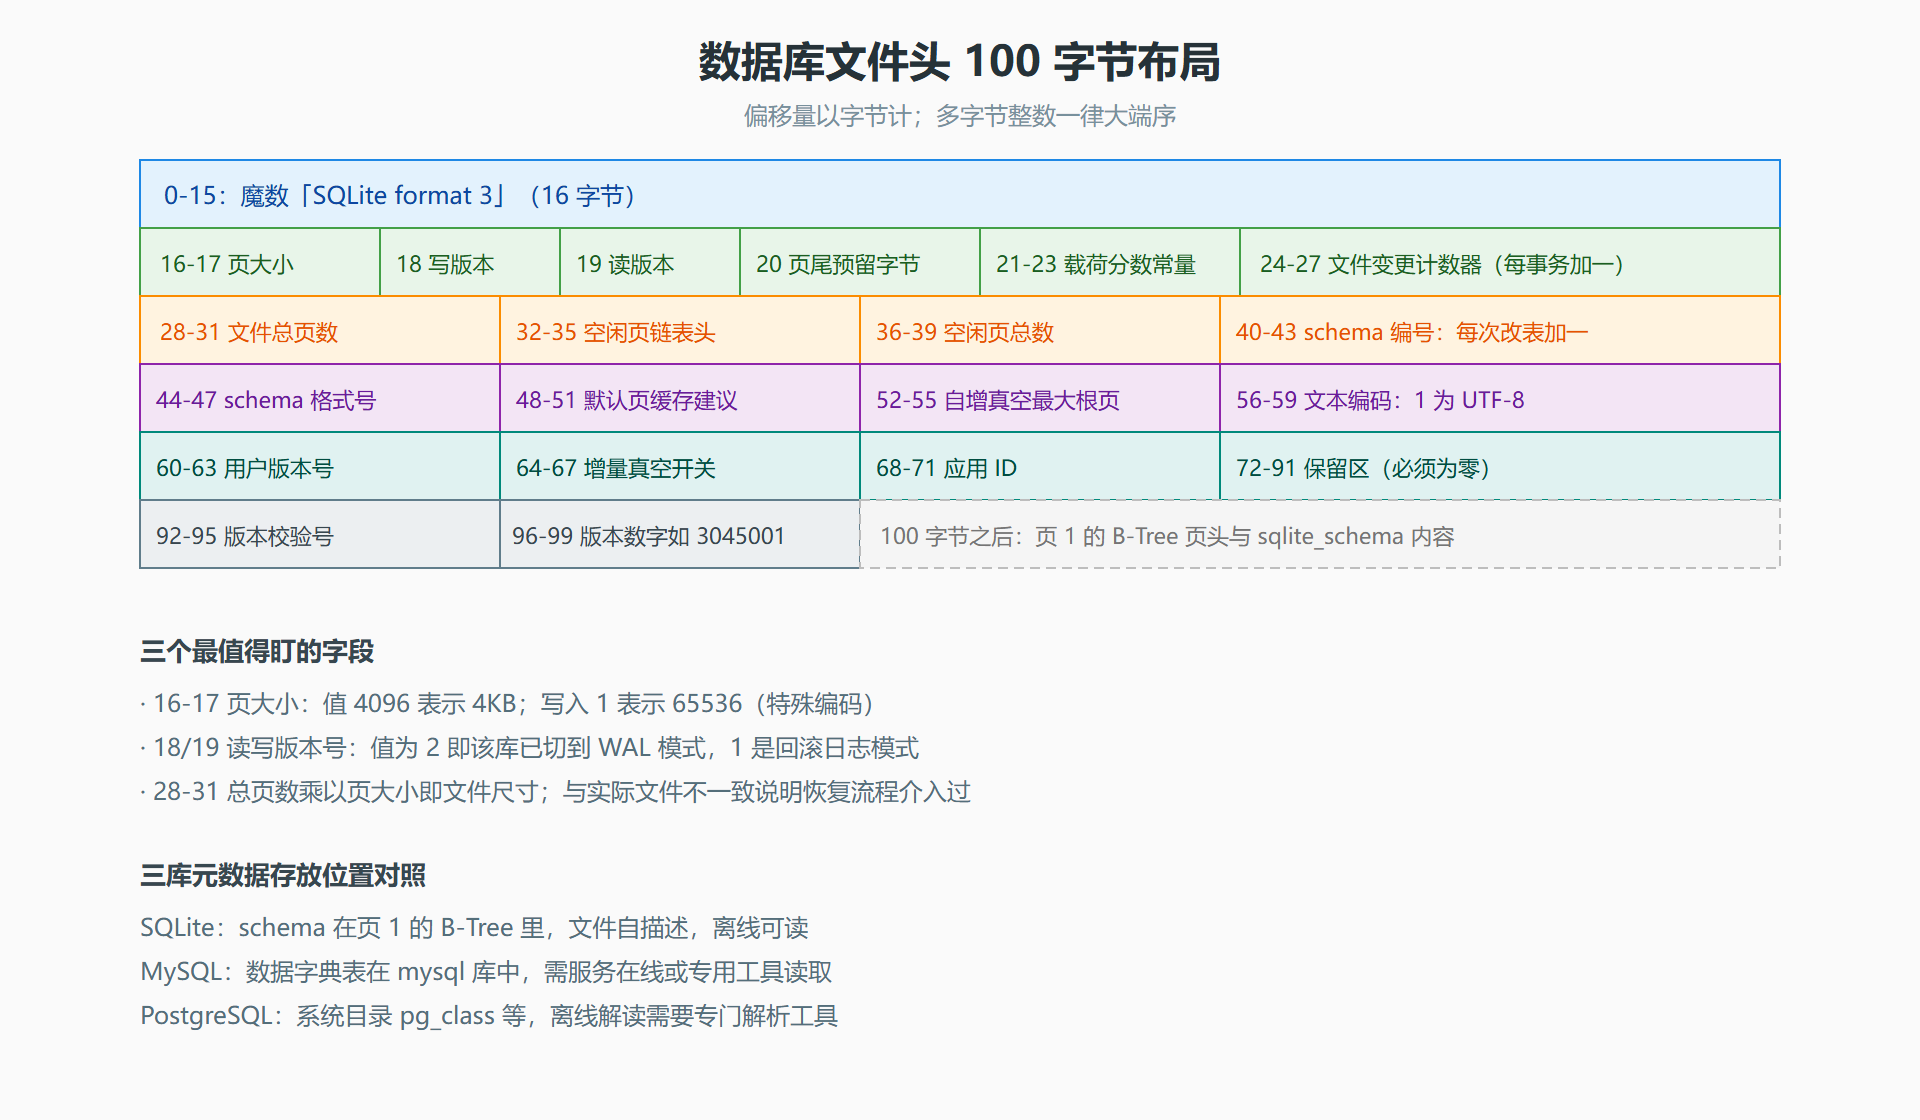
前 16 字节是魔数 SQLite format 3,它就是整个"零配置"承诺的起点:任何工具拿到文件,先读这 16 字节确认格式,再读后续字段就能完整理解文件结构——不需要连上任何服务去询问元数据。对比 MySQL:要知道表结构得查数据字典表;对比 PostgreSQL:schema 存在系统目录里,离线状态下需要专门的工具才能读出。SQLite 把 schema 本身也存成一个名为 sqlite_schema 的 B-Tree(根页号 1),文件即自描述。
图:数据库文件头 100 字节布局
4096 字节从哪来,为什么改不动
文件头第 16-17 字节存页大小,合法值是从 512 到 65536 的二次幂。默认 4096 不是随便选的:它是绝大多数文件系统与块设备的逻辑块边界(4KB 扇区对齐),一个页落在系统缓存里就是一个完整缓存行组,读写都不会跨页放大。页小了,B-Tree 更高、指针开销占比更大;页大了,单页内碎片更多、写一个单元格要重写的范围更大、内存里缓存的粒度也变粗。4096 是几十年来被反复验证的折中,MySQL InnoDB 干脆固定 16KB、PostgreSQL 固定 8KB,各自围绕自己的缓冲区管理做出取舍——三个引擎都没有把页大小开放成随意调的旋钮,原因相同:数据结构对页大小的依赖是全局性的。
SQLite 允许在建库前用 PRAGMA page_size = 8192; 设定,但一旦库里有表,再改就得走整库重建:
PRAGMA page_size = 8192; -- 只对"下一个新建的库"生效 VACUUM; -- 现有库改页大小的唯一办法:整库重写
VACUUM 重写整个文件的代价与库的大小成正比,所以页大小的决策属于"建库那一分钟就要做对"的事。
单文件哲学的得与失
把 MySQL 的数据目录和 SQLite 的单文件放在一起看,得失都写在形态上。得:备份变成复制文件(配合第 8 章的 backup API 更稳);迁移变成拷走文件;文件损坏的影响范围有明确边界;嵌入场景里"一个用户的数据一个文件"成为可能。失:没有表级别的物理隔离,一张大表的膨胀和整库的膨胀绑在一起;并发写入没有表级分区这种逃生通道;单文件在部分网络文件系统上的锁语义不可靠,官方文档明确警告过这一点。
还有一个容易忽略的细节:文件头 92-99 的版本号与校验号。每次以"文件格式可能变化"的方式提交事务,24-27 的变更计数器加一,92-95 记录"这个计数器在哪个版本号时是有效的"。恢复流程正是靠这两个字段的组合判断缓存里的页是否过期。对比 PostgreSQL 的控制文件(pg_control)里的系统标识符与检查点位置,你会看到同一种设计意图在不同格式里的两种表达。
动手练习:给文件头做一次体检
把体检写成一条 SQL 加一次十六进制阅读的组合动作,你可以对任何来源不明的库文件快速定性:
PRAGMA page_size; -- 应与文件头 16-17 字节一致 PRAGMA page_count; -- 与文件头 28-31 的总页数对照 PRAGMA journal_mode; -- 回答"这是回滚库还是 WAL 库" PRAGMA integrity_check;
文件尺寸对不上页数乘页大小时有三种解释:文件尾部有 WAL 未检查点的页(正常);文件被截断过(危险,恢复流程会介入);文件不是 SQLite 格式(魔数都过不了)。十六进制阅读还有一个实用场景——鉴定伪造的备份:改过扩展名的文本文件、写了一半的空文件、被其他程序当容器使用的文件,魔数与前 100 字节能在毫秒内给出答案,比任何工具的加载报错都直接。
常见问题速答
**页大小到底要不要调?**默认 4096 适合绝大多数场景。考虑调大的信号:行宽普遍偏大(如存了较多中等长度的文本),或全库几乎只做顺序扫描(更大的页摊薄每页固定开销)。页大小翻倍带来的叶容量与扇出双翻倍(第 2.2 节的平方规律)能让树矮一层,代价是单页重写与缓存粒度变粗。65536 上限的极端设置在多数负载上得不偿失,不建议。
**文件头里的"用户版本号"和应用 ID 有什么用?**两个字段都是写给应用程序的自由位:PRAGMA user_version 与 PRAGMA application_id 读写它们。常见用法是把 schema 版本写进 user_version 做迁移判断(第 8.4 节的部署清单),应用 ID 写进自有格式(比如扩展名伪装的容器文件)做身份标识。它们纯粹是元数据,引擎自己不解释。
本节要点回顾
- 文件头 100 字节让 SQLite 文件自描述:页大小、版本、页数、空闲链表、编码全在里面,离线即可解读。
- 页大小默认 4096 字节,建库后修改需要
VACUUM整库重写;InnoDB 固定 16KB、PostgreSQL 固定 8KB,取舍逻辑同源。 - 文件头 18/19 字节的读写版本号是判断一个库是否处于 WAL 模式的物证,第 4 章会再遇到它。
- 单文件哲学换来自包含与可迁移,代价是没有表级物理隔离,且在网络文件系统上锁语义不可靠。
文件的头读完了,接下来的第 2 章走进 4096 字节内部:页有哪几种,单元格怎么排布,B+ 树怎么把这些页串起来。