2.1 页面类型与布局
2.1 页面类型与布局:表页、索引页、溢出页与空闲页
本节摘要:SQLite 数据库文件就是一串编号从 1 开始的页。本节给出五种页类型的完整清单,拆解一个 B-Tree 页从页头、单元格指针数组到内容区的字节级布局,解释"指针数组向下长、内容向上长"的双向生长设计,以及自由块链表如何在页内回收碎片。
先认识五种页
SQLite 把页分成五类,判断依据是页首第一个字节(页类型码):
| 类型码 | 页类型 | 职责 |
|---|---|---|
| 2 | 索引内部页 | 索引 B-Tree 的非叶节点,存键加左右孩子指针 |
| 5 | 表内部页 | 表 B-Tree 的非叶节点,存 rowid 分隔键加孩子指针 |
| 10 | 索引叶子页 | 索引 B-Tree 的叶节点,存被索引列加 rowid |
| 13 | 表叶子页 | 表 B-Tree 的叶节点,存整行数据 |
| 无 | 空闲页 | 从链表上摘下来的页,等待复用 |
页 1 是特例:它开头是第 1 章讲过的 100 字节文件头,后面接的是 sqlite_schema 表的 B-Tree 页头。也就是说,"哪张表存在哪"这件事本身也住在一棵 B-Tree 里——schema 自描述是靠这个机制实现的,而不是靠任何文件外的元数据。
对比另外两家:InnoDB 的页类型更多(索引页、undo 页、系统页、blob 页等),由表空间统一编号;PostgreSQL 的页固定 8KB,堆表页与索引页结构不同但都没有"内部页与叶子页共用一套布局"的统一设计。SQLite 用一套 B-Tree 页布局同时承载表与索引,是它代码量极小的原因之一。
拆开一个表叶子页
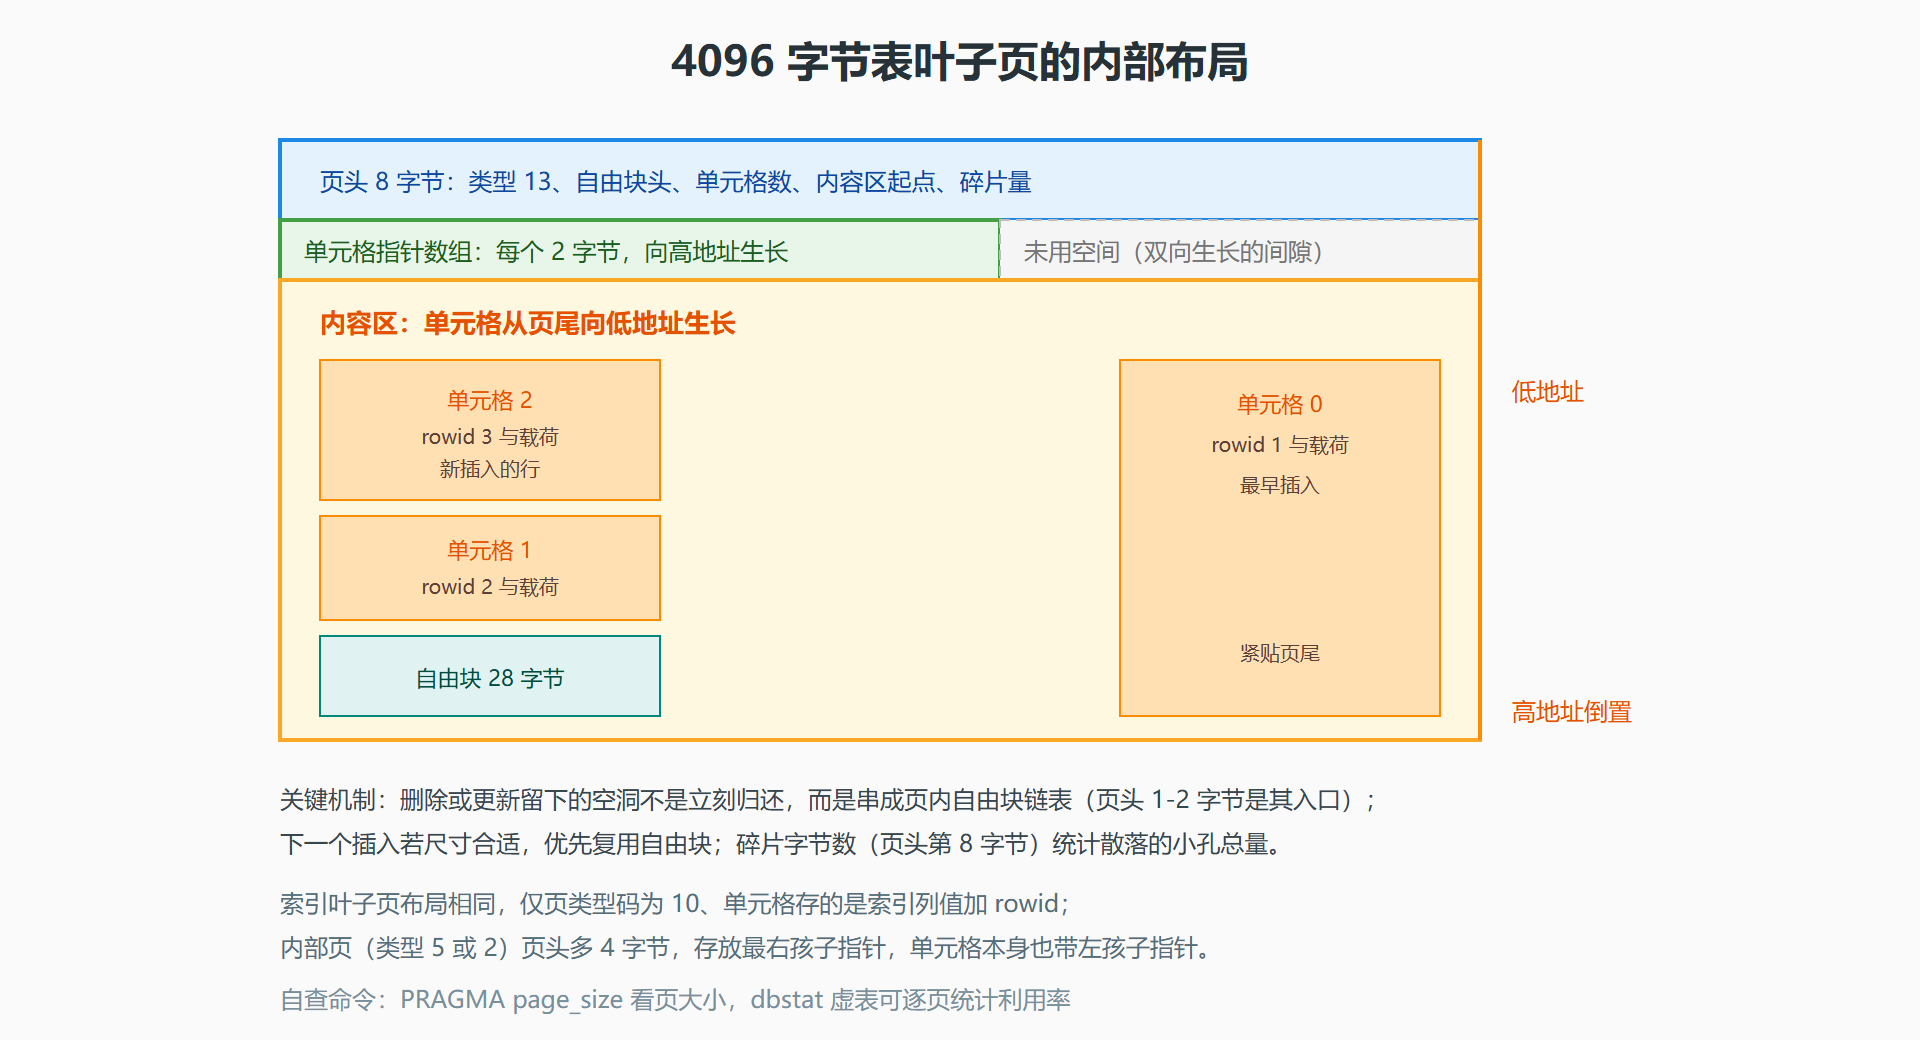
一个 4096 字节的表叶子页(类型码 13)内部是这样的:
偏移 长度 内容 0 1 页类型码 = 13 1 2 第一个自由块偏移(0 表示无碎片块) 3 2 单元格数量 5 2 内容区起始偏移(0 视为 65536) 7 1 碎片字节数 8 2 单元格指针[0] ┐ 10 2 单元格指针[1] │ 指针数组,每个 2 字节, ... ... ... │ 从页头之后向高地址生长 xx 2 单元格指针[n-1] ┘ ... (未用空间) yyyy ... 单元格[n-1] ┐ ... ... ... │ 内容区,从页尾 4095 ... 单元格[0] ┘ 向低地址生长
单元格(cell)才是行数据真正住的地方。表叶子页的单元格结构是:载荷长度(变长整数)、rowid(变长整数)、记录载荷、(超长时的)溢出页号。载荷内部按列顺序排布类型码加数据,这就是"一行"在磁盘上的完整模样。
图:B-Tree 页内部布局
双向生长为什么是妙棋
新插入一行时,单元格指针在页头后面追加(向高地址走 2 字节),单元格本体从页尾往前放(向低地址走 N 字节)。两边相向而行,中间剩余空间归零时页满。这个设计省掉了一次"压缩整理":如果内容紧跟在指针数组后面,每次插入都要把后面所有单元格整体后移;双向生长让所有已有单元格的位置永远不动,插入只是往空隙两端各伸一截。对读方的好处同理:单元格一旦写入,偏移量稳定,指针数组里的值不需要随插入批量更新。
这也解释了删除的语义。删除一行只是把它的字节登记为自由块(在块头写上"下一个自由块偏移"),并不移动后续单元格。自由块链表加上页头里的碎片计数,构成页内的两级空间账本——链表管大块的复用,碎片计数管小到不值得入链的孔。什么时候页被真正压缩?当插入者发现"链表加未用空间总量够放,但连续空间不够"时,会先把整个页整理一次再插,这一步在代码里叫 quick-balance 之前的空间整理路径,代价是 O(页内单元格数),这正是碎片重的页写入变慢的微观原因。
⚠️ 大行会溢出。载荷超过阈值(4096 字节页下约 4061 字节)时,单元格只存前缀,剩余部分串到溢出页链上,每读这一行要多访问一页。把大字段控制在行内,是 SQLite 优化里性价比最高的一条。
对照:别的引擎怎么组织页
InnoDB 的页同样是 16KB 定长块,同样是"页头加记录区"的结构,但记录之间用槽加有序指针组织,页内还有自己的空闲链表与页目录做二分查找;SQLite 则依赖指针数组的有序性做二分——两者殊途同归,都是"页内有序、页间靠树"。PostgreSQL 的堆页不排序:新行追加到页尾,老版本的行留在原地等 VACUUM 清理,排序的职责完全交给索引。换句话说,SQLite 把"有序"做在表页里(表即主键树),PostgreSQL 把"有序"完全外包给索引,InnoDB 介于两者之间——数据按主键聚簇,但页内还有自己的目录结构。三种选择没有绝对优劣,第 2.3 节会用同一张表的三种落盘方式算这笔账。
一个页内整理的触发案例
把抽象的碎片机制落到一个可复现的实验。建一张表,插入一批行,删除其中的偶数行,然后观察页内状态:
CREATE TABLE frag(id INTEGER PRIMARY KEY, pad TEXT); -- 插入 10000 行,pad 约 100 字节 -- DELETE FROM frag WHERE id % 2 = 0; -- 删掉一半 PRAGMA freelist_count; -- 若删除发生在整页层面,这里增长
删除一半行后,如果删除的行恰好凑成整页,这些页进 freelist(文件层面可见);但更常见的是每页只空出一半——页还是那些页,只是内部多了大自由块。此时新插入的行会优先填这些洞,文件不再长大,这是碎片自我修复的一面;但范围扫描依旧要读过全部页(页数没少),扫描速度没有恢复。真正归还空间只有两条路:VACUUM 整库重写,或 auto_vacuum 模式下的增量归还。这个实验解释了"删除后文件为什么不变小"——这也是 SQLite FAQ 里出现频率最高的问题之一。
常见问题速答
**单元格指针为什么只占 2 字节?**指针存的是页内偏移,页最大 65536 字节,两个字节(0 到 65535)恰好覆盖。文件头为页大小 65536 专门设计了"值 1 表示 65536"的特殊编码,指针数组的 2 字节宽度正是整套格式围绕 16 位页内偏移设计的结果——这也是页上限是 64KB 而不是更大的历史原因。
**溢出页链会拖慢读吗,怎么避免?**会。溢出的行每读一次要多访问链上每一页,最坏情况一行几十页。避免方法:大字段(长文本、BLOB)控制在两三 KB 以内;确实大的资源(图片、附件)存文件或对象存储、库里只存定位信息。判断现状用 dbstat 看溢出页占比,或对可疑表跑一次 SELECT 长度最大的行 复查行宽。
本节要点回顾
- 五种页类型码:2、5、10、13 加空闲页;schema 本身是根页为 1 的 B-Tree。
- 页内三段式:8 字节页头、2 字节一格的指针数组、自页尾向下生长的内容区,双向生长让插入不搬动既有单元格。
- 空间回收分两级:自由块链表管大块,碎片计数管小孔;不连续则触发页内整理。
- 载荷超过约 4061 字节触发溢出页链,控制行宽就是控制 IO 次数。
下一节把本节的布局事实升级成算术:给定行宽,一棵 B+ 树三层能装多少行?