2.2 B树阶数与层数手算
2.2 B+树阶数与层数:一道可以手算的题
本节摘要:给定页大小与行宽,B+ 树的叶子容量、内部节点扇出、层数与总行数全部可以手算。本节完整演算一遍:4096 字节页、约 80 字节一行的表,三层树能装下约一千万行。这个模型是索引设计、分区决策、容量规划共同的数学底座。
从一道算术题开始
设一张表:CREATE TABLE events(id INTEGER PRIMARY KEY, device TEXT, value REAL, ts INTEGER),每行实际载荷约 80 字节,行数预期三千万。问:这棵表 B-Tree 需要几层?查一行要走几次页访问?
先把两个基础量算出来。
叶子页容量。表叶子页可用空间是 4096 减去 8 字节页头,再留一点余量按 4080 算。每个单元格的成本分三部分:载荷长度变长整数约 1 字节、rowid 变长整数(三千万行内,rowid 上限需要 4 字节变长编码)约 4 字节、记录载荷 80 字节,合计约 85 字节;指针数组再摊 2 字节。于是每行占约 87 字节:
每叶子页行数 = 4080 ÷ 87 ≈ 46 行
内部页扇出。表内部页(类型码 5)页头 12 字节,每个条目是"4 字节左孩子页号 + rowid 变长整数(约 4 字节)",指针数组再摊 2 字节,每个分支成本约 10 字节:
扇出 = (4096 − 12) ÷ 10 ≈ 408 → 保守取 400
有了叶子容量与扇出,层数就是一个除法游戏:
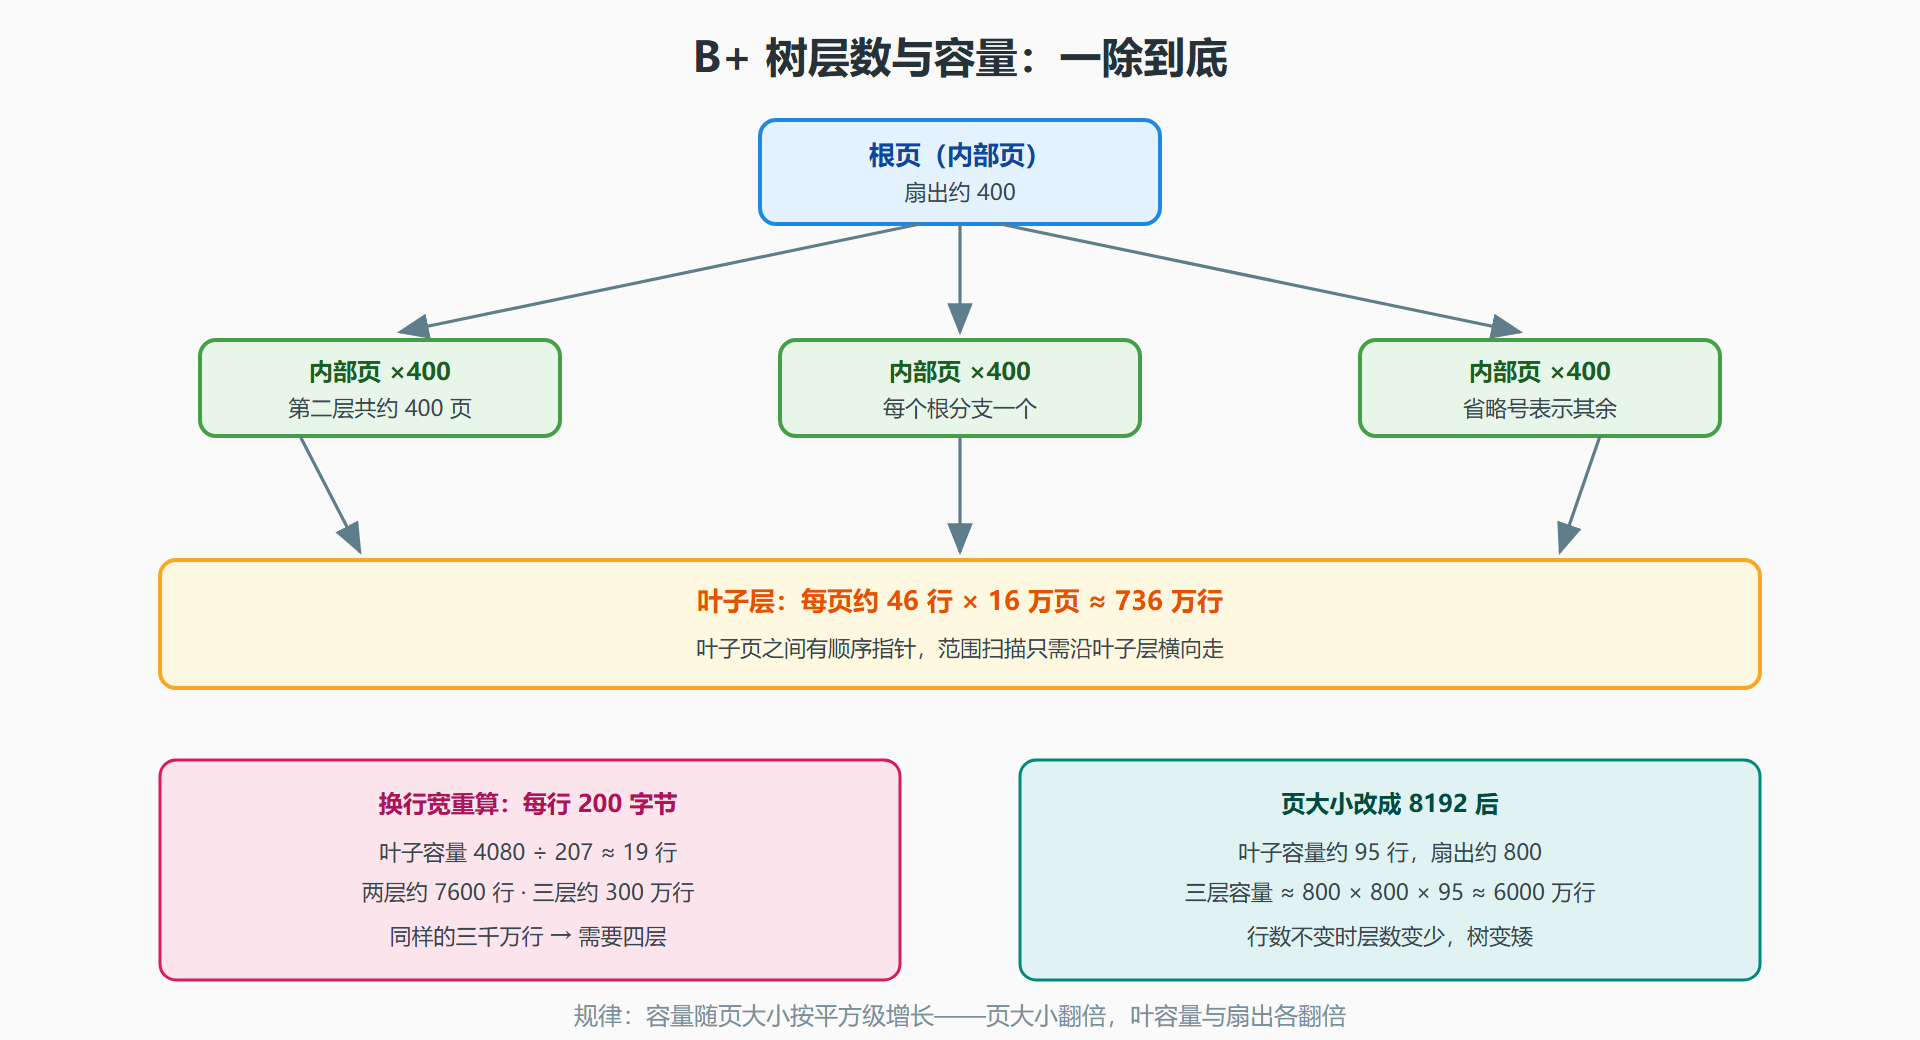
一层(只有根页当叶子): 46 行 两层(根 + 叶子): 400 × 46 ≈ 1.8 万行 三层(根 + 内部 + 叶子): 400 × 400 × 46 ≈ 736 万行 四层: 400 × 736 万 ≈ 29 亿行
结论:三千万行需要四层树。按 rowid 点查一行,最坏要访问 4 个页——根页永远热在页缓存里,实际磁盘访问通常只有 0 到 2 次。B+ 树的对数复杂度在这里变成了具体的除法,这就是"阶数与层数"的全部内容。
图:三层 B+ 树结构与容量估算
用模型回答三个工程问题
**问题一:这张表需要分区吗?**模型给出判断依据:只要层数不超过四层,点查的页访问成本几乎不变(每层多一次页缓存命中是微秒级)。三千万行的 events 表四层就够,不需要为了"太大"而分区;真正该分区的信号是维护成本——VACUUM、备份恢复的窗口时间——而不是查询速度。
**问题二:索引为什么让写入变慢?**每加一个索引,每次 INSERT 除了写表叶子页,还要更新一棵独立索引树(第 5 章展开它的叶子页布局)。按上面的算法,索引树通常比表树矮一层,但"每行多维护一棵树"是实打实的写入放大。宽表配五六个索引,写入量轻松翻三倍——这是算术,不是玄学。
**问题三:为什么 SQLite 文档说 rowid 点查是最快的访问路径?**INTEGER PRIMARY KEY 让主键即 rowid,点查直接在表树上完成,无需回表。如果主键是 TEXT(比如 UUID),表树按隐藏 rowid 组织、按 UUID 建的索引树存的是"UUID 加 rowid",点查要先走索引树拿到 rowid,再走表树取整行——两次树查找。InnoDB 用户对这个差别无感,因为 InnoDB 的二级索引叶子存的就是主键值、表本身就是主键树,路径结构与 SQLite 不同但次数相近;PostgreSQL 则始终是"索引拿 ctid、堆里取行"两跳。三个引擎路径形态不同,"索引额外一跳"的成本本质相同。
验证:让真实文件对答案
sqlite3 自带的 dbstat 虚表(编译选项默认开启)可以逐页统计,把上面的估算放到真实文件上对账:
CREATE TABLE events(id INTEGER PRIMARY KEY, device TEXT, value REAL, ts INTEGER); -- 插入 100 万行后: SELECT SUM(pgsize)/4096 AS pages FROM dbstat WHERE name='events'; -- 输出约 21000 页:1000000 ÷ 46 ≈ 21700 叶子页,再加少量内部页,与估算吻合
你再插入到 800 万行附近会观察到页数跳变式的增长——那正是树从三层长到四层的时刻。亲手看到这个拐点,比读十遍教科书都有效。
常见问题速答
**为什么删除一半行后文件不变小?**删除只把单元格登记为自由块、把空了的整页挂上 freelist,文件尺寸(页数)不变。freelist 上的页会被后续插入复用,所以文件不再增长但也不收缩。要真正归还磁盘,VACUUM 整库重写;或建库时开 auto_vacuum 的增量模式,用 incremental_vacuum 分批归还。这也意味着容量规划按"历史峰值行数"而不是"当前行数"算——B-Tree 的层数只认文件里出现过的最大规模。
**索引树的层数和表树一样吗?**通常更矮。索引叶子单元格只存键加 rowid(或键加主键值),比整行小得多,4096 字节页能装数百到数千个条目。用本节的方法重算一遍就能看到:同样一千万行的表,表树三层四层,其上的索引树往往两层就够——这就是为什么索引点查通常只比 rowid 点查慢"一次回表"而不会慢很多次页访问。
**估算不准怎么办?**估算用平均行宽,真实负载里宽行稀疏分布会让实际页数高于估算。精确数字永远以 dbstat 实测为准:SELECT SUM(pgsize)/4096 FROM dbstat WHERE name='表名' 给出真实页数,除以叶容量得真实层数。估算用于设计阶段的容量规划,实测用于验收。
本节要点回顾
- 叶子容量 = 可用空间 ÷ 每行成本(载荷 + 变长整数 + 2 字节指针);扇出 = 内部页可用空间 ÷ 每分支成本(约 10 字节)。
- 4096 字节页、80 字节行的表:两层约 1.8 万行、三层约 736 万行、四层约 29 亿行——绝大多数表一辈子都在三层以内。
- 容量随页大小平方级增长:页翻倍,叶容量与扇出各翻倍,这是大页的真价值。
- 层数不是分区的理由,维护窗口才是;INTEGER PRIMARY KEY 点查省一跳,TEXT 主键必然两跳。
**能不能让树永远保持两层?**不能靠意愿,只能靠约束行数与行宽。两层树的容量上限(约一万八千行,按本节参数)是硬边界,业务增长穿透它时树会自己长高——这是特性不是缺陷。真正该做的预案是:把"三层内"当作大多数表的常态,为可能破四层的超长尾表(数亿行)准备分区或归档策略,而不是试图对抗对数增长本身。
下一节带着这套算术去对照三个引擎:同一种树,三条存储路线。