3.1 解析前端三库对照
3.1 解析前端:词法、语法与表达式树的三库对照
本节摘要:解析前端把 SQL 文本变成内核能消化的结构。SQLite 用手写词法器加 Lemon 生成的 LALR 解析器直接产出表达式树,MySQL 走 Bison 语法树再加优化改造,PostgreSQL 把词法、语法、语义拆成三个独立子系统。本节走完三站流水,并解释 SQLite"边解析边准备"的嵌入式取舍。
从字符流到表达式树
拿一条最常见的写入语句当标本:
INSERT INTO events(device, value, ts) VALUES('sensor-07', 21.5, 1725600000);
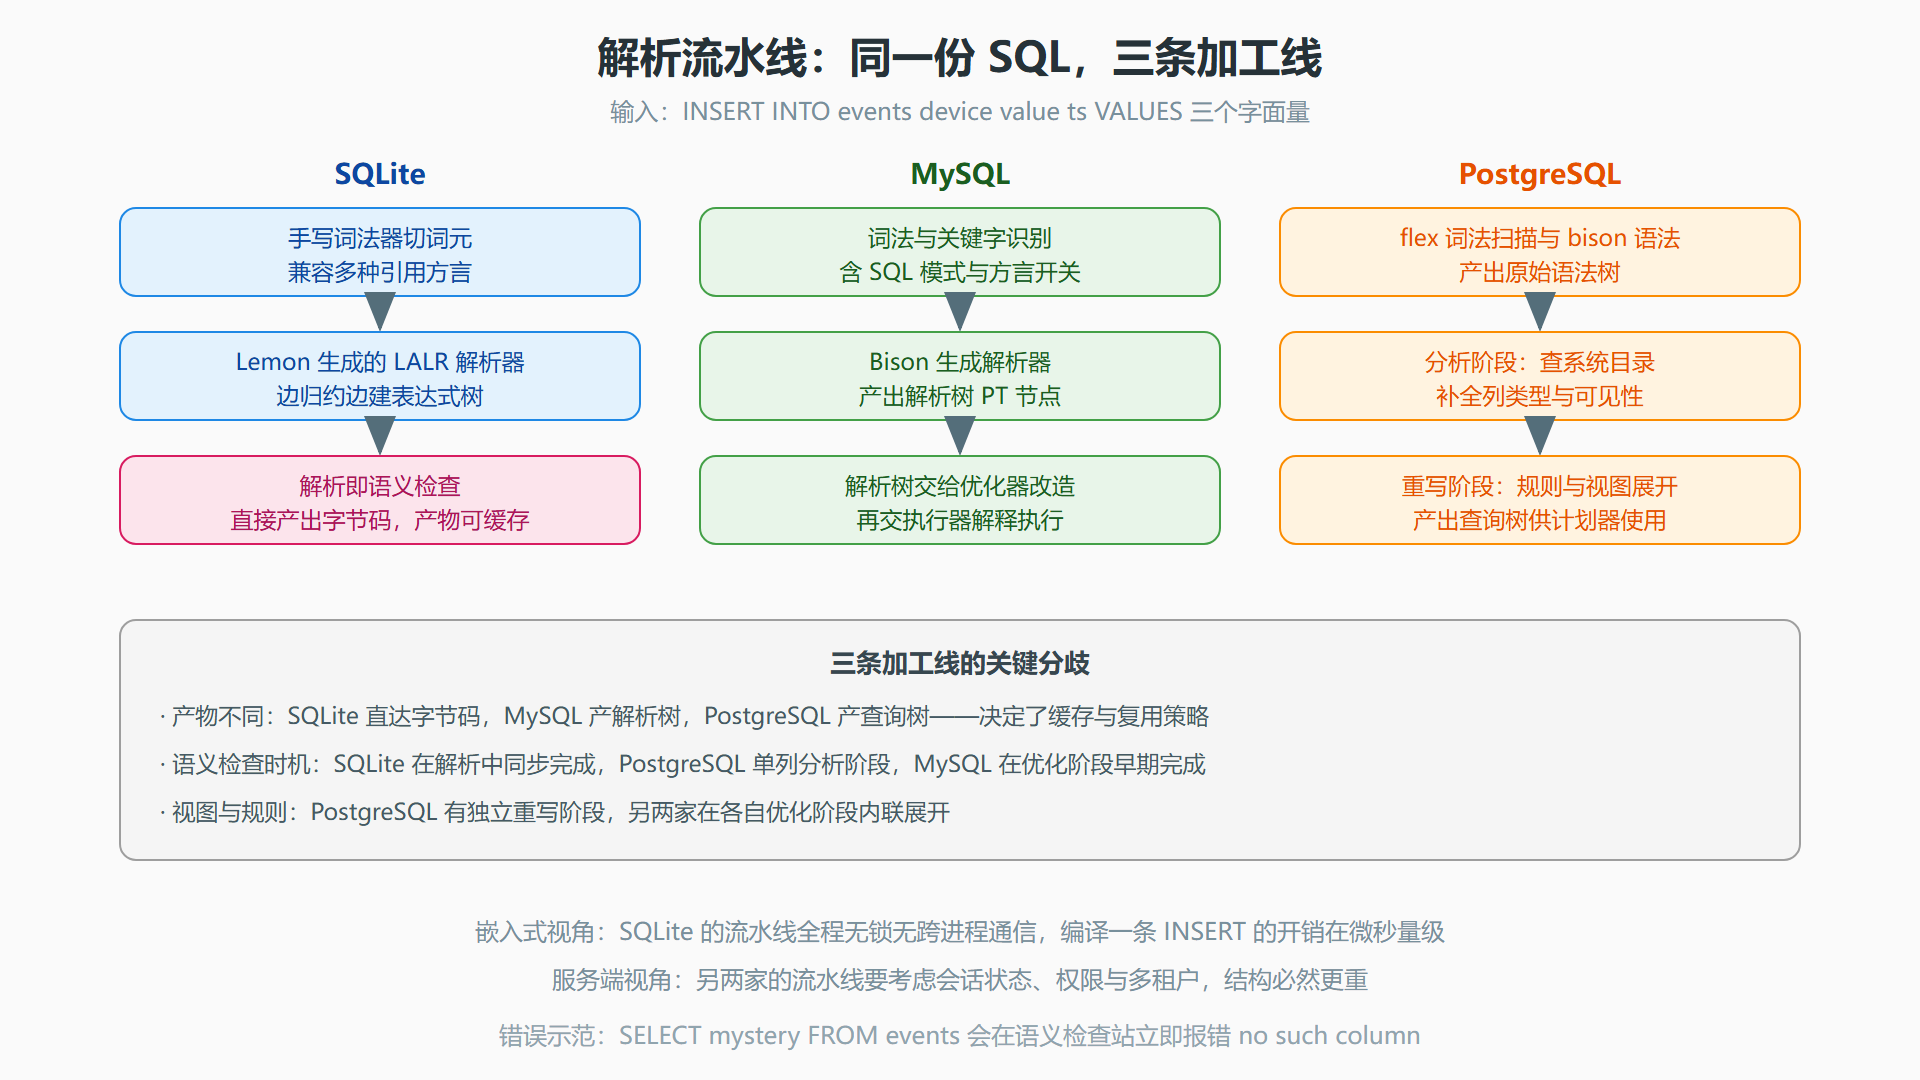
SQLite 的解析流水分三站。第一站词法分析:手写的分词器把字符流切成词元——关键字 INSERT、标识符 events、逗号、字符串字面量、浮点数、整数。词法器同时处理三库之间一个著名的语法分歧现场:SQLite 接受双引号里的标识符与单引号里的字符串,还保留了方括号引用这种方言兼容。第二站语法分析:Lemon 生成的 LALR 自动机按语法规则归约,每归约一条规则就调用语法动作,直接在内存里搭出表达式树(Expr 树)——注意,这里没有中间的"完整语法树再转抽象树"两步。第三站语义挂钩:解析过程中同步查 schema 缓存,验证 events 表存在、列名拼写正确、值个数与列数匹配,错误在这一站就以友好的报错返回,不会流到执行层。
图:SQL 解析流水线三库对照
三个值得停下来看的分歧
**分歧一:解析的产物是什么。**SQLite 的解析终点是字节码——解析器输出的表达式树立刻被代码生成器消费,产物是一条可以直接执行的指令序列,因此"prepare 一次、execute 多次"天然成立。MySQL 的产物是解析树(ParseTree),树还要交给优化器改写成执行计划;PostgreSQL 的产物是查询树(Query 树),要再经过计划器变成计划树。产物越"终态",缓存的价值越大——这就是为什么 SQLite 应用层做语句缓存的收益极其稳定,而 MySQL 8.0 干脆删掉了查询缓存:它的产物依赖太多会话状态(字符集、SQL 模式、权限),复用的前提太苛刻。
**分歧二:语义检查在哪个阶段。**PostgreSQL 的分析阶段(parse analysis)查系统目录补全类型信息,重写阶段(rewriter)展开视图与规则,这条流水线最长,也最严谨。SQLite 把列名解析、类型推导都压进解析与代码生成之间,没有独立阶段——换来的是更少的内存拷贝,代价是扩展点少(SQLite 的视图展开也在代码生成里顺手完成)。
**分歧三:错误信息的形态。**三条流水线报错的时机和措辞不同。同一个"表不存在",SQLite 报 no such table: events;MySQL 报 Table events doesn't exist;PostgreSQL 报 relation "events" does not exist。做跨库工具时,错误分类逻辑要按三套规则写——这是对照驱动读书法里很实际的一课。
一个误区:解析不是性能大头
很多人以为"减少 SQL 解析时间"要靠写更短的 SQL。实测里,简单语句在 SQLite 上的完整 prepare 只需微秒级,真正值得优化的是复用次数而不是单次耗时:同一形状的语句执行一万次,不 prepare 一万次——这是下一节 VDBE 的入口话题,也是 7.3 节批量写入优化的前置。
⚠️ SQLite 的语法分析器对深度嵌套的表达式有限制,极端的几千层括号会触发解析栈保护直接报错。服务端数据库同样有各种解析深度限制,写生成 SQL 的工具时两边的限制都要查。
错误现场对照:三条流水线的报错风格
解析前端的差异最终都会投影到报错信息上。做跨库工具或排查线上问题时,把三家的"同名错误"对照着记,能省下大量查文档时间:
| 错误场景 | SQLite | MySQL | PostgreSQL |
|---|---|---|---|
| 表不存在 | no such table: events | Table 'db.events' doesn't exist | relation "events" does not exist |
| 列不存在 | no such column: mystery | Unknown column 'mystery' | column "mystery" does not exist |
| 语法错误 | near "FORM": syntax error | You have an error in your SQL syntax... | syntax error at or near "FORM" |
| 类型冲突 | datatype mismatch(运行期) | 严格模式报错或隐式转换 | 运算符不存在提示加显式转换 |
| 值数量不匹配 | 表有 N 列但提供了 M 个值 | Column count doesn't match value count | INSERT 有比表达式更多的目标列 |
两个系统性差异值得展开。类型检查的时机:SQLite 的类型系统是"列亲和性加存储类",类型不匹配大多要到运行期才暴露(比如把文本和数字比较时静默返回假),MySQL 在严格模式下写期拦截、非严格模式静默截断,PostgreSQL 在解析期就用类型系统把问题拦死——同一份 SQL 从 PG 迁到 SQLite,会有一批"PG 拦下的类型问题"变成线上静默行为差异。方言开关:MySQL 的 sql_mode 能改变解析行为(严格模式、ANSI 引号),SQLite 没有等价开关,行为由编译期选项决定——写迁移工具时前者的行为矩阵要按 sql_mode 展开成多列。
常见问题速答
**占位符和拼接 SQL,解析层到底差在哪?**拼接的输入进入词元流,单引号与关键字都能改变语法树的形状——注入的本质就是"数据被当成了语法"。占位符在解析时就是一个参数节点,绑定发生在编译完成之后,无论绑什么值都不可能改写已定型的字节码。所以"参数化防注入"不是最佳实践而是机制保证,任何绕过参数化直接拼 SQL 的框架特性(动态表名、动态排序字段)都要回到白名单校验。
本节要点回顾
- 三站流水:词法切分、LALR 语法归约、语义挂钩;SQLite 边解析边建表达式树,一站到底。
- 产物决定缓存价值:SQLite 缓存字节码,MySQL 与 PostgreSQL 缓存的是树与计划,依赖的会话状态更多。
- 语义检查时机不同导致错误形态不同,跨库工具要按三套规则分类错误。
- 解析本身不慢,慢的是不复用——预编译是比"精简 SQL"有效得多的手段。
下一节进入本章核心:字节码长什么样,VDBE 怎么跑它。