5.1 索引是怎么工作的
5.1 索引是怎么工作的:查找、范围扫描与排序消除
本节摘要:索引 B-Tree 与表 B-Tree 是两棵独立的树:索引叶子页存"被索引列的值加 rowid"。本节沿一棵真实的索引树走完点查与范围扫描的路径,解释 ORDER BY 为什么能被索引免费消除,并给出 WITHOUT ROWID 表这个改变"回表含义"的特殊形态。
从叶子页的内容说起
接着第 2 章的布局课。为 employees 的 dept_id 建索引后,磁盘上多出一棵树:
CREATE INDEX idx_emp_dept ON employees(dept_id); SELECT name, rootpage FROM sqlite_schema WHERE name LIKE 'idx%'; -- rootpage = 5,索引树从页 5 开始
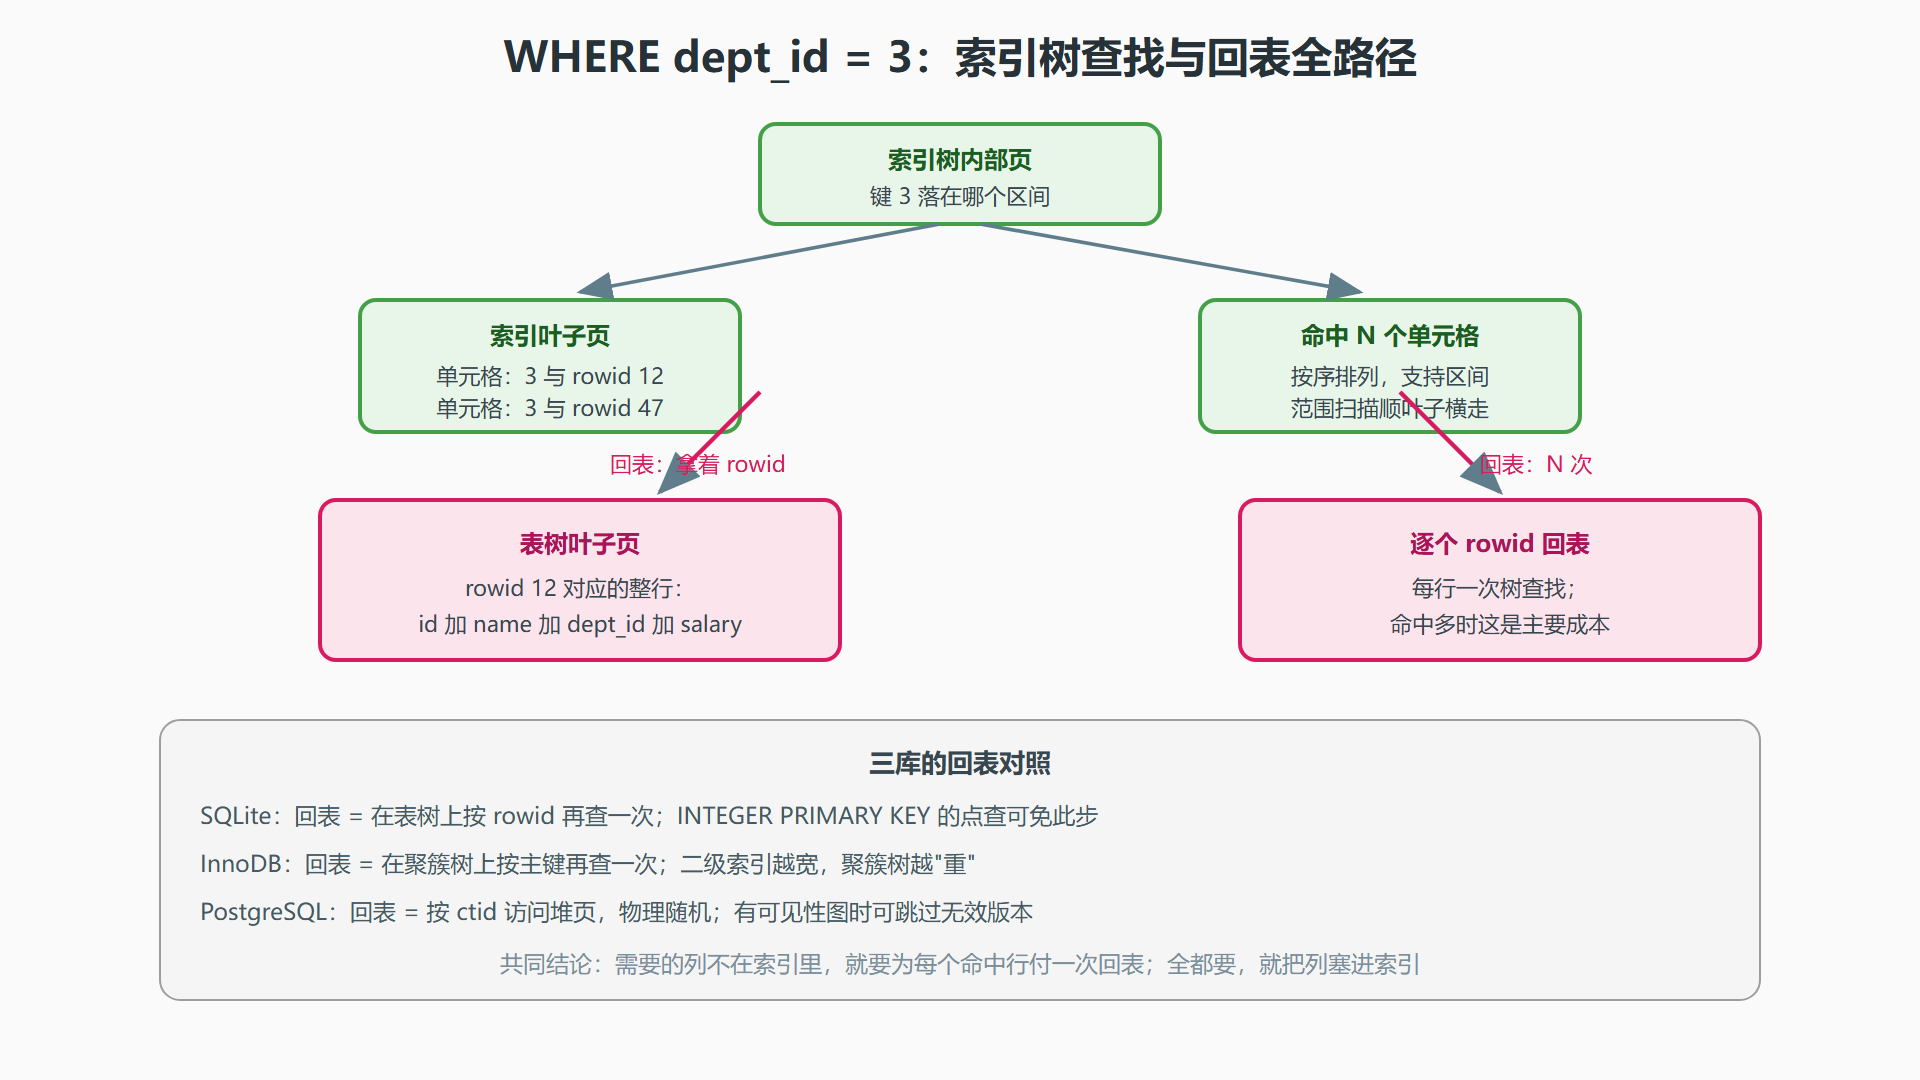
索引叶子页(类型码 10)的每个单元格是"键加 rowid":键就是 dept_id 的值加(多列索引时的)后续列值,rowid 指回表树。整棵树按键排序——这一句话是索引全部魔力的来源:磁盘上的随机数据被复制成了一份有序结构。点查 WHERE dept_id = 3 从"扫全表逐行比对"变成"在有序结构里二分定位",代价从线性降到对数;代价是每次写入都要同步维护这份有序副本(第 2 章算过的写入放大)。
图:索引查找路径与回表
范围扫描与排序消除
范围条件 WHERE dept_id BETWEEN 3 AND 5 把"一次定位"变成"一段横走":先 SeekGE 到键 3 的第一个单元格,然后沿叶子页的顺序指针横向推进,直到键越过 5(对应第 3 章见过的 SeekGE、IdxGT、Next 指令循环)。叶子页之间的顺序指针是 B+ 树区别于普通 B 树的关键设计,也是范围扫描高效的原因。
排序消除是范围扫描的免费赠品。WHERE dept_id = 3 ORDER BY salary 若有 (dept_id, salary) 复合索引,索引本身就是"部门内按薪水有序"的,优化器直接顺序读索引,ORDER BY 不再触发任何排序步骤——计划里不会出现 USE TEMP B-TREE FOR ORDER BY 字样。反过来,同样的查询只有单列索引时,就得先取出所有命中行再排序。这就是复合索引列顺序的黄金法则:等值条件列在前,排序列在后,范围条件列最后(它之后的列无法参与定位)。
💡 关键直觉:复合索引是"先按第一列分组排序、组内再按第二列排序"的电话簿。电话簿按(姓,名)排序,按姓查极快,按名查没辙——列顺序选错,索引形同虚设。
WITHOUT ROWID:换一种回表语义
普通表的索引叶子存 rowid,命中后还要回表树。SQLite 提供一种特殊形态把两棵树合一:
CREATE TABLE users( username TEXT PRIMARY KEY, email TEXT ) WITHOUT ROWID; -- 表本身就是按 username 组织的索引 B-Tree(页类型 2 与 10) -- 等价于 InnoDB 的按主键聚簇
WITHOUT ROWID 表里,主键之外的索引叶子存的是主键值而非 rowid,行为模式与 InnoDB 完全一致。适用判据很清晰:主键是 TEXT(如 UUID 或业务编号)且经常按主键点查时用它,省一次回表;反之 INTEGER 主键的表用默认 rowid 形态更优——rowid 树的单元格更小、树更矮。PostgreSQL 用户注意:PG 没有聚簇概念,它的 CLUSTER 命令只是一次性的物理重排,不要把 WITHOUT ROWID 理解成它的等价物。
索引的三笔成本账
收益讲完,把代价摆到台面上,索引决策是收益与三笔账的合订本:
| 成本 | 发生时机 | 量级估算 |
|---|---|---|
| 写入放大 | 每次 INSERT、UPDATE、DELETE | 每个索引多维护一棵树,宽索引翻倍更明显 |
| 存储占用 | 持续 | 索引总大小约为对应列宽加 rowid 再乘系数,多索引可超数据本身 |
| 计划负担 | 每次查询编译 | 索引越多,连接顺序搜索的候选组合越多 |
写入放大可以量化感受:一张带三个索引的表,单行插入实际要更新四个 B-Tree,页写入次数约为无索引时的三到四倍。存储账建议用 dbstat 定期核对:SELECT SUM(pgsize) FROM dbstat WHERE name LIKE 'idx_%' 与表本身的大小比一比,索引超过表本体是常见的配置失误信号。计划负担在大连接查询里显形——十几张表每张五六个索引,优化器的搜索空间瞬间膨胀,编译耗时肉眼可见地进入毫秒级。给查询建索引,而不是给列建索引:每建一个索引都要能说出它服务哪条查询、值多少写入税。
常见问题速答
**表达式索引是什么,什么时候用?**把函数或表达式作为索引键:CREATE INDEX idx_lower_email ON users(lower(email))。此后 WHERE lower(email) = ? 才能走索引——查询表达式与索引表达式必须逐字一致。PostgreSQL 用户对它不陌生,SQLite 从 3.9 起同样支持,MySQL 的函数索引在 8.0 后以隐藏列思路提供。用在"查询习惯无法改变、数据形态不配合"的场景,比如大小写不敏感的邮箱查找。
**现有索引够不够用,怎么系统评估?**两步。第一步列清单:SELECT sql FROM sqlite_schema WHERE type='index' 加 dbstat 的大小统计,得到每棵索引的定义与体积。第二步对账:把业务的核心查询清单逐条跑 EXPLAIN QUERY PLAN,凡是长期出现 SCAN 的大表查询,就是缺索引;凡是从未出现在任何查询计划里的索引,就是删除候选——用 DROP INDEX 定期清理无主索引,与清理死代码同一纪律。
本节要点回顾
- 索引是"键加 rowid"的有序副本树;范围扫描靠叶子页顺序指针横走。
- 回表是索引访问的隐性账单:SQLite 按回表树查找、InnoDB 按聚簇树、PostgreSQL 按物理堆访问。
- 复合索引列顺序黄金法则:等值在前、排序居中、范围殿后。
- INTEGER 主键用默认 rowid 表,TEXT 主键考虑 WITHOUT ROWID;它的行为等价于 InnoDB 聚簇。
**多列查询怎么共享一个索引?**靠"最左前缀"原则:复合索引(dept_id, salary)可以被"只按 dept_id 过滤"的查询使用,也可以被"dept_id 等值加 salary 范围"的查询完整使用,但单独按 salary 过滤用不上。这一原则三库通用,由此得出的实践是:把业务里成对出现的过滤列合成复合索引,避免为每列单建一棵树——查询覆盖与索引数量在这里可以兼得。