5.2 选择性与查询计划解读
5.2 选择性、ANALYZE 与 EXPLAIN QUERY PLAN 解读
本节摘要:建不建索引不该靠感觉。本节给出三个定量工具:选择性公式评估一列值不值得建索引;sqlite_stat1 表看清优化器眼里的世界;EXPLAIN QUERY PLAN 逐行精读——并用查询计划树把"为什么小表全扫反而快"讲成一道成本算术题。
选择性:一列值不值得建索引
选择性(selectivity)的定义是区分值数量除以总行数,取值在 0 到 1 之间,越接近 1 越好:
SELECT COUNT(DISTINCT dept_id) AS distinct_vals, COUNT(*) AS total, CAST(COUNT(DISTINCT dept_id) AS REAL)/COUNT(*) AS selectivity FROM employees; -- 假设输出:distinct_vals = 12, total = 50000, selectivity ≈ 0.00024
0.00024 的选择性意味着:用 dept_id 索引命中约 4100 行(50000 除以 12),每行还要回表一次——如果查询只取少数几列且命中行确实都要,索引仍然划算;如果命中率超过全表的百分之几,顺序扫描反而便宜。两个经验阈值:选择性低于百分之一的列,单独建索引基本是浪费;命中率超过全表百分之五的查询,优化器自己就会倾向全扫。性别列(两三个值)、状态列(五六个值)单独建索引都没意义,但把它们放进复合索引的第一列(等值条件)就能用——选择性不足的列当"过滤器前缀",后面的高选择性列负责真正的定位。
对比另外两家的同一概念:MySQL 的 cardinality(SHOW INDEX 输出)与 PostgreSQL 的 n_distinct(pg_stats 视图)本质都是这个公式的引擎侧版本,只是统计的采集时机与存储位置不同——SQLite 把统计放在 sqlite_stat1 表里,前两者放在各自的系统统计结构中。
ANALYZE:给成本模型喂情报
优化器不查数据本身,只看统计。没跑过 ANALYZE 的库,成本模型只能靠默认假设(索引估算行数常用对数衰减的保守公式),可能出现"明明该走索引却全表扫"的计划。跑一次:
ANALYZE; -- 全库扫描并写统计 SELECT * FROM sqlite_stat1; -- 看看它写了什么 -- tbl idx stat -- employees idx_emp_dept 50000 4167 -- events idx_dev_ts 10000000 25 1
sqlite_stat1 的 stat 列读法:第一个数是表估算行数,后面每个数是按该索引前缀查询时的平均命中行数。50000 4167 意思是 5 万行的表,按 dept_id 平均一次命中约 4167 行——优化器看到这个数,自然会对"按部门查询取全部列"的计划犹豫。三库对照:PostgreSQL 还会存直方图(most_common_vals 与 most_common_freqs),能识别"某个部门占一半员工"这种偏斜分布;MySQL 有字典统计与持久化统计;SQLite 的 stat1 只有平均数,对偏斜分布无能为力——如果 dept_id=3 恰好占 90% 的行,SQLite 仍按平均 4167 行估算,这是它优化器的已知短板,应用层要靠查询改写补偿。
EXPLAIN QUERY PLAN 逐行精读
把一条带连接与排序的查询放上手术台:
EXPLAIN QUERY PLAN SELECT e.name, d.dept_name FROM employees e JOIN departments d ON e.dept_id = d.id WHERE d.region = 'CN' ORDER BY e.salary DESC LIMIT 10; -- QUERY PLAN -- |--SEARCH d USING INDEX sqlite_autoindex_departments_1 (id=?) -- |--LIST SUBQUERY 1 -- |--SCAN e -- `--USE TEMP B-TREE FOR ORDER BY
读法四步:第一步看每行的动词——SEARCH 表示按索引定位,SCAN 表示顺序扫描;第二步看访问顺序(树的缩进,上层驱动下层,这里是先扫 e 再对每个 e 查 d,或相反);第三步看 USING 后面的索引名,确认是不是你预期的那棵;第四步找额外工作——USE TEMP B-TREE FOR ORDER BY 说明排序没被索引消除,TEMP B-TREE FOR GROUP BY 同理,RIGHT-FULL-HINT 之类标记则提示连接方式。理想计划的样子是"少 SCAN、多 SEARCH、无 TEMP B-TREE"。
图:查询计划树与两条路线的成本对比
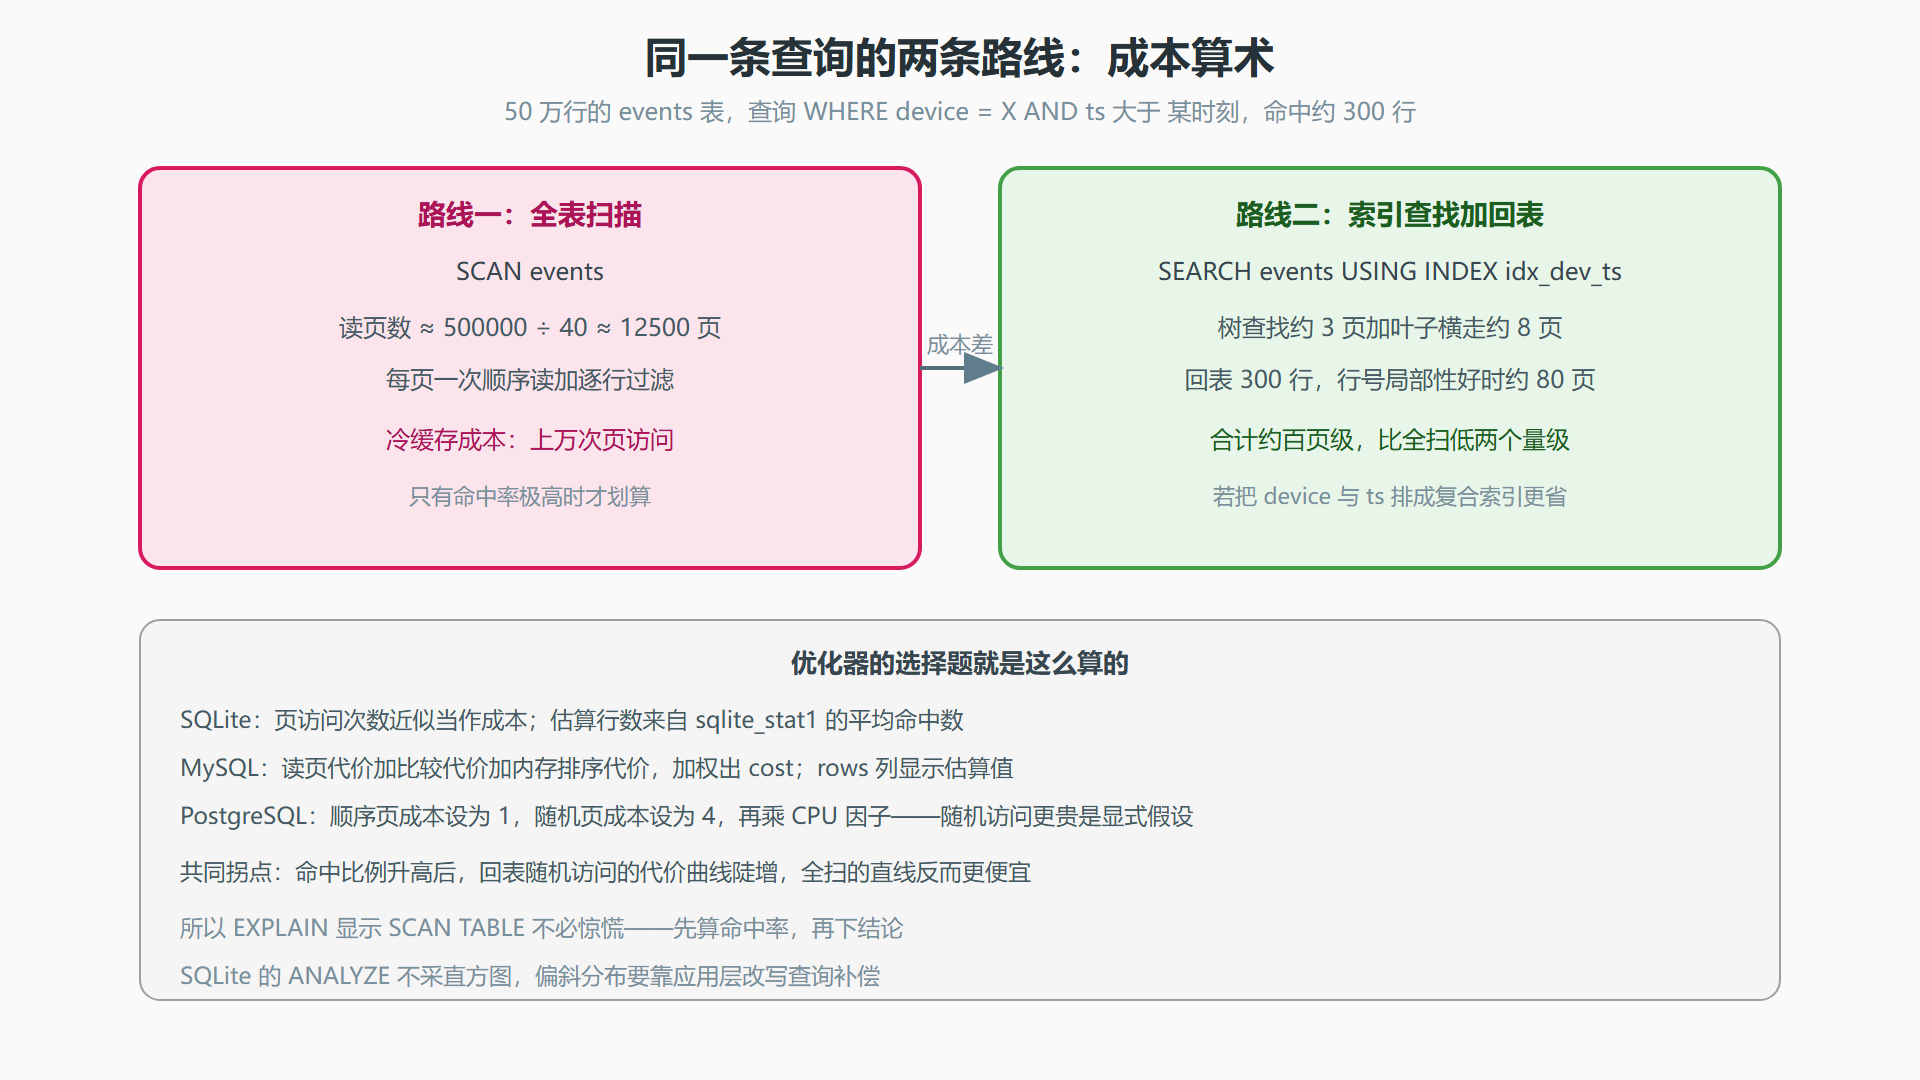
小表全扫反而快:把账算给优化器听
一个经典反例:200 行的配置表,status 上有索引,查询命中 60 行。索引路线要"3 页树查找加 60 次回表",回表按最坏情况是 60 次随机页访问;全扫路线只要 200 除以每页 50 行等于 4 页顺序读。SQLite 的成本模型按页访问次数比较,会正确地选择全扫——此时手工 FORCE INDEX 式的强推(SQLite 没有强制索引语法,只能 INDEXED BY)反而更慢。三库都有这个"命中率拐点",位置各不相同(PostgreSQL 的随机读代价系数让它拐得更早)。判读计划的正确姿势永远是:先算命中率,再看计划动词。
常见问题速答
**ANALYZE 要多久跑一次?**按数据变化率定,不看日历。批量导入、大批删除、数据分布明显变化(某分类突然激增)之后跑一次;日常插入占主体的库,几周一次足够。3.4x 版本起 PRAGMA optimize 提供了轻量替代——它在连接关闭时按需做增量统计更新,官方建议每个连接关闭前调用一次,作为 ANALYZE 的日常补充而非替代(重大数据变更后仍应手动全量 ANALYZE)。
**INDEXED BY 什么时候用?**SQLite 提供的强制语法 FROM t INDEXED BY idx_name,计划与索引钉死,找不到匹配索引直接报错——比 hint 严厉(MySQL 的 FORCE INDEX 找不到还有退路)。适用场景很窄:优化器在偏斜分布上反复选错、且你已用数据证明某索引更优时,作为临时止血;长期方案永远是改统计或改查询。日常给所有查询都加 INDEXED BY 是反模式——它把优化器降级成了复读机,分布变化后旧选择变成新瓶颈。
本节要点回顾
- 选择性 = 区分值数 ÷ 总行数;低于百分之一的列别单独建索引,但可当复合索引前缀。
- ANALYZE 写出 sqlite_stat1;stat 列第一个数是行数,后续是各索引前缀的平均命中行数。
- SQLite 统计无直方图,偏斜分布要靠改写查询补偿;PostgreSQL 有直方图,MySQL 有持久统计。
- 读计划四步:看动词(SCAN 或 SEARCH)、看顺序、看索引名、找 TEMP B-TREE;SCAN 不等于坏计划,先算命中率。
普通索引解决"精确与范围",全文检索是另一片战场。下一节对照三库的倒排方案。