5.3 全文与倒排对照
5.3 全文与倒排:FTS5 对照 MySQL ngram 与 PostgreSQL GIN
本节摘要:
LIKE '%关键词%'用不上任何普通索引,因为前缀通配让 B-Tree 的有序性失效。全文检索的答案是倒排索引:把文本拆成词,建"词到行"的映射。本节拆解 SQLite FTS5 的倒排结构,对照 MySQL 的 ngram 全文索引与 PostgreSQL 的 tsvector 加 GIN,给出三库全文方案的选型对照表。
LIKE 为什么慢,倒排为什么快
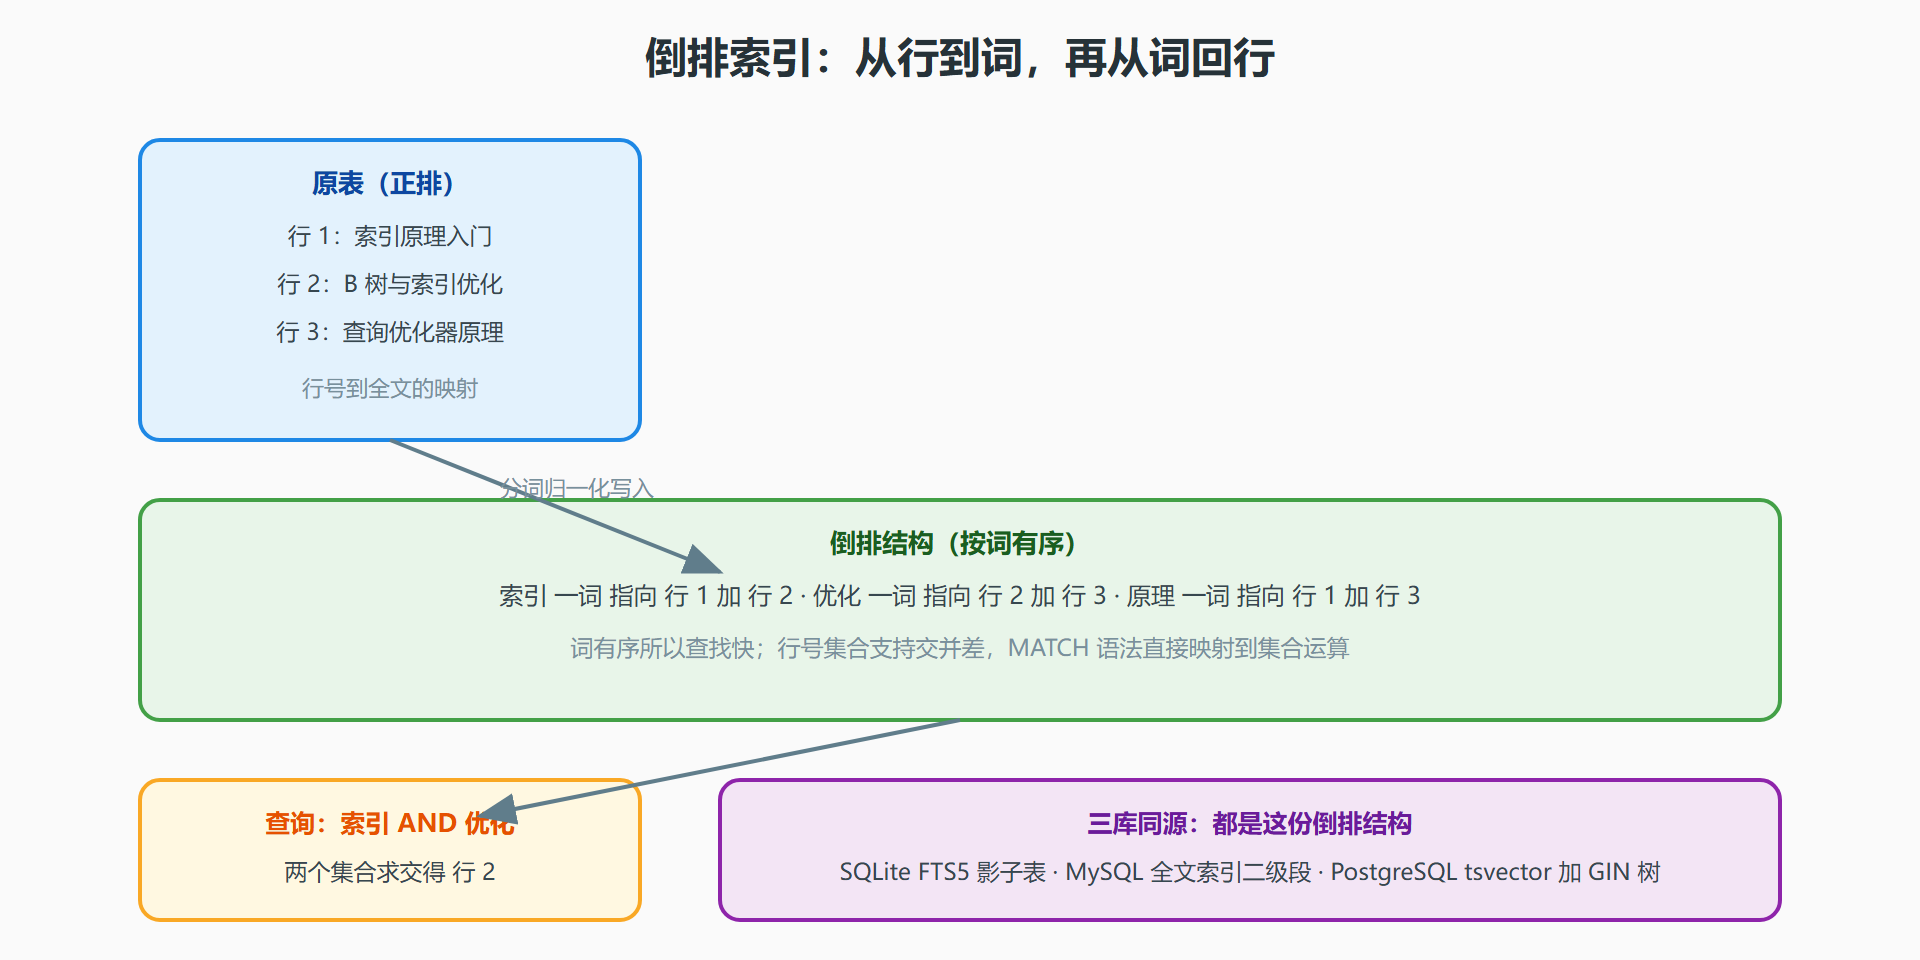
WHERE title LIKE '%数据库%' 的困境在有序性:B-Tree 按"从首字符起逐位比较"排序,前缀通配符让优化器无法确定起点,只能全扫逐行匹配。全文索引换了思路——不再问"每行含不含这个词",而是提前算好"每个词出现在哪些行":
-- SQLite:建一张 FTS5 虚拟表 CREATE VIRTUAL TABLE docs_fts USING fts5(title, body); INSERT INTO docs_fts(rowid, title, body) SELECT id, title, body FROM docs; SELECT title FROM docs_fts WHERE docs_fts MATCH '数据库 AND 索引'; -- MATCH 语法支持 AND、OR、NOT、NEAR 与短语匹配 "核心 索引"
FTS5 的存储是一系列影子表(名字形如 docs_fts_data、docs_fts_idx):词经过分词器切分与归一化后,词与行号的关系按段(segment)写入倒排结构,查询时在段内二分定位词,取出行号集合做交并差。写入时新内容先进小段,后台自动合并(merge)——这正是 LSM 树式的分层合并思想在倒排索引上的翻版。
图:倒排索引的构建与查询
三库方案对照
同一个"文章搜索"需求,三家的方案与取舍:
| 维度 | SQLite FTS5 | MySQL 全文索引 | PostgreSQL tsvector + GIN |
|---|---|---|---|
| 启用方式 | 建虚拟表,随库走 | FULLTEXT 索引(InnoDB) | 表达式索引存 tsvector |
| 中文分词 | unicode61 默认不切中文,需自定义分词器或 ICU | 内置 ngram 可切中文 | 需扩展插件或外部预处理 |
| 查询语法 | MATCH 加布尔运算、NEAR、权重 | MATCH AGAINST 布尔与自然语言模式 | to_tsquery、websearch 语法 |
| 排序相关性 | bm25() 函数可定制权重 | 内建相关性排序 | ts_rank 加 ts_rank_cd |
| 高亮与片段 | highlight 与 snippet 内置 | 无内置,应用层做 | ts_headline 内置 |
| 更新成本 | 增量入段加自动合并 | 缓冲合并,后台归并 | 写时即更新 GIN(可延迟) |
选型逻辑跟着部署形态走:应用内嵌搜索(笔记软件、聊天记录、设备日志)FTS5 是事实标准,数据不出进程,bm25 排序加 snippet 高亮开箱即用;服务端 MySQL 已在位且只做"还不错的搜索",FULLTEXT 够用;搜索是核心功能(站内搜索、文档库),PostgreSQL 的 tsquery 表达力加外部专用搜索引擎的组合更常见。中文是三家的共同短板:FTS5 默认分词器把整句中文当单一词元,必须配自定义分词器(把分词库编译进应用)或预处理成空格分隔的词序列再入库——这步做不做,搜索质量天差地别。
FTS5 的三个实用细节
一,外部内容表模式。数据已经存在于普通表时,FTS5 可以只存倒排不存正文:
CREATE VIRTUAL TABLE docs_fts USING fts5( title, body, content='docs', content_rowid='id' ); -- 触发器同步:插入、更新、删除时维护倒排 CREATE TRIGGER docs_ai AFTER INSERT ON docs BEGIN INSERT INTO docs_fts(rowid, title, body) VALUES (new.id, new.title, new.body); END;
省一半存储,代价是要自己写同步触发器。二,bm25 权重。bm25(docs_fts, 10.0, 1.0) 把标题列的命中权重放大十倍,站内搜索的"标题命中排前面"一个参数搞定。三,前缀查询。MATCH '数据*' 走词前缀匹配,实现搜索框联想;比 LIKE 快得多,因为倒排本身就是有序的。
对照地看,MySQL 与 PostgreSQL 的全文索引同样各有"更新缓冲、后台归并"的机制——倒排索引的写入永远是批量的,这条规律三库通用。实时性要求极高的场景(聊天消息即时可达)要在应用层设计兜底,比如新写入直接查原表、几秒后再并入全文结果。
常见问题速答
**FTS5 能搜索附件里的 PDF 或 Word 内容吗?**能,但提取在库外完成。FTS5 索引的是文本列,任何内容先由应用抽取成纯文本(PDF 解析、办公文档转换),再连同元信息插入 FTS5 表——抽取与索引是两个独立环节。设计上常见"双表结构":普通表存原始二进制与元数据,FTS5 表只存抽取后的文本,用外部内容表模式(content 选项)或触发器保持同步。检索命中后回普通表取原件即可。
**中文搜索乱码或搜不到词,先查什么?**按顺序查三件事。第一,分词器:unicode61 对中文整句切分,"数据库"三个字是一个词元,搜"数据"就命不中——需要自定义分词器或预处理。第二,查询侧:MATCH 语法里的中文串要与词元形态一致,预处理入库的方案在查询侧也要做同样的预处理再 MATCH。第三,编码一致性:入库与查询的文本编码不同会静默失配——FTS5 不报错,就是查不到。三步走完仍异常,用 SELECT * FROM docs_fts_vocab(词汇表虚拟表,需显式创建)看看词元实际长什么样,倒推是哪一环的分词问题。
本节要点回顾
- 前缀通配的 LIKE 无法利用 B-Tree 有序性;倒排索引把"逐行匹配"换成"查词取行"。
- FTS5 是影子表加 LSM 式段合并;MATCH 的布尔运算就是行号集合的交并差。
- 中文分词是三库共同短板:FTS5 要自定义分词器,MySQL 用 ngram,PostgreSQL 靠插件或外部预处理。
- 内容表模式省存储,bm25 参数调相关性,前缀查询做联想——FTS5 的三件常用武器。
索引讲完,下一章看优化器怎么在所有索引与连接顺序里做选择题。