1.2 发展历程与里程碑
1.2 发展历程与里程碑
上一节把向量、嵌入、近邻搜索这些概念立了起来,本节顺着时间线看它们是怎么长成一整个数据库品类的。历史不只是年表:今天每个系统里的设计取舍——为什么 HNSW 成了默认选项、为什么量化总跟索引捆绑出现、为什么独立向量库忽然在几年间爆发——都能在演化路径里找到原因。
先记住这条主线
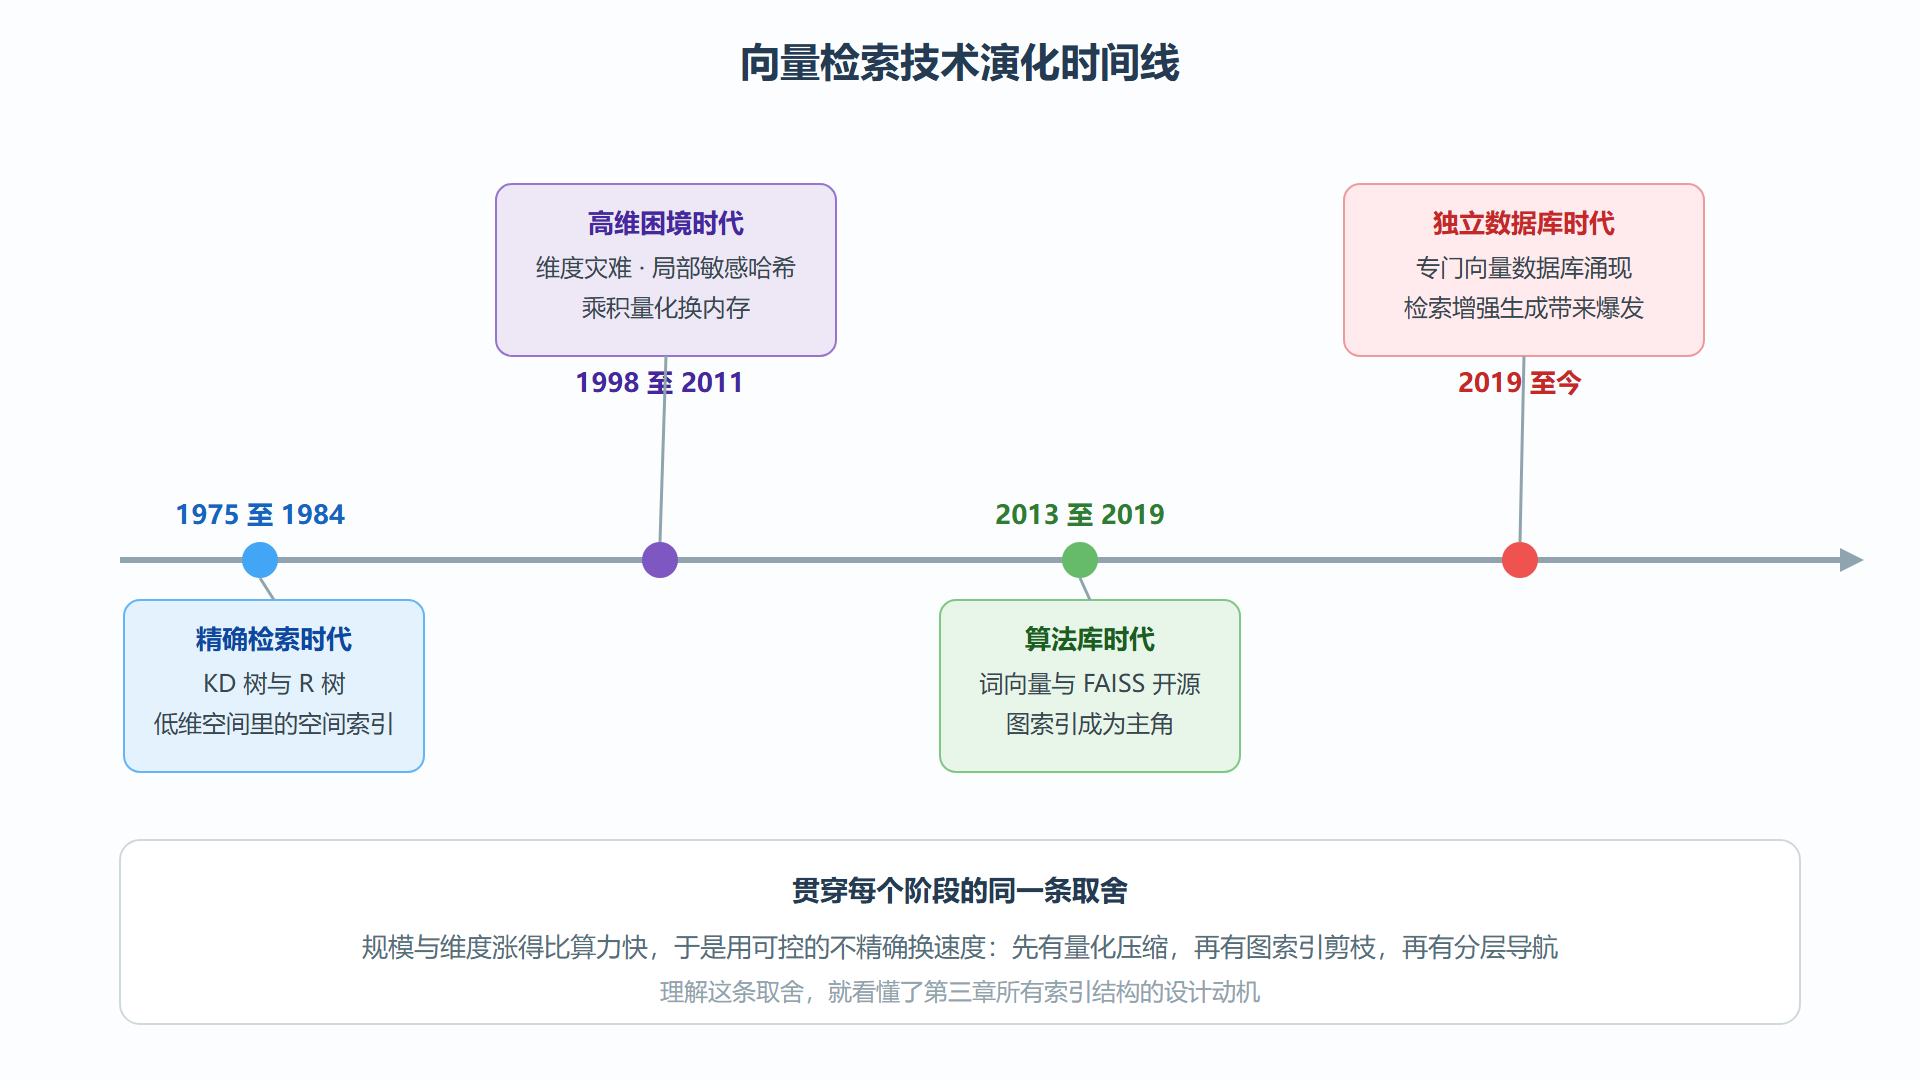
四十多年的历史可以压缩成四个阶段:精确检索时代先在低维数据上把树形索引打磨成熟;高维困境时代撞上"维度灾难"这堵墙,研究重心转向概率化的近似算法;算法库时代由开源库把论文变成可复用的代码资产;独立数据库时代则把库升级成带存储、副本、过滤、分布式能力的完整设施,并在大模型浪潮里成为标配组件。阶段之间的推进动力始终是同一条矛盾:数据规模与维度涨得比硬件算力快,于是只能用"可控的不精确"换速度。
图 1-1 向量检索技术演化时间线
阶段拆解:每一步在解决什么
精确检索时代。 KD 树在坐标轴上递归切分空间,R 树用嵌套矩形管理地理数据,它们在二维到十几维的数据上效率极高,至今仍在地理信息系统里服役。这一时代留下的遗产是"空间划分"这个思想:把空间切成小块,查询时整块整块地剪枝。但它埋着一个隐患——切分的收益依赖于"维度不太高"这个前提,而这个前提很快就被打破了。
高维困境时代。 当维度涨到上百,树形索引的剪枝能力急剧退化,极端情况下退化为逐点比较,这是维度灾难最工程化的表述。研究者给出的回应分两条路线:局部敏感哈希用一组随机哈希函数把相近的向量以更高概率投进同一个桶,查询时只扫命中的桶,用概率保证换计算量;乘积量化则从另一个方向下手,把长向量切成若干段、每段用聚类中心编码压缩,让上亿条向量能塞进一台机器的内存,距离用量化后的近似值快速估计。这两条路线——哈希化与量化——至今仍是索引设计的基本武器,第三章会逐一拆解。
算法库时代。 词向量的流行让"每个词是一个向量"成为常识,也第一次让工程师需要在百万级词汇表上做近邻查询。这一阶段的主角从论文变成开源库:Faiss 把量化与图索引打包成工业级实现,Annoy 用多棵随机投影树证明了轻量方案的价值,hnswlib 把分层可导航小世界图做成了事实标准。这一时代的遗产是"算法可以即插即用"——但它仍是库而不是数据库:没有持久化保证、没有并发写入的并发控制、没有过滤与多租户,数据一重启就要重新加载。
独立数据库时代。 把库补齐成数据库需要补的东西恰恰最多:写前日志与崩溃恢复、标量过滤、分布式分片副本、增量索引维护。专门向量数据库在这个时期陆续出现,传统数据库阵营也纷纷加入向量列与近似索引。真正引爆需求的是大模型:检索增强生成把"从私域文档里找相似段落喂给模型"变成了几乎所有企业 AI 应用的标配步骤,向量检索从搜索团队的专用技术变成了平台基础设施。第六章的选型对比,就是对这一时代格局的快照。
从演化里读出的规律
把年表摆齐之后,有几条规律值得单独拎出来。其一,算法先行,工程滞后:分层可导航小世界图的论文发表后多年才成为默认选项,从算法提出到工程标配的滞后是常态,评估新技术时应对这个滞后有预期。其二,每次形态跃迁都是为了补上一类系统能力:库到数据库补的是持久化与并发,单体到分布式补的是水平扩展,而今天讨论的服务化与存算分离,补的是弹性成本。其三,负载定义形态:检索增强生成的负载是"写一次、读海次、允许轻微过时",这推动系统把重心从写事务挪向读吞吐和内存效率;如果明天主流负载变成高频更新,形态还会再变。读第三章的索引、第四章的架构时,可以随时回到这三条规律对照。
里程碑速查表
| 时间 | 里程碑 | 留下的遗产 |
|---|---|---|
| 上世纪七十到八十年代 | KD 树、R 树 | 空间划分与剪枝思想 |
| 上世纪九十年代末 | 局部敏感哈希 | 概率化近似的理论基础 |
| 2011 年前后 | 乘积量化 | 高维向量的压缩编码范式 |
| 2016 年前后 | 图索引论文与实现成熟 | 导航跳跃成为主流加速方式 |
| 2017 年前后 | Faiss 开源 | 工业级算法库的标准化 |
| 2019 年之后 | 专门向量数据库涌现 | 持久化、过滤、分布式齐全 |
| 2022 年之后 | 检索增强生成爆发 | 向量检索成为平台标配 |
为什么图索引笑到了最后
三条技术路线的竞争史里有个值得琢磨的问题:哈希、树、图都曾有机会,为什么分层图索引成了多数场景的默认选项?答案藏在"距离比较的次数"里。哈希方案的查询成本取决于桶的命中数,但桶内候选的质量受随机性拖累,高召回要求大量哈希表并行,内存随之膨胀;倒排方案的成本取决于簇的粒度,簇划得细则边界模糊的查询漏检,划得粗则簇内扫描量大;图索引则把成本精确地花在"离查询最近的路径"上——每一步跳跃都朝更近的方向走,同样的距离计算预算下,图索引拿到的召回最高。换句话说,图赢在"预算的利用率",而不是某个单点技巧。
这个结论对今天的意义在于:图索引的优势区间是"内存装得下、更新不算极端频繁"的主流场景,而它吃内存、怕高删的弱点,恰好是量化和磁盘索引两路线的生存空间——3.2 的对比矩阵就是这段竞争史的定格。
两个常见误判
误判一:新算法出来就该换。 演化史的滞后规律提醒我们,从论文热度到工程可用平均要以年计。看到新索引技术的正确反应是记入 7.3 的观察清单并用四问模板评估,而不是立刻替换生产索引——替换的迁移与验证成本,往往比新算法省下的延迟贵得多。
误判二:历史阶段会整体取代。 树形索引并没有死,它在地理信息与低维数据里活得很好;哈希方案也在特定带宽受限场景里服役。每个阶段的遗产都在流水线下游沉淀,理解这点能帮你避免"全量押注单一路线"的架构赌局:混合使用多条路线(比如量化粗筛加图索引精查)往往比单一路线的极限更划算。
本节要点回顾
- 四个阶段:精确检索、高维困境、算法库、独立数据库,推进动力始终是规模与算力的矛盾。
- 维度灾难让树形索引在高维失效,逼出了哈希与量化两条近似路线。
- 库与数据库的分界不在算法,而在持久化、并发、过滤与分布式这些系统能力。
- 大模型与检索增强生成把向量检索推成了平台级基础设施。
- 负载定义形态:读懂业务负载特征,就能预判系统设计重心。
时间线看完,下一节回到业务侧,把这套技术的典型用武之地逐一过一遍,并完整拆解一个以图搜图的落地案例。