- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
VectorDB向量数据库通用技术 · 教程导读
别以为向量数据库只是"能存数组的 MySQL"。把文本、图片或用户行为交给嵌入模型,得到的是高维空间里的坐标点;真正难的在于,当坐标点多到以亿计时,还能不能在毫秒级延迟内把最像的几条找回来。向量数据库的全部价值就落在这里:把"相似"这种只可意会的直觉,变成可索引、可调优、可按召回率与延迟计价的基础设施能力。这本教程讲的就是这套能力从原理到落地的完整链路。
为什么现在值得系统学一遍
大模型把检索增强生成变成了标配:模型负责生成,向量库负责"想起"。推荐系统把候选召回从标签匹配换成向量召回;内容平台靠它做去重和以图搜图;企业知识库靠它把散落在各处的文档变成可问答的资产。这些场景背后是同一组技术问题——向量怎么生成、距离怎么算、索引怎么建、过滤怎么做、集群怎么扩、召回怎么评估。零散地看博客能学会几个参数怎么填,但排障时会发现每个参数背后都有几何与系统两层含义,不成体系很容易调错方向。这本教程的目标,是把这组问题一次性讲透。
全册怎么组织
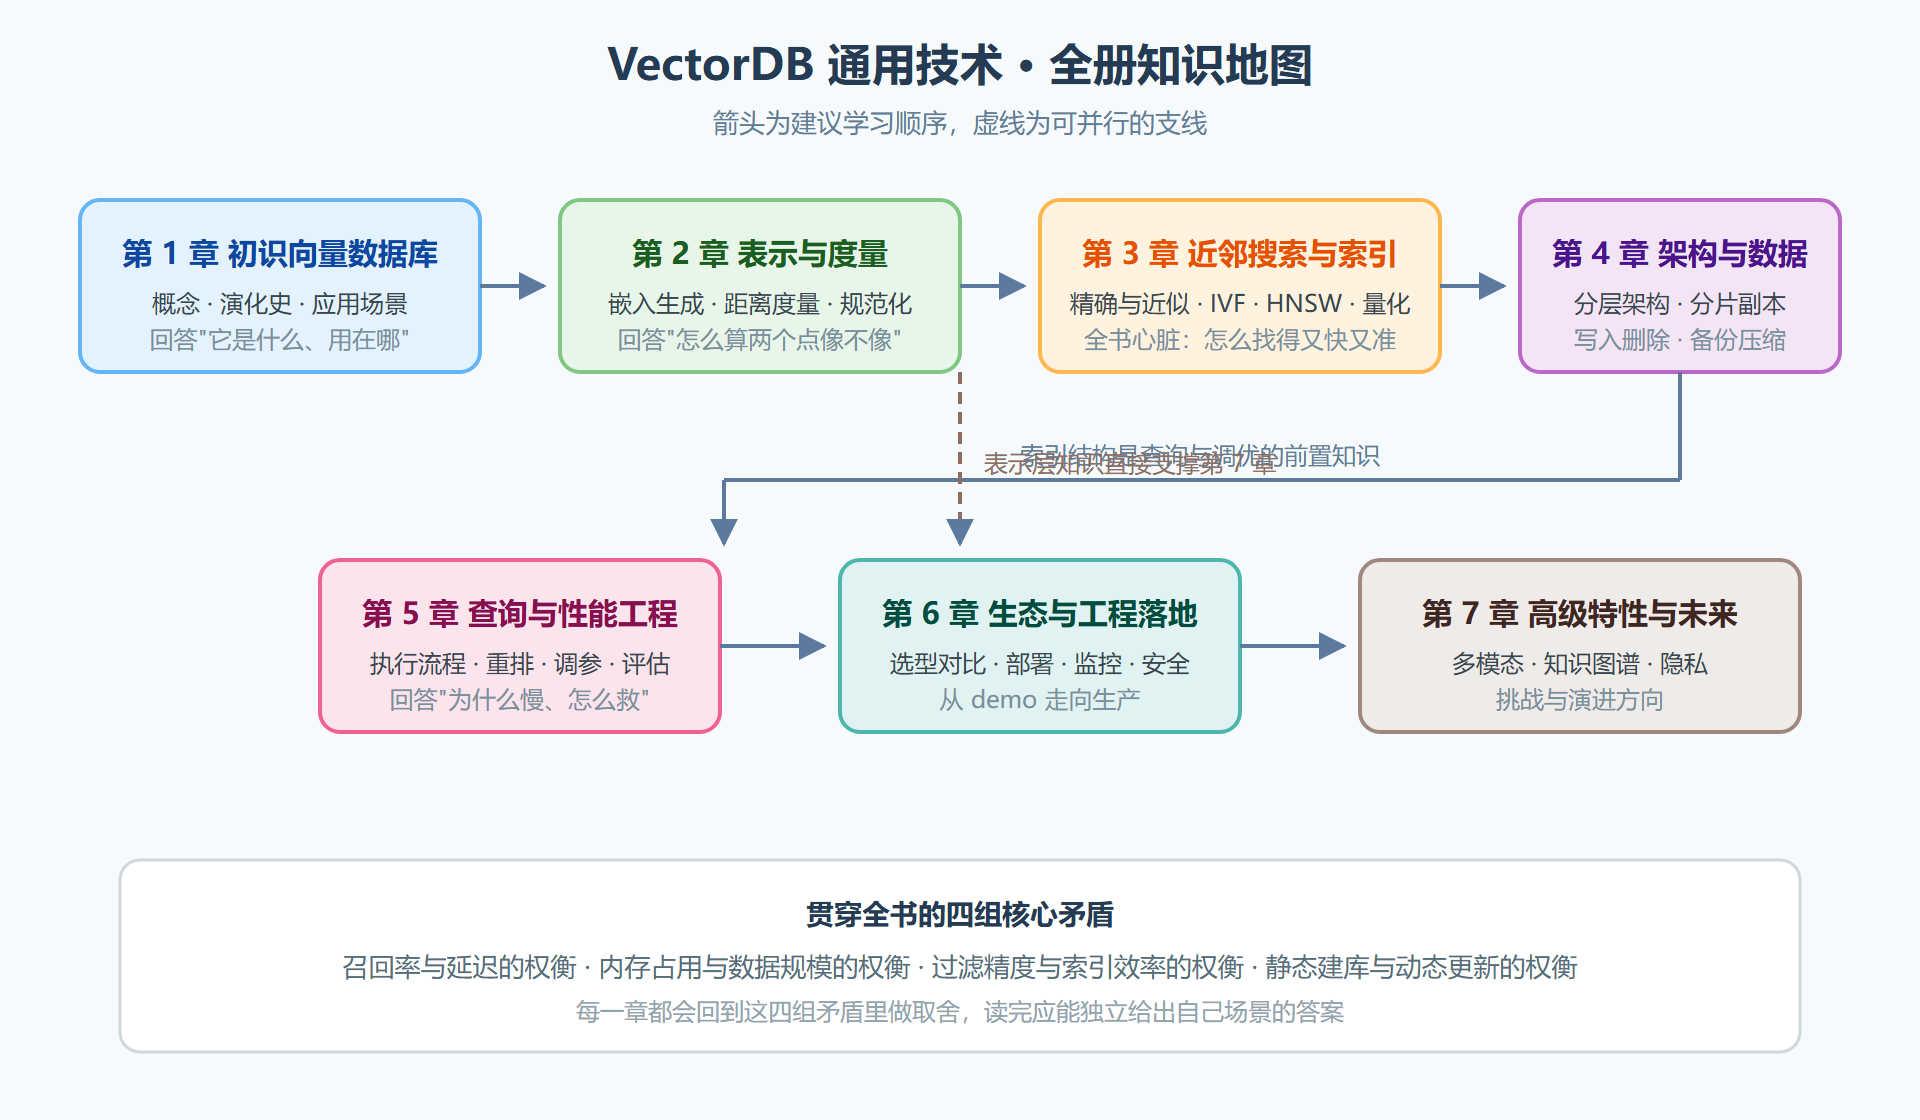
全书七章,走一条"先会算、再会存、再会查、最后会运营"的主线。第一章建立概念底座:什么是嵌入、什么是近邻搜索、典型场景长什么样,并回顾这条技术线从学术算法到独立数据库品类的演化。第二章进入表示层:嵌入怎么生成,内积、欧氏距离、余弦相似度各自适合什么数据,规范化预处理为什么能省掉一半坑。第三章是全书的心脏:近似最近邻搜索的算法版图,从暴力检索的复杂度墙,到 IVF、HNSW、量化与图索引的取舍逻辑,再到索引的构建与动态维护。第四章抬升到系统视角:整体架构分层、分片与副本、写入更新删除的语义、持久化备份与压缩。第五章回到查询侧:一次检索在引擎内部的执行流程、后处理与重排、参数怎么调、硬件怎么用、效果怎么量。第六章面向决策:主流开源项目与云服务的选型对比、部署模式、监控指标与安全合规,并完整复盘生产案例。第七章看向边界:多模态与知识图谱融合、隐私保护、当前挑战与未来方向。
图 0-1 全册知识地图与学习路径
读完你能拿到什么
按顺序学完,你应当能独立完成这些事:为一个新场景选择合适的相似性度量并说出理由;在千万级向量上选型索引结构,给出 HNSW 或 IVF 的参数初值并用召回率验证;读懂一次检索在引擎里的完整执行路径,把 P99 延迟从数百毫秒压到两位数毫秒;设计分片与副本方案,让写入和平滑扩容不中断服务;在生产环境里配置监控、备份与权限,并在事故复盘时说清是索引、过滤还是硬件的问题。每章末尾的要点回顾就是这些能力的验收清单。
怎么读这本教程
赶进度的读者可以走最短路径:第一章、第二章、第三章、第五章,这条线覆盖从建索引到调优的闭环;负责选型或架构评审的读者,建议先读第四章和第六章,再回头补算法细节;所有示例代码都以通用 API 风格书写,不绑定某家产品,思路可以直接迁移到任何主流向量数据库。章节之间用"详见第几章"的方式互相引用,正文不依赖外部链接。学习时建议边读边跑:先造几万条随机向量,再亲手把召回率和延迟量出来,比读十遍参数表都管用。
还有一个贯穿全书的读法提示:每一章的案例都刻意带着"不完美"——毛刺、暗降、翻车与复盘,那是工程知识真正的生长处。读到这些段落时别跳过,把它们当作自己系统的预演:事故在书里见过一遍,在生产里就会镇定许多。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...