3.2 主流索引结构
3.2 主流索引结构
上一节的实验说明逐点比较不可持续,本节回答"那该用什么"。承接 3.1 的墙,本节把工业界在用的索引结构按三条技术路线组织——空间划分、图导航、码本压缩——每一条都讲清它的直觉、代表结构、关键参数与代价,最后用一次真实的构建加查询会话把它们串起来。这张版图是第五章调参的语义底座:所有索引参数,都是本节某个结构性质的名字。
路线一:空间划分——先圈地再精查
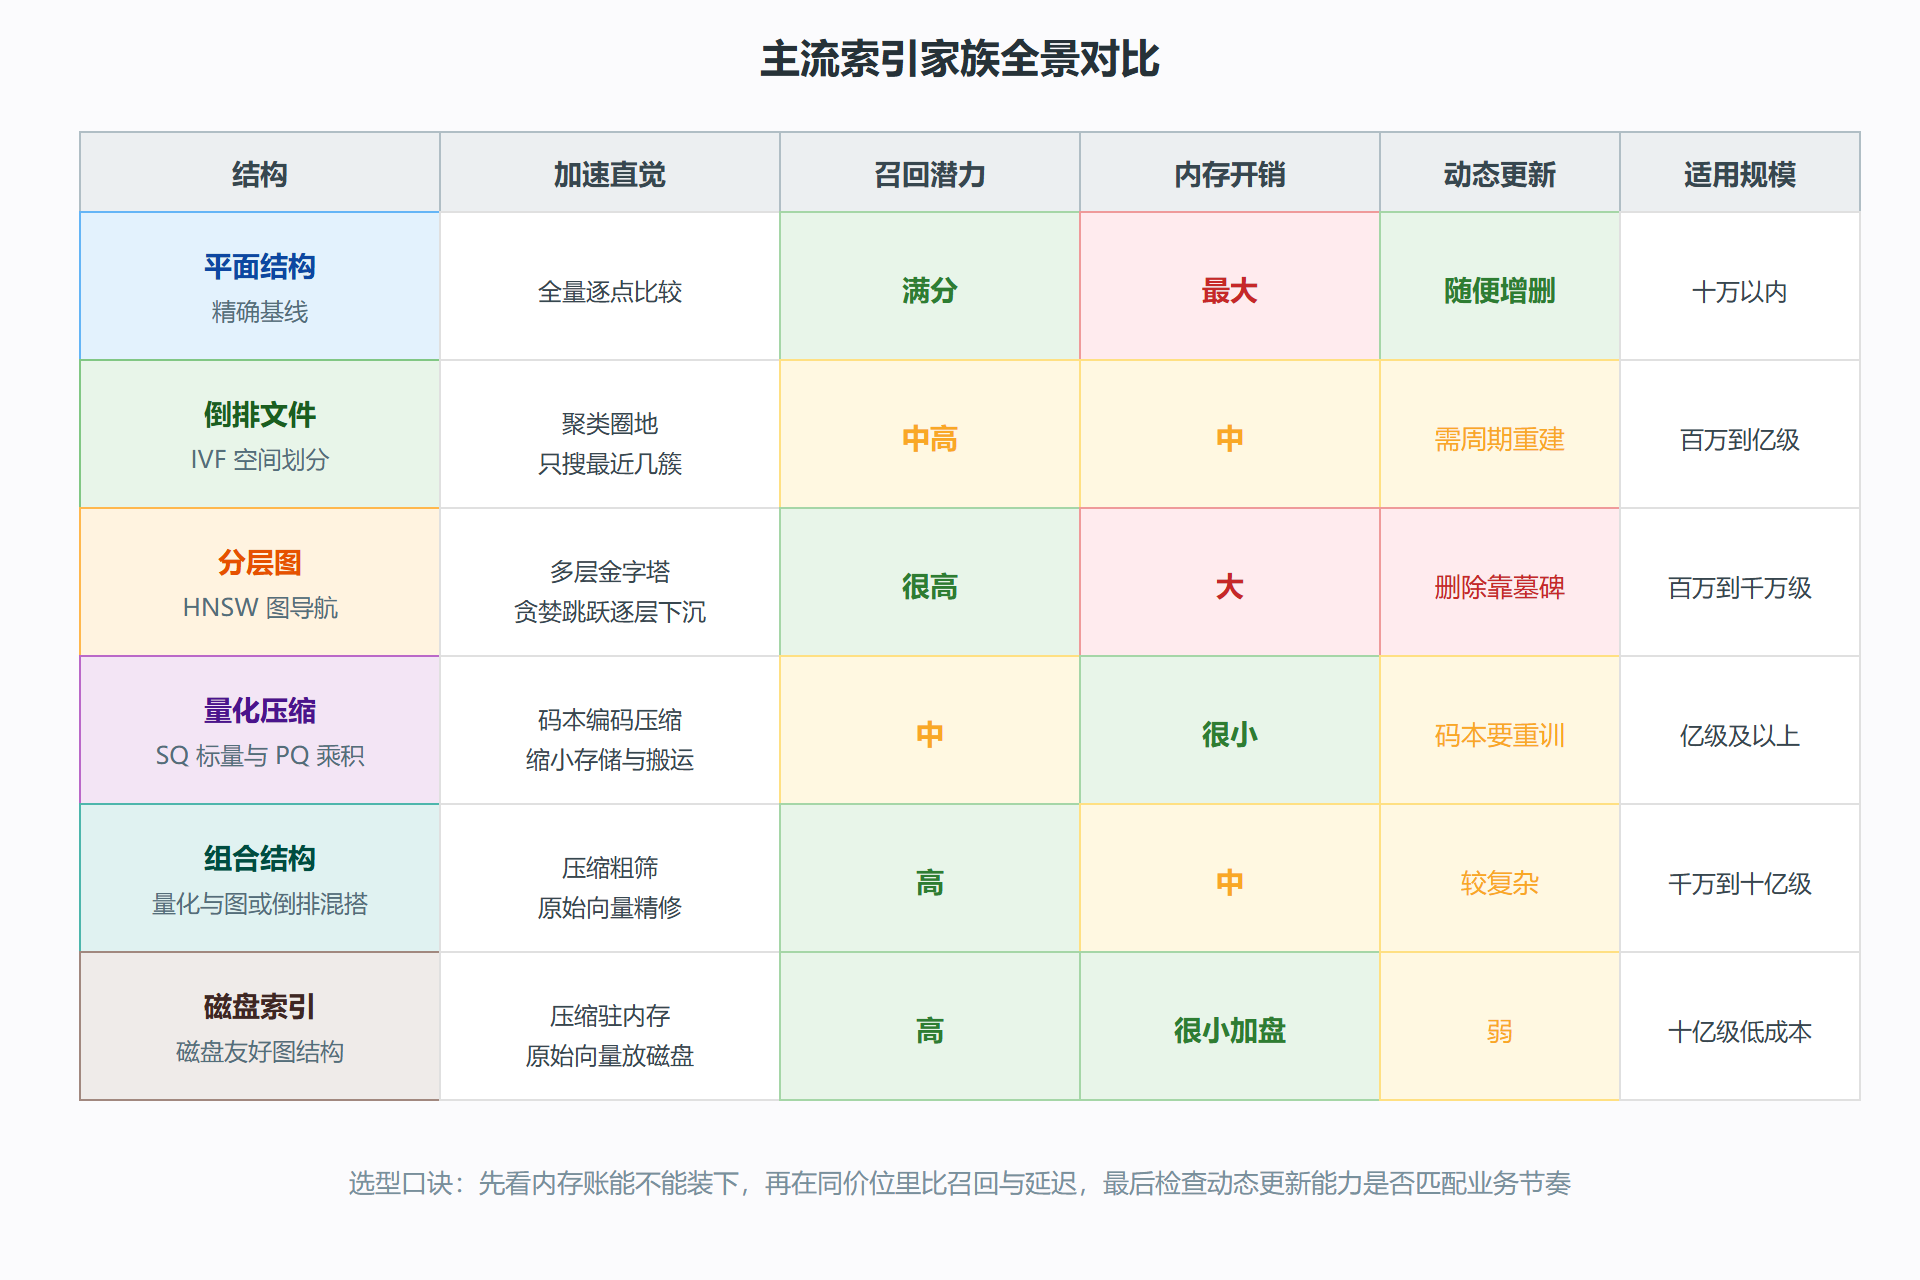
最直白的加速思路:把向量空间预先划成许多小区,查询时只搜最可能命中的几个区。代表结构是倒排文件索引(常写作 IVF):建索引时对全体向量做聚类,得到成百上千个簇心,每个向量挂到最近的簇;查询时先找出离查询向量最近的若干个簇心,只在这些簇里做精确比较。于是"全量扫描"变成了"扫描几个簇",工作量从 n 降到 n 的若干分之一。
它引入两个参数:聚类数决定切得多细,探测数决定每次查几个簇。两者配合就是这把天平的两端——探测数拉满等于退回暴力(全准全慢),探测数过小则真命所在的簇可能根本没被访问(快但错得多)。另一个隐性代价在数据分布漂移:聚类中心是建库时定的,数据分布大变后簇的负载会失衡,部分簇过大拖慢查询,这是 3.3 重建话题的伏笔。
路线二:图导航——顺着邻居跳跃
第二条思路不划分空间,而是让向量之间直接"认识":预先为每个点连上若干条到近邻的边,查询从任意入口出发,每一步跳到"已访问邻居里离查询最近的点",直到没有更近的跳头为止。代表结构分层可导航小世界图(HNSW)在这上面加了一层巧思:把图组织成多层金字塔,顶层稀疏、边长(跨越大范围),底层稠密、边短(精细局部),查询从顶层开始快速逼近大致区域,逐层下沉做精细导航——直觉上像先上高速公路、再下国道、最后走巷子。
HNSW 的关键参数是连接度 M(每点连几条边)与搜索候选队列长度 ef(每层保留多少候选继续扩展):M 与 ef 越大召回越高、内存与延迟也越高。它的高召回与低延迟让图索引成为大多数中小规模场景的默认选择,代价是内存开销最大(要存边),且删除处理麻烦——删点会破坏图的连通性,通常只能打墓碑标记,堆多了召回悄悄劣化,又一条通往 3.3 的伏笔。
路线三:码本压缩——把向量变小
前两条路线解决"查得快",第三条解决"装得下"。标量量化(SQ)把每个维度的单精度浮点压成八位整数,内存立省四分之三,距离在解压近似下计算;乘积量化(PQ)更进一步,把 d 维向量切成若干子段,每段用聚类学出一个小编码本,向量只需存每段码字的编号——几百维向量能压成几十字节,十亿级向量才变得可驻留。压缩必然引入距离误差,所以实践里最常见的组合是"粗筛用压缩、精修用原始":先用量化距离圈出扩大候选集,再用原始向量重算距离排序,误差被控制在排序层面而不是结果层面。
图 3-1 主流索引家族全景对比
一次构建与查询的完整会话
三条路线在一个会话里串起来(伪代码,主流库均有对应接口):
import numpy as np d, n = 128, 500_000 xb = np.random.rand(n, d).astype("float32") xq = np.random.rand(8, d).astype("float32") # 路线一:倒排文件。nlist 个簇心,查 nprobe 个簇 ivf = IndexIVFFlat(quantizer, d, nlist=1024, metric=INNER_PRODUCT) ivf.train(xb[:50_000]) # 先用采样训练聚类 ivf.add(xb) # 每条向量挂到最近簇 ivf.nprobe = 16 # 运行时调节召回与延迟 # 路线二:分层图。M 控制连接度,efSearch 控制搜索宽度 hgw = IndexHNSWFlat(d, M=32, metric=INNER_PRODUCT) hgw.add(xb) # 逐点插入并连边,无需训练 hgw.hnsw.efSearch = 64 # 路线三:组合。倒排圈地,段内乘积量化压缩,再精修 ivfpq = IndexIVFPQ(quantizer, d, nlist=1024, subq=16, bits=8) ivfpq.train(xb[:50_000]); ivfpq.add(xb); ivfpq.nprobe = 16 for name, idx in [("IVF", ivf), ("HNSW", hgw), ("IVFPQ", ivfpq)]: D, I = idx.search(xq, 10) print(name, "返回条数:", len(I[0]))
会话里有三处细节值得圈出来。训练与插入分离是倒排系结构的标准流程,训练采样要能代表整体分布,分布偏斜的数据切不能只用头部样本训练;参数在查询期可调(nprobe、efSearch)而结构参数在建库期定死(nlist、M),这意味着延迟调优可以在线做、内存调优必须重建做;度量参数在建索引时声明,与第二章"换口径即重建"的结论在这里对上了。
问题:应该默认上组合结构吗?
不要。组合结构(倒排加量化、图加量化)的收益以"你需要它的那个瓶颈真实存在"为前提。百万级以下,平面或纯图索引的效果更好也更简单;千万级、内存吃紧时,量化粗筛加精修才开始回本。组合结构多一层参数(码本大小、子段数、精修倍数),多一类失效模式(码本欠拟合、精修预算不足),运维心智成本显著更高。默认从最简单的结构起步,等 5.5 的基准告诉你瓶颈真实出现在内存或扫描量上,再引入组合——让数据推动架构复杂度,而不是让焦虑推动。
三条路线的组合关系
把三条路线理解成三个正交的旋钮更有助于记忆:倒排决定"先看哪里"(范围控制),图决定"怎么走过去"(路径控制),量化决定"带多少行李上路"(体积控制)。工程组合就是把旋钮拧到业务需要的档位——纯图是范围全开加路径最优,倒排加量化是范围收窄加行李减半。没有万能档位,只有与数据规模、内存预算、更新频率匹配的档位组合。
本节要点回顾
- 三条路线:IVF 用聚类圈地,HNSW 用图跳跃,量化用码本压缩,互相可以组合。
- IVF 的 nlist 定结构、nprobe 定运行时探测宽度,探测拉满即退化回暴力。
- HNSW 金字塔顶层走高速、底层走精查,高召回的代价是最大内存与墓碑式删除。
- 量化的正确用法是粗筛加精修,把误差限制在排序层面。
- 运行时参数可在线调,结构参数与度量口径必须建库前定死。
结构选好了,下一节处理时间维度:索引怎么跟着数据的增删改活下去。