3.1 块表怎么切 KV Cache:16 token 一页
3.1 块表怎么切 KV Cache:16 token 一页
本节摘要:块表是 PagedAttention 的核心数据结构:把每条请求的 KV Cache 视为逻辑块序列,物理显存切成 16 token 一块的页块,块表维护逻辑块号到物理块号的映射。本节讲清结构、分配回收流程与"16"这个数字的取舍,并算清利用率跃迁的算术。它治的正是第 2 章的病根:取消连续性与峰值假设。
1962 年,曼彻斯特的 Atlas 团队为了让程序不再操心物理内存的零碎,第一次实现了虚拟内存的页式管理:程序看到连续地址,硬件与操作系统把地址翻译成零散的物理页帧。六十年后,vLLM 把同一思想搬进了 GPU 显存——一条请求的 KV Cache 在逻辑上仍然连续,物理上却是散落的页块,翻译工作由块表完成。本节沿这条线索拆解块表:它长什么样、怎么运转、为什么偏偏是 16。
结构:逻辑块、物理块与一张映射表
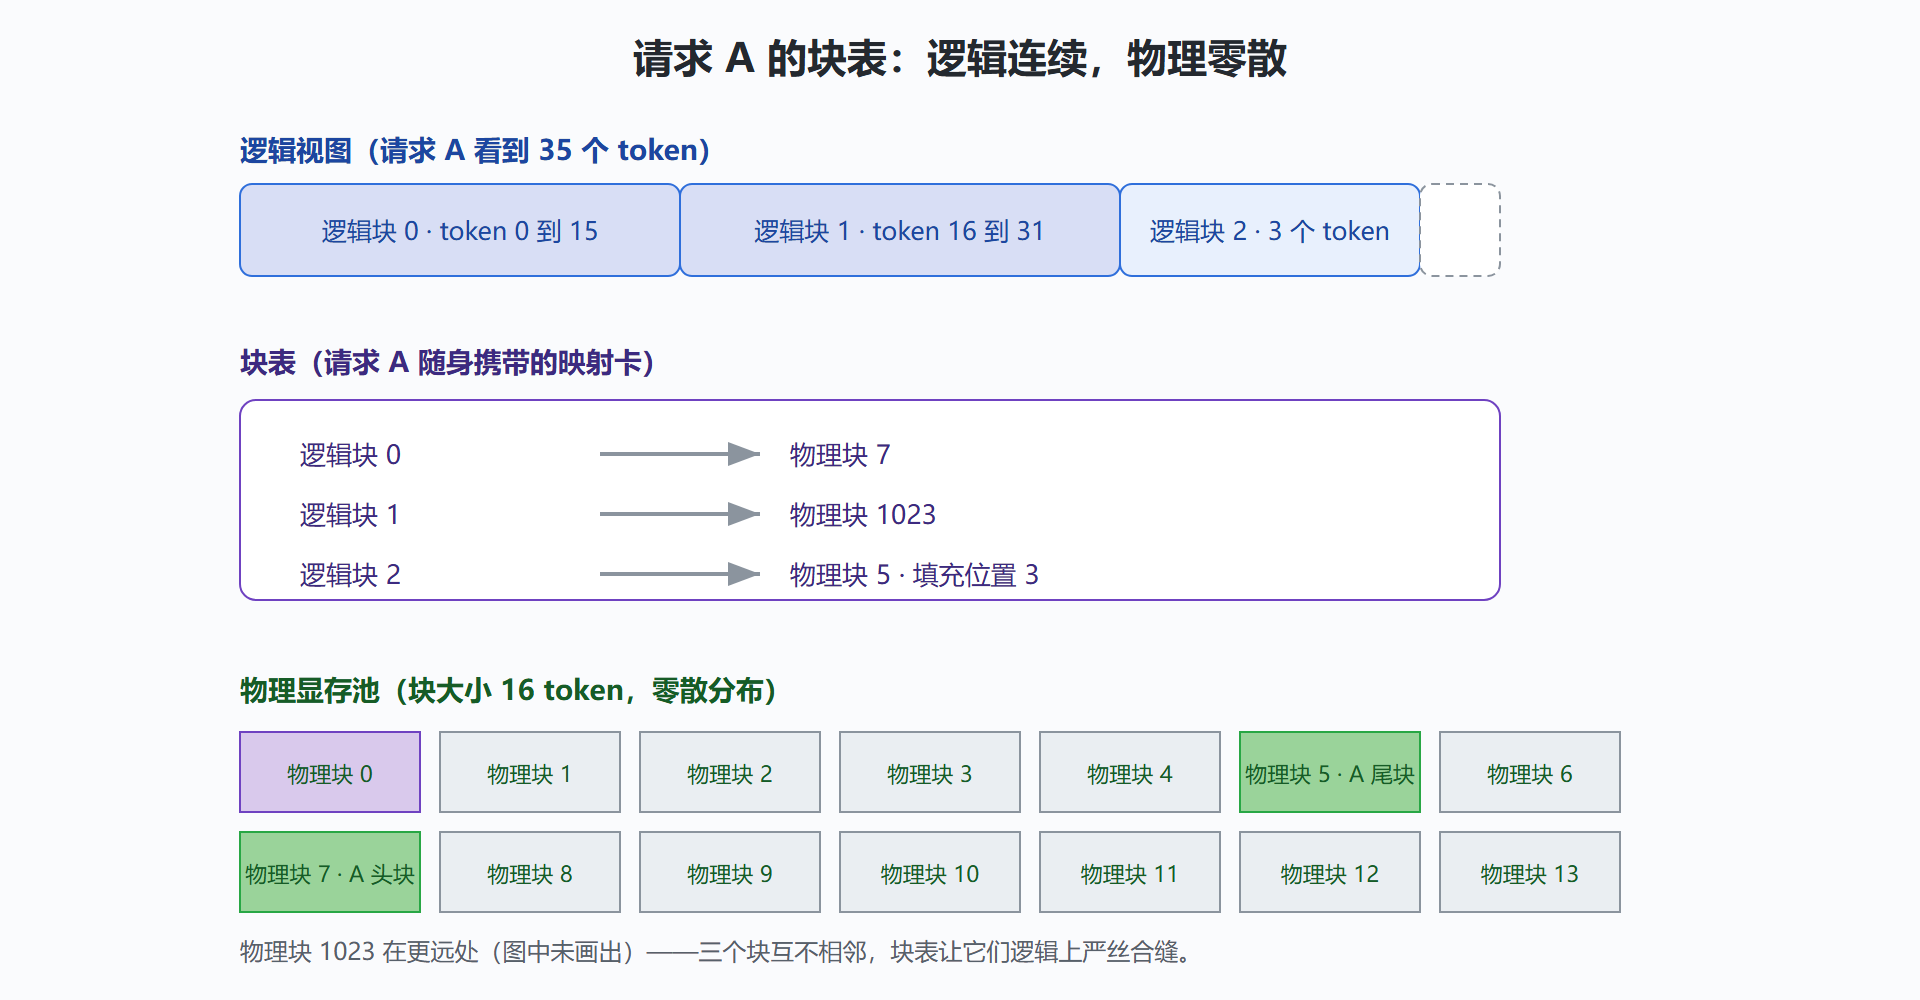
把每个请求的 KV Cache 序列按固定长度切片:每 16 个 token 的键值构成一个逻辑块。显存池预先切成大小完全相同的物理块(同样装 16 个 token 的键值)。块表就是每个请求随身的一张小卡片,记录它的第几个逻辑块放在哪个物理块里,外加一个"最后一个块里填到第几个 token"的位置指针。
请求 A(已生成 35 个 token,块大小 16): 逻辑视图: [块0: token 0-15] [块1: token 16-31] [块2: token 32-34,未满] 块表 A: 逻辑块 0 → 物理块 7 逻辑块 1 → 物理块 1023 逻辑块 2 → 物理块 5 (填充位置 = 3) 物理显存池:[块0][块1]...[块5=A的尾块]...[块7=A的头块]...[块1023=A的中块] 三个物理块在显存里互不相邻,逻辑上却严丝合缝。
对照第 2 章的病根,可以看到两条假设是怎么被同时取消的:
- 不再按峰值预留:请求 A 生成到 35 个 token,就只占 3 个物理块。第 36 个 token 到来时才分配第 4 块。付款方式从"一次性付清最坏情况"变成"按需增量支付"。
- 不再要求连续:新块从空闲池里拿,哪有空就放哪。外部碎片意义上的"零散空位"不复存在——任何空闲物理块都等价可用。
运转:一次 decode 步里块表干了什么
生成第 36 个 token 时,注意力算子需要读取前 35 个 token 的键值。由于它们分布在三个物理块里,算子的工作方式变成:查块表拿到三个物理块的地址,逐块加载、分块计算注意力、汇总结果——间接寻址的开销被限制在几次指针查询上,而分块计算本身可以高度并行。vLLM 为此重写了注意力内核,让"非连续内存上的注意力"跑出接近连续内存的速度;这也是 PagedAttention 不只是"管理技巧",而是"数据结构 + 算子"成套设计的原因。
写入侧同样受块表照料:新 token 的键值写进当前块的下一个槽位;写满即从空闲池取新块、登记一行映射。请求结束时,它名下所有物理块一次性归还。分配与回收都是 O(块数) 的数组操作,没有搜索、没有整理、没有碎片合并——管理开销小到可以忽略。
为什么是 16:一个工程折中数字
块大小的选择是在两种损耗之间走钢丝:
| 块大小 | 内部碎片 | 块表与管理开销 | 算子效率 |
|---|---|---|---|
| 1 token | 几乎为零 | 映射项极多,元数据膨胀 | 每块太碎,内核难高效 |
| 16 token | 平均每请求不足 8 token(半块) | 映射项少,一张表放得下 | 块内并行度充足 |
| 256 token | 回到内部碎片老路 | 映射项极少 | 与整块预留差别不大 |
16 的含义是:平均每条请求的内部碎片从"半块以上预留量"(第 2 章)压到不足半块——按 80 个 token 的平均余量算,浪费从动辄上千 token 的预留降到最多 15 个 token 槽位,量级差出几十倍。vLLM 支持调整块大小,但默认 16 在绝大多数负载下就是甜点位,平时不必动它。
图:块表把 KV Cache 映射到零散物理块
跃迁的算术:从三成到九成
把第 2 章的账用块表重算一遍。真实长度 800 token 的请求现在占约 50 个物理块,其中最多浪费半块——真实占用约 0.1 GB,账面占用 0.1 GB 出头,比例超过九成。预留浪费消失、内部碎片从"成块"降到"半块以内"、外部碎片因物理布局自由而不再存在。三笔浪费一笔勾销后,同一块显存能容纳的并发请求数不再是"预留口径"的三成折损,而是接近真实口径的满额——这就是"利用率三成到九成、并发翻数倍"的全部算术,没有玄学。
⚠️ 一个实践提醒:块表带来的并发能力是真实的,但它也会让服务"敢于"接收更多长上下文请求。上线后请盯住块池的空闲水位(日志里的 GPU KV cache usage),水位长期在九成以上就该扩容或限流,而不是坐等抢占机制兜底——抢占是有代价的,第 4.2 节马上讲。
变式算例:长上下文请求在块表下的表现
用一个极端例子检验理解:一条 32K 上下文的请求,块大小 16,会占用多少块?
逻辑块数 = 32768 ÷ 16 = 2048 块 块表长度 = 2048 行(每行一个物理块号 + 少量元数据) 真实浪费 = 最后一块未满部分,最多 15 个 token 槽位 对比预留式:若按 64K 上限预留,浪费的预留量是这条请求真实占用的整整一倍
块表本身只有两千行整数映射,元数据开销与两千块键值相比可以忽略——这就是"细颗粒管理"在长序列上依然成立的原因:管理数据结构的增长是线性的且系数极小,而被省下的浪费是成块的显存。这个性质让 vLLM 对长上下文场景格外友好:上下文越长,预留式方案浪费越凶,块表的相对优势越大。
与操作系统的两处不同
对应关系讲完了,两处不同也别错过。其一,推理里没有"缺页中断"的对应物——请求的块必须全部驻留显存才能运行,不存在"用到再从磁盘调入"的选项(有些系统做主存卸载,那是调度决策而非按需分页)。其二,翻译成本的结构不同:CPU 的页表翻译有硬件加速(TLB),而 GPU 上块表的查询由注意力算子显式执行——所以 vLLM 必须把取数方式写进内核,而不是依赖通用的内存抽象。理解这两点,你在对比各家"类 PagedAttention"实现时就能看出深浅:块表人人会画,算子层的消化能力才是真功夫。
本节要点回顾
- 块表 = 逻辑块到物理块的映射,同时取消"连续"与"按峰值预留"两条假设。
- 分配与回收是数组操作:写满取新块、结束还块,没有碎片整理。
- 16 token 是内部碎片与管理开销的折中,默认值通常不必调整。
- 算子与数据结构是成套设计:注意力内核按块取数,间接寻址开销被压到可忽略。
- 利用率从三成到九成是算术结果,并发能力随之翻数倍。
块表还有一张隐藏的好牌:既然物理块是独立的,两份一模一样的块就没有必要存两份。下一节看写时复制与前缀共享怎么打这张牌。