3.2 写时复制与前缀共享:相同的开头只存一份
3.2 写时复制与前缀共享:相同的开头只存一份
本节摘要:块表让每个物理块获得了独立身份,"多个请求引用同一块物理块"成为可能:读永远安全,写才触发复制——这就是写时复制。它向下减少显存占用,向上催生第 5 章的自动前缀缓存。本节讲清共享的时机、复制的粒度与正确性保证,并算一笔"一千个用户共享同一个系统提示词"的账。
别以为共享显存是危险动作——在块表的世界里,它反而是最自然的事。传统布局下两份相同的 KV 前缀是两块互不相干的连续显存,想共享都下不去手;块表把 KV Cache 切成了带编号的独立块,"两份一样的块只存一份"从工程壮举降格成一次指针赋值。本节把这套机制拆开:什么时候共享、什么时候复制、正确性由谁保证。
从一次共享说起:decode 的读写不对称
decode 阶段的 KV Cache 有一个关键性质:历史位置永远只读。token 5 的键值一旦写入就不再改变,每一步 decode 只是往序列尾部追加新键值。也就是说,一条请求的 KV Cache 里,除了最末尾那个未写满的块,其余全部块都是只读的。
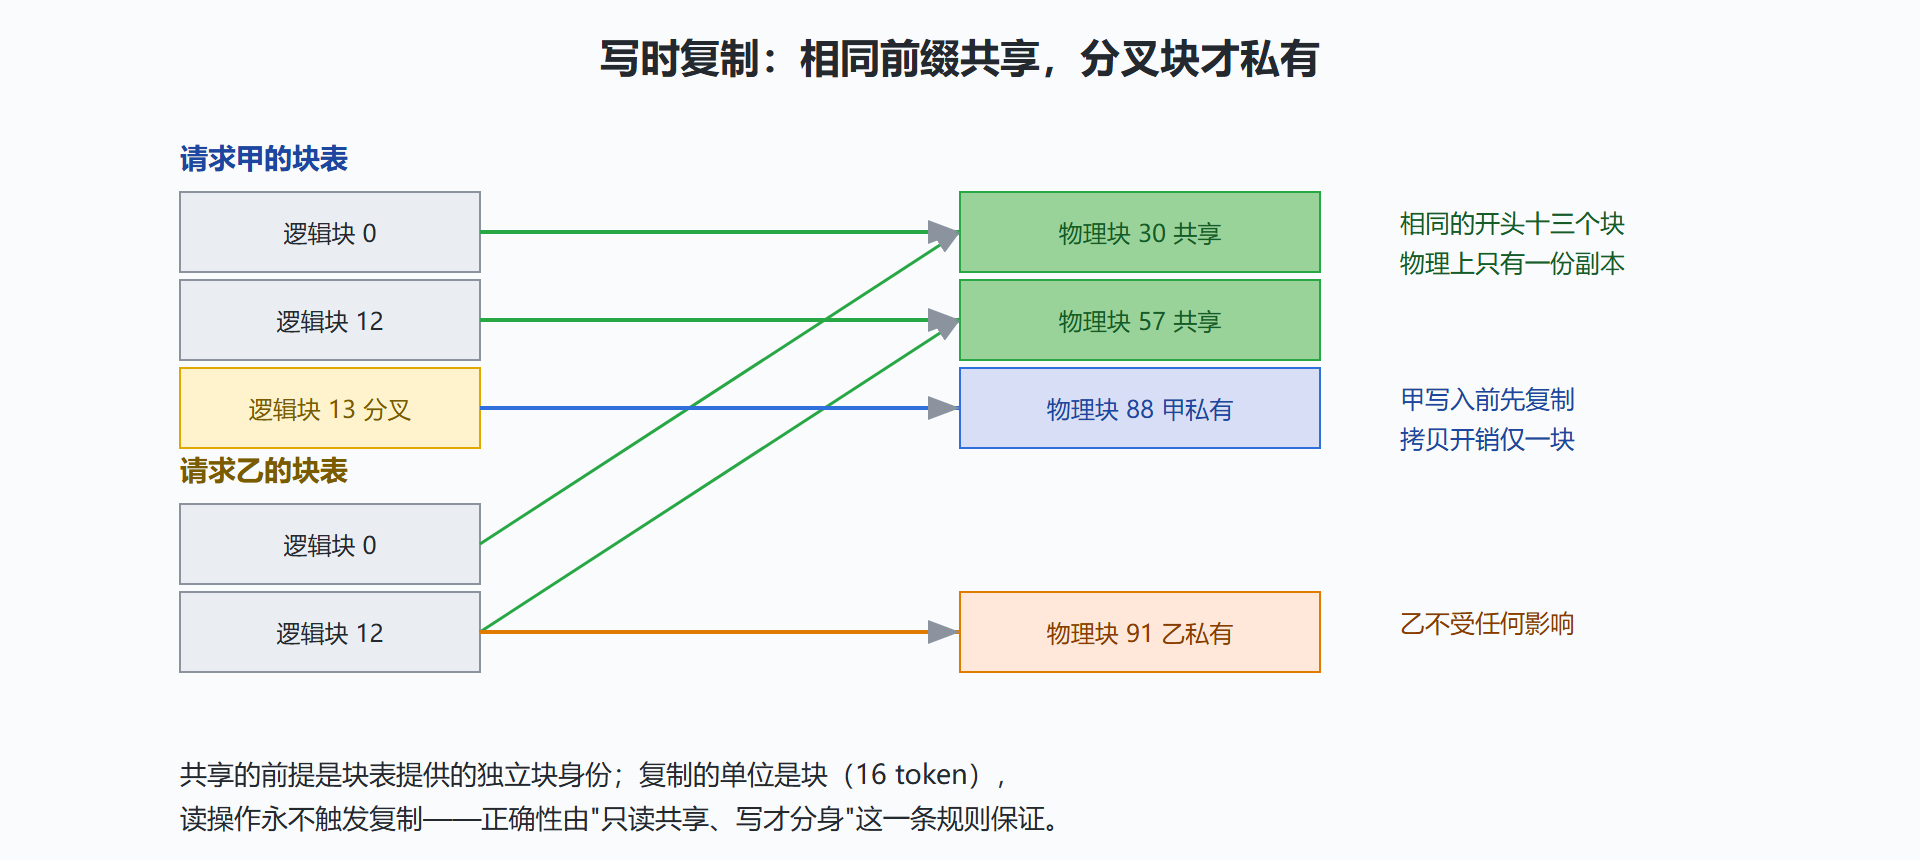
只读的东西天然可以共享。假设请求甲和请求乙的输入以完全相同的 200 个 token 开头(比如同一段系统提示词),那么它们逻辑块 0 到 12 的内容一模一样。块表机制下,vLLM 直接让两张块表把这十三个逻辑块全部指向同一组物理块:显存里只有一份副本,两家共同引用。
关键直觉:共享的边界由"读写行为"划出,而不是由"请求归属"划出。历史块人人可读、永不相扰;各自真正开始分叉的那一块,才是私有财产的起点。
写时复制:分叉那一刻发生了什么
当请求甲继续生成、需要在第 200 个 token 之后追加内容时,麻烦来了:它的第 13 个逻辑块和请求乙的指向同一个物理块,而甲要往这个块里写新 token——直接写会污染乙的数据。
vLLM 的处理是教科书式的写时复制(Copy-on-Write):检测到"对共享块的写入"时,先从空闲池取一个新物理块,把旧块内容拷进去,再把甲的块表项改指向新块,然后才执行写入。乙的块表毫发无损,仍旧指向原来的物理块。
复制以块为单位:只复制正在分叉的那一块(16 个 token 的键值),之前完全相同的部分继续共享。粒度小、时机明确、次数少——绝大多数请求只会触发零次或一次复制。这在成本上几乎可以忽略,换来的收益却是结构性的。
图:写时复制——共享读取,分叉才复制
一笔账:一千个用户共用一个系统提示词
设某个客服机器人有一段 1500 token 的系统提示词(角色设定、业务知识、格式要求),日活一千,每人平均对话十轮。对比两种管理方式:
无共享(预留 + 各存一份): 每条请求都完整携带 1500 token 前缀的 KV Cache 单条前缀占用 ≈ 1500 × 0.125 GB/千token ≈ 0.19 GB 千人同时在线的前缀部分 ≈ 190 GB —— 远超单卡容量 有共享(块表 + 写时复制): 前缀部分全站只存一份 ≈ 0.19 GB 每条请求只私有各自新增的对话增量 千人同时在线的前缀成本 ≈ 0.19 GB —— 降了三个数量级
除了显存,还有一笔计算账:如果前缀只存了一份但每条请求仍要重新计算它,省的只是空间。vLLM 把这件事做到了底——前缀的 KV 本来就是算好的,共享引用意味着计算也只做一次。这就是第 5 章自动前缀缓存的基础:块表让"空间共享"顺理成章,"计算复用"跟着免费搭车。多轮对话场景里,第二轮请求直接引用第一轮已经算好的历史块,连 prefill 都大幅缩短,TTFT 显著下降。
代价与边界
共享机制有三个边界值得记住。其一,共享依赖内容完全一致:token 序列逐位相同才可共享,温度、采样参数这些生成配置不影响(它们不改变 KV),但提示词里一个字符的差别(哪怕只是时间戳)都会让前缀从差异处彻底分叉——为共享而生的提示词设计应当把动态内容放到末尾。其二,共享块有引用计数,引用计数归零才回收;极端情况下一批长共享链会延迟显存归还,但相比收益可以忽略。其三,复制是懒执行的,它的正确性依赖"写前检查引用计数"被严格执行,任何绕过该检查的算子定制都可能造成数据污染——二次开发算子时这是最需要盯住的正确性红线。
共享率的自检:你的业务能省多少
前缀共享的收益不用猜,一个离线脚本就能估算:取最近一天的线上请求样本,把每条输入的 token 序列拿来两两比对公共前缀长度,画出"公共前缀占比"的分布。
共享率估算(示意结论): 客服机器人(固定系统提示词 2000 token,平均输入 2500 token) → 公共前缀占比约八成,前缀共享的显存节省量级为四倍以上 文档分析(每条请求的文档都不同) → 公共前缀接近零,共享几乎无收益,显存节省可忽略
这个分布同时预告了第 5 章前缀缓存的收益——同一批高共享流量,跨时间复用的命中率也会高。两个机制共享同一个流量特征,一次估算两处受益。
一个容易被忽略的细节:分叉位置决定复用深度
两条请求的公共前缀在哪个 token 处分叉,直接决定共享了几个块。值得注意的是,分叉往往出现在"看起来很像"的位置之后:两条几乎相同的提示词,只因为开头一个时间戳不同,就会从第一个块起彻底分叉,共享为零。这就是提示词工程里"稳定内容前置"原则的底层逻辑——把动态字段挤到输入末尾,等于把分叉点推向深处,让共享的块数最大化。给提示词做"共享体检"应该成为应用层的标准动作,成本不过几分钟,收益直接落到显存账上。
本节要点回顾
- decode 的历史块永远只读,这一性质让跨请求共享既安全又自然。
- 写时复制以块为粒度:分叉那一刻才复制一块(16 token),之前的部分继续共享。
- 前缀共享同时省显存与计算:系统提示词、few-shot 示例、多轮历史都是高价值共享对象。
- 提示词设计影响共享率:动态内容放末尾,能显著提高整段前缀的命中。
- 正确性红线:引用计数检查必须先于任何对共享块的写入。
显存这台戏到这里唱完了大半:块表管好了布局,写时复制管好了重复。下一章换一个舞台——时间。请求怎么进批、GPU 的时间片怎么排,是吞吐故事的下半场。