5.1 前缀缓存:相同的前缀只算一次
5.1 前缀缓存:相同的前缀只算一次
本节摘要:前缀缓存把第 3.2 节"同时在线的请求间共享"升级为"跨时间的块级复用":以块的 token 序列为索引,任何后来请求只要前缀逐位相同,就直接引用已算好的 KV 块,prefill 随之缩短。本节讲清索引与淘汰机制、命中率的决定因素与养法,以及提示词结构对收益的放大作用。
一家部署代码助手的团队做过复盘:用户的提问千差万别,但每条请求的开头都是同一段几千 token 的仓库上下文加角色设定。按平均每条请求 prefill 花费一两百毫秒算,光是把这段"人人相同的开头"算上一遍,每天就要烧掉数小时的纯计算。前缀缓存(prefix caching / automatic prefix caching)就是给这类场景的答案:算过一次的前缀块存进缓存池,后来者直接引用——prefill 只算增量,TTFT 显著下降,显存只存一份。
从请求间共享到跨时间缓存
第 3.2 节的写时复制解决的是"此刻在线的几条请求"共享同一段前缀:请求同时到达,prefill 各算各的,只是在写时避免重复存储。前缀缓存把时间维度也加进来:
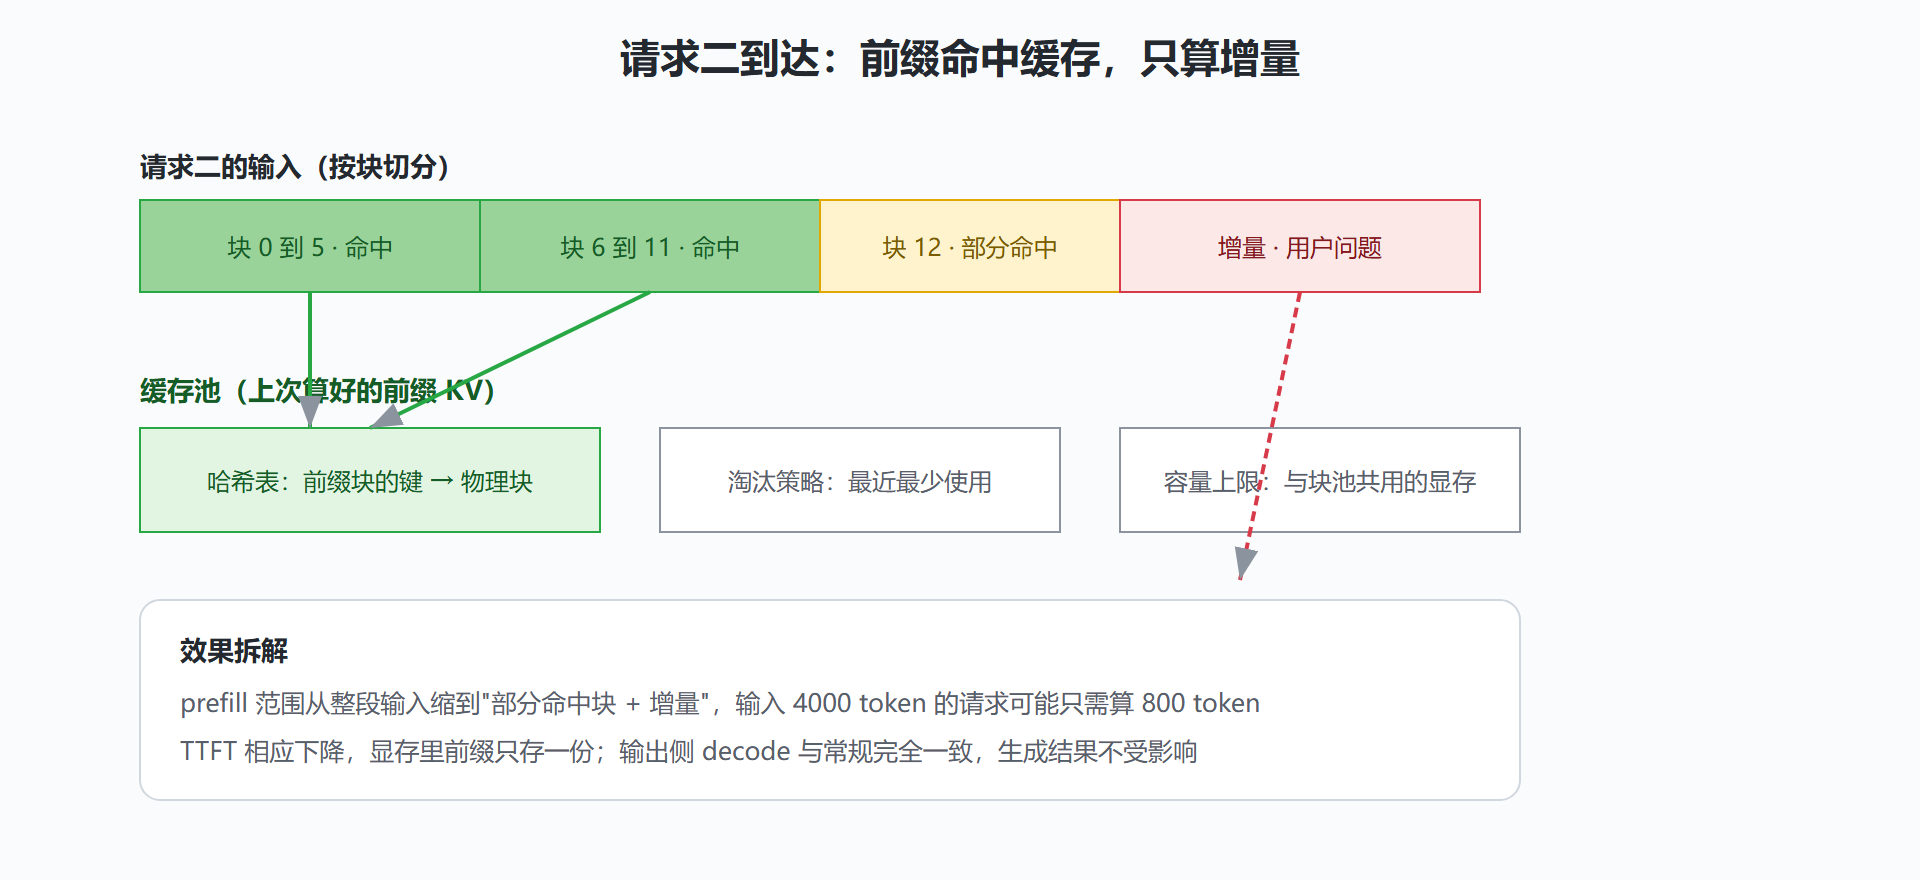
上午 9:00 请求一:系统提示词 A + 用户问题 X → 前缀 A 的块算好并按块哈希登记进缓存池 上午 9:01 请求二:系统提示词 A + 用户问题 Y → prefill 前先查索引:A 的每块都命中 → 直接引用,只对问题 Y 的增量做 prefill
实现的关键是以块为单位做内容寻址:每个物理块里那 16 个 token 的序列被哈希成一个键(连同它的前缀链,保证前缀一致性),缓存池就是一张"键到物理块"的哈希表。查找命中意味着"这段 token 的键值我已经算过且还在显存里",prefill 直接跳到第一个未命中的块继续算。请求结束后,它的块不急着释放——引用计数归零后转入候选淘汰状态,等新的分配需求来了才按策略(通常是最近最少使用)逐出。这层设计很像操作系统的页缓存:用闲置的显存装"可能再被用到"的计算结果,淘汰发生在需要时而非结束时。
图:前缀缓存命中与增量计算
命中率是唯一的杠杆:怎么把它养高
前缀缓存的收益与缓存命中率成正比,而命中率由三件事决定,前两件归你管:
提示词结构:把稳定内容放前面,动态内容放后面。一段提示词若以当前时间戳开头,每条请求从第一个块起就分叉,命中率归零。常见反例是把会话 ID、随机种子、用户名插在开头;正确姿势是"角色设定 → 知识库 → few-shot 示例 → 具体问题"的稳定度递减排列。多轮对话天然高命中——历史轮次就是前缀。
流量构成:共享系统提示词的助手类、带固定知识库前缀的检索增强(RAG)类应用是命中的沃土;前缀各异的长文档处理类应用则基本无利可图。命中率的量级判断可以用一条经验:把最近一周真实请求按公共前缀聚类,看最大的几个前缀簇覆盖了多少流量——覆盖高则收益高。
缓存容量与淘汰:缓存块与运行块共用块池,容量吃紧时 LRU 逐出。高流量下把 gpu_memory_utilization(第 7 章细讲)维持在 0.9 附近的常规配置通常已给缓存留了足够空间;若命中率忽高忽低,先查是不是流量洪峰把缓存挤掉了。
怎么打开、怎么验证
新版本 vLLM 默认开启自动前缀缓存;如果你的版本较老或被显式关闭,启动参数加 --enable-prefix-caching 即可。验证收益不要靠感觉,分三步:
第一步:压测基线。关闭缓存跑一轮服务口径压测,记下 TTFT 的 P50 与 P99。 第二步:开启对比。同一份流量回放,开启缓存再跑一轮。 第三步:看两个数。日志里的缓存命中率;TTFT 分位变化。 命中率高但 TTFT 没降?说明命中的是短前缀,收益被增量稀释——检查提示词结构。
一个提醒:缓存改变的是 prefill 的起点,不改变任何生成逻辑——同一条请求无论命中与否,输出内容完全一致。所以开启它是无风险动作,唯一的成本是块池里缓存块占用的显存;前缀各异、命中率近零的负载可以关掉,把显存留给并发。
⚠️ 提示词模板频繁改版的团队注意:模板一改,旧缓存全部失效,命中率会跳水再缓慢恢复。发版时间选在低峰期,改版前后别拿缓存命中率当性能回归指标——它下降是必然的,与性能无关。
多轮对话:前缀缓存最肥沃的天然场景
值得单独一提的是多轮对话。每一轮请求的输入都包含前几轮的完整历史——这意味着第 N 轮的前缀天然包含第 N−1 轮的全部内容,只要会话的块还在缓存池里,新请求的 prefill 就只需处理最新一轮的用户输入。会话连续性越好、轮次越深,节省越显著:一个平均五轮的对话应用,深轮次的 prefill 工作量可以降到首轮的几分之一,TTFT 的改善会随对话深入而放大。
工程上有一个配套细节:会话路由。如果负载均衡把同一会话的请求随机打到不同实例,实例间的缓存互不相通,命中就靠运气。在网关层做会话粘性(同一会话固定路由到同一实例)能把命中率从"碰运气"变成"必然命中"——这是应用侧一行路由配置换来的确定性收益,性价比极高。
与第 3.2 节的分工:一张对照说清
两处"共享"容易混淆,用一张对照表钉死边界:
| 维度 | 请求间共享(写时复制) | 前缀缓存(跨时间复用) |
|---|---|---|
| 共享对象 | 同时在线的几条请求 | 任意时刻、任意先后 |
| 触发条件 | 同时到达且前缀相同 | 前缀块曾在缓存池中算过 |
| 省的是什么 | 显存(一份副本)与重复写入 | prefill 计算、TTFT、显存 |
| 失效条件 | 请求结束 | 块被 LRU 逐出或提示词改版 |
两者是叠加关系而非替代:同时在线的请求先享受请求间共享,历史算过的前缀再叠加缓存复用。理解了分工,监控里的"缓存命中"与"共享块引用"就是两个独立的观察窗口,各自反映不同的流量特征。
本节要点回顾
- 前缀缓存以块哈希为索引、跨时间复用,是写时复制从"请求间"到"历史中"的升级。
- 命中即引用、只算增量:prefill 缩短、TTFT 下降、显存只存一份,输出结果不受影响。
- 命中率靠养:稳定内容前置、动态内容后置;助手类与 RAG 类负载是沃土。
- 验证三步:基线压测、开启对比、命中率先行 TTFT 随后。
- 成本只是块池里的一些显存,前缀各异的负载可以关掉,但绝大多数生产负载值得开着。
前缀缓存消灭的是"相同的开头",可就算每个 token 都是新的,解码仍要一步一个 token 地爬。下一节看投机解码怎么让一步顶多步——以及它什么时候反而帮倒忙。