5.2 投机解码:小模型起草,大模型验稿
5.2 投机解码:小模型起草,大模型验稿
本节摘要:投机解码(speculative decoding)利用"验证多个候选与生成一个候选耗时几乎相同"的性质:让一个小的草稿模型快速猜出若干后续 token,大模型一次前向并行验证,接受的部分一步到位,拒绝的部分从正确处续跑。数学上保证输出分布与大模型独立解码完全一致。本节讲清机制、接受率的经济学与参数取舍。
定义先行:投机解码是一种"起草-验证"式的解码加速方法——用一个便宜的小模型(草稿模型)猜测接下来的一串 token,再用昂贵的大模型(主模型)一次前向验证这些猜测,猜对的直接采纳,猜错的从错误处回退。它是 vLLM 里少数"改变了单步语义"的机制,也是唯一能在大模型权重搬运这个物理瓶颈下,把 decode 有效步长拉长到多个 token 的手段。
为什么"验证"几乎免费
第 1.1 节讲过:decode 每步的成本大头是把全部权重从显存搬一遍,而这一次搬运能承载的计算远不止"生成一个 token 的分布"。主模型对一段长度为 k 的候选序列做一次前向,搬运成本与生成单个 token 几乎相同,却同时得到这 k 个位置上"大模型自己会怎么选"的完整分布。这个"搬运一次、验证多个"的富余,就是投机解码的利润来源——它没有违背访存受限的物理规律,只是把每趟搬运装得更满。
一次起草-验证循环的完整流程:
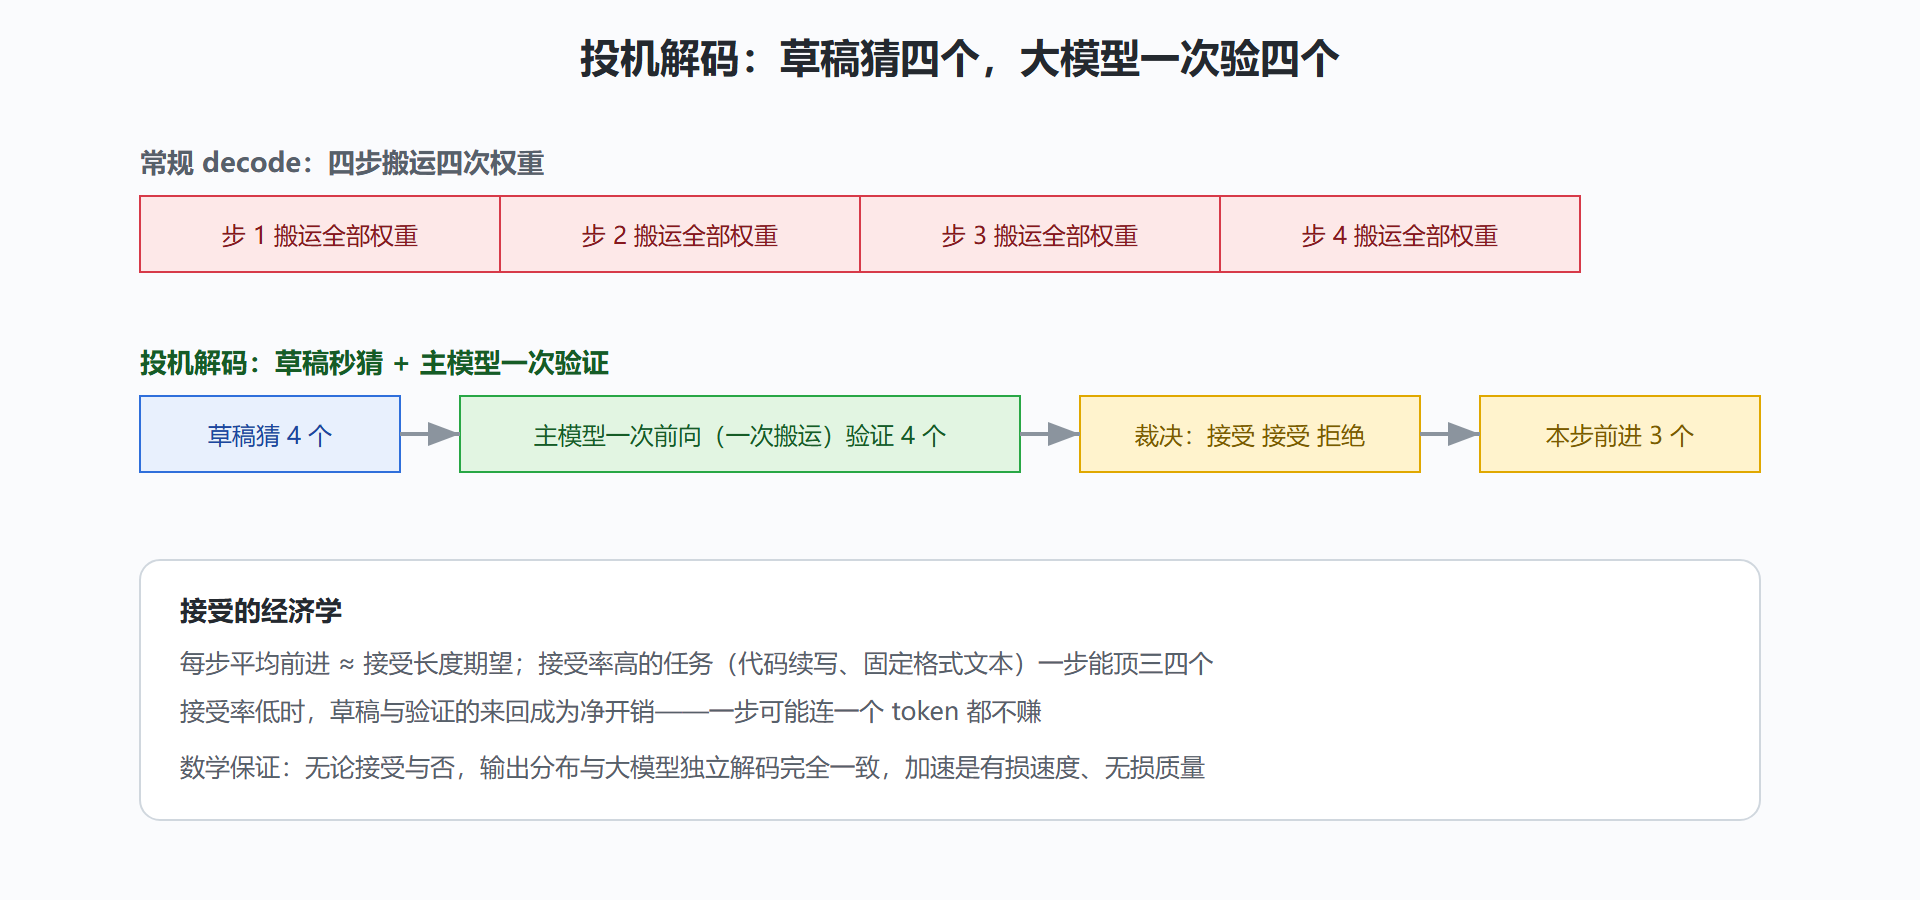
第 1 步 起草:草稿模型(参数量约为主模型的十分之一到百分之一) 自回归地快速猜出 k 个候选 token,比如 k = 4。 第 2 步 验证:主模型对"原上下文 + 4 个候选"做一次前向, 得到每个位置上主模型的分布。 第 3 步 裁决:从左到右逐个比对—— 候选 1 接受,候选 2 接受,候选 3 拒绝: 则本步前进 2 个 token,且第 3 个 token 用主模型分布重新采样。 第 4 步 续跑:接受越多,本步前进越远;最少前进 1 个(全部拒绝)。
接受规则经过精心设计,使得最终输出与大模型自己逐步解码的分布完全一致——不是近似,是数学等价:被接受的候选满足特定概率条件,被拒绝时用经过修正的分布重采样。这意味着投机解码是无损加速,可以直接用在对确定性敏感的场合,不用担心输出质量漂移。
图:起草-验证的一步,顶一到 k 步
接受率的经济学:什么时候开、什么时候关
设草稿模型每步耗时是主模型的 a 倍,验证一次的成本约等于主模型一步,投机解码的收益条件可以粗略写成:
每步平均前进 L 个 token(L 由接受率决定,上限为 k + 1) 耗时 ≈ a + 1(份主模型步长成本) 划算条件 ≈ L > a + 1;例如草稿成本是主模型的十分之一(a = 0.1), 平均只要能前进约 1.2 个 token 就已回本。
接受率由任务性质决定,经验上的分野相当清晰:
| 任务特征 | 接受率预期 | 建议 |
|---|---|---|
| 代码补全、模板文本、JSON 结构 | 高(重复模式多) | 开,收益常在翻倍级别 |
| 通用对话、翻译 | 中等 | 开,实测决定 |
| 高温度采样、强发散创作 | 低 | 慎开,可能倒亏 |
| 短输出(几个 token 就结束) | 收益摊不薄 | 意义不大 |
参数上,vLLM 通过启动参数指定草稿模型与每步投机 token 数(如指定 --speculative-model 为一个同词表的小模型,--num-speculative-tokens 设 k,常用 3 到 5)。k 越大,猜中的期望越多,但被拒绝时浪费的验证算力也越多——经验上让 k 对齐"平均接受长度再加一"即可,盲目调大没有额外奖励。
💡 选草稿模型的一条主线:词表必须与主模型一致(否则候选无法直接验证),结构越相似接受率越高。同家族蒸馏出的小模型是首选;没有现成小模型时,n-gram 式的"查表起草"也是一类实现思路,对模板化文本尤其有效。
与其他机制的叠加关系
投机解码改的是"单条请求每步前进几个 token",前缀缓存改的是"prefill 从哪里开始",连续批处理改的是"批里有哪些人"——三者作用在不同维度,可以叠加。但要注意两组张力:其一,批越大,单步的算力越满,"验证多个"的富余越小,高并发场景投机解码的边际收益缩水,它最肥沃的土壤是中低并发、串行瓶颈明显的服务;其二,投机解码加大了每步的计算波动,与严格的延迟上限(SLO)同时要求时需要实测校准。给部署者的判断顺序建议:先把块表与批处理的红利吃完(默认行为),再开前缀缓存(近零成本),最后实测决定要不要投机解码。
一个思想实验:为什么"猜错也不亏"很反直觉
初见者最容易卡在这一点:草稿猜错了,验证不就白费了吗?细算一笔账就能释怀——验证一次的成本约等于主模型正常的一步,而全部拒绝时的收获是"确定了下一个 token"(用主模型分布重采样),这与不投机时的正常一步完全等价。也就是说,最坏情形退化为普通解码,只是多付了一份很便宜的草稿成本;每多接受一个候选,都是净赚。这份"下行有底、上行敞开"的收益结构,正是它值得在合适场景默认尝试的原因。
输出长度的另一个视角
投机解码改善的是"单位时间前进的 token 数",对固定长度输出而言就是总时间缩短;但还有一类场景收益更隐蔽——长度受限的任务。比如受限于响应窗口的流式场景,每秒能前进更多 token 意味着同样窗口内能完成更长的生成,间接提升了产品能力上限。反过来,超短输出(几个 token 就结束)连一次完整的起草-验证循环都摊不满,这类接口开投机解码纯属浪费,按接口粒度分别配置比全局开关更合理。
落地检查单
把本节的选择题收拢成三问,部署前过一遍:第一问,词表对齐了吗——草稿模型与主模型的分词器不一致是新手最常见的翻车点,候选根本无法直接验证;第二问,接受率量过吗——拿真实流量样本跑几百条,平均接受长度低于一就直接放弃;第三问,并发水平适合吗——高并发下批已经把算力填满,投机解码的富余逻辑失效,中低并发才是它的主场。三问都过关再开,省心。
本节要点回顾
- 投机解码 = 草稿猜 k 个 + 主模型一次验证,搬运一次权重验多个候选,把访存富余装满。
- 输出分布与大模型独立解码完全一致,无损加速,可用于确定性敏感场景。
- 接受率是命门:代码与结构化文本肥沃,高发散创作可能倒亏;参数 k 对齐平均接受长度即可。
- 草稿模型选型主线:同词表、同家族、参数量小两个数量级。
- 叠加顺序:块表与批处理打底,前缀缓存次之,投机解码最后实测决定。
到本章为止,能"省"的都省了。剩下的硬约束只有两个:模型大到单卡装不下怎么办、精度能不能砍。第 6 章进入量化与并行的世界。