4.1 性能评测总纲:延迟、质量与算力的三维权衡
4.1 性能评测总纲:延迟、质量与算力的三维权衡
本节摘要:把延迟、码率效率、计算复杂度放进同一坐标系后,AAC 与 Opus 呈现互补的帕累托前沿:AAC 在中高码率的音质精细度与生态覆盖上占优,Opus 在低延迟、低码率与算力经济性上占优。本节给出三个维度的量级对照、差距的架构归因,以及"结论何时翻转"的边界条件。
第 4 章开篇:先立坐标系、给数字、做归因,4.2 节再解决这些数字"怎么测出来的"。本节的每个结论都标注了架构根源,方便与前两章互相印证。
维度一:延迟——差距写在帧结构里
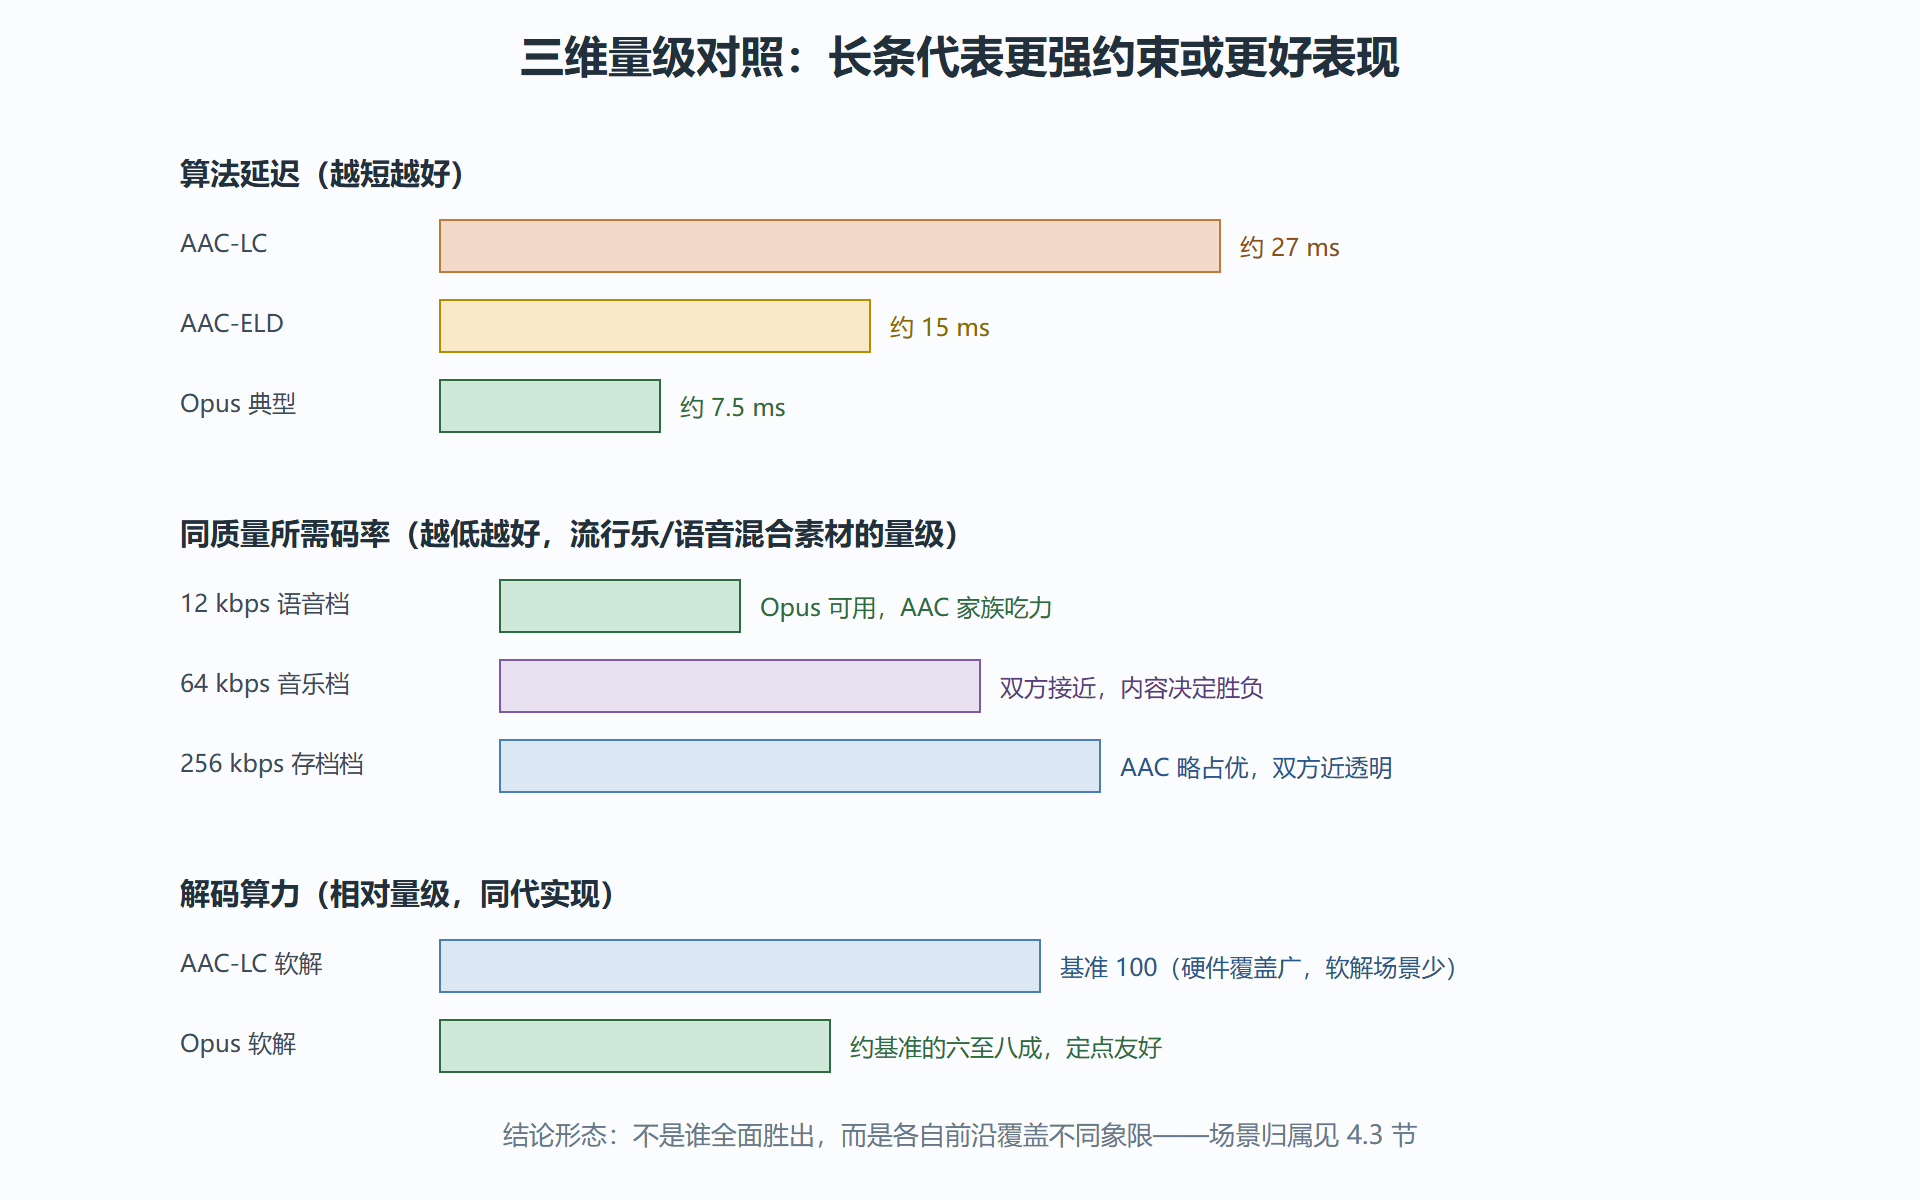
2.5 节已给出 AAC 家族的延迟谱系(LC 约 27 ms、ELD 约 15 ms、HE 系 40 ms 以上),3.3 节给出 Opus 的档位(典型 7.5 ms、极限 2.5 至 5 ms)。并排的要点不在数字本身,而在数字的可变性:AAC 的延迟是 Profile 决定的常量,选定即锁死;Opus 的延迟是帧长参数的函数,运行中可调。这带来一个工程后果——链路预算紧张时(比如端到端要压进 100 ms),AAC-ELD 的 15 ms 是固定成本,Opus 可以把帧长降到 10 ms 换出 5 ms 余量给抖动缓冲。延迟预算的弹性本身就是战斗力。
还要提醒"算法延迟"与"端到端延迟"的换算关系:用户体感的是后者 = 采集缓冲 + 算法延迟 + 打包 + 网络 + 抖动缓冲 + 解码 + 播放缓冲。算法延迟只占其中一段,5.4 节的直播算例会做完整加法。
维度二:码率效率——两条曲线的形状不同
把"码率-质量"曲线画出来,两家的形状有系统差异:
- 低码率段(约 6–32 kbps):Opus 明显占优。SILK 引擎在 12 kbps 附近仍能维持高可懂度语音,AAC 家族在这个区间只能靠 HE-AAC v2 的参数化路线,音乐内容劣化更快。量级参考:公开的多轮 MUSHRA 测试中,Opus 在 32 kbps 语音档的得分普遍需要 AAC 侧用接近两倍的码率才能匹配。
- 中码率段(约 64–128 kbps):互有胜负、内容依赖强。流行乐与人声 Opus 已可用,复杂 orchestral 内容 AAC 的掩蔽精细度开始显优势。
- 高码率段(约 160/192 kbps 以上):AAC 的成熟心理声学机器在细节藏匿上仍略占先,且双方都接近透明,差距进入听感噪声区。
曲线形状的差异同样能归因到架构:低码率优势来自参数化语音骨架(SILK),高码率劣势来自噪声藏匿的精细度(CELT 的能量/形状分离天然比逐系数的尺度因子循环粗一档)。
图:三维量级对照
维度三:算力——两套计算经济学
AAC-LC 的计算重心在 MDCT 与双循环比特分配,浮点密集、访存局部性一般,但它的算力问题在实践里很少暴露——因为消费电子世界给它铺了全球最广的硬件解码覆盖(4.4 节展开)。Opus 的解码路径以整数运算与查表为主,SILK 的合成滤波与 CELT 的逆变换都极易 SIMD 与定点化,软解成本低且稳定,这正是它能在服务器端高并发、终端侧低功耗两头都吃得开的原因。
量级感受(同代优化水平的公开测试口径):Opus 解码约为 AAC-LC 软解的六至八成算力;编码侧差距更大,Opus 低复杂度档在 MCU 级设备可实时,AAC 编码基本不出现在超低端设备上。但给结论时必须带条件——AAC 靠硬解把算力问题外包给了芯片,Opus 靠算力经济性让自己不挑硬件。两条策略在各自生态里都成立。
结论何时翻转:边界条件清单
| 条件变化 | 优势倾向 | 原因 |
|---|---|---|
| 码率降到 32 kbps 以下 | Opus | SILK 骨架 + 带宽自适应 |
| 码率升到 192 kbps 以上 | AAC(微弱) | 掩蔽精细度 + 双方近透明 |
| 延迟预算低于 40 ms | Opus | 帧结构弹性 |
| 需要存档十年、跨设备播放 | AAC | 生态与硬解覆盖(4.4) |
| 丢包率超过约 3% | Opus | FEC/PLC 内建 |
| 目标端是浏览器实时链路 | Opus | WebRTC 强制支持 |
| 目标端是 iOS 音乐生态 | AAC | 平台默认与工具链(4.4) |
这张表是本章的浓缩:左边三行是技术边界,右边四行是生态边界——后者在真实选型里往往一票否决。
数字的口径与可信度
引用任何对比数字前,先核对三个口径。口径一是实现版本:编码器质量随版本演进(Opus 的编码器几乎每年都在改进,AAC 的各开源实现差距更大),跨版本的对比数字保质期很短。口径二是测试素材:语音与音乐、干净与嘈杂、单声道与立体声的结论可以完全不同,正式测试(如多次被引用的 HydrogenAudio 社区听测、标准组织的正式评测)都附素材清单,转引时必须一并带上。口径三是档位对齐:"64 kbps Opus 对 64 kbps AAC"是码率对齐,但 VBR 与 CBR 的"同码率"含义不同(VBR 是平均值),立体声与单声道的对比也不可直接换算。
给一个可信度自评的粗规则:有听音队伍规模、素材清单、显著性检验三要素的数字可作工程参考;只有均值的数字只能当方向感;来自发布会与营销页的数字一律按"未验证"处理。本节给出的量级(如"低码率段 Opus 需要 AAC 侧接近两倍码率匹配")属于方向感与量级判断,具体到你的素材与档位,请回到 4.2 节的流程自测——这也是我们把测量方法单独成节的原因。
算力维度再补一组可复现的实测姿势:在同一台机器上固定素材与参数,量"单核每路实时编码/解码的最多路数"——这个数对会议服务器(能带多少路)与终端(还剩多少算力给别的模块)都是直接的工程答案。注意记录 CPU 型号、编译选项(SIMD 开关影响巨大)与复杂度档位,三者缺一数字就不可比。
一组可复现的算力实测姿势
算力维度给出具体的测量协议,避免"感觉差不多"式的结论。固定素材(一段语音加一段音乐各三十秒)、固定参数(码率、帧长、复杂度按目标场景),测三个数:单核每秒可完成的路数(吞吐)、单路的 CPU 占用率(容量)、从喂入到出包的编码耗时分布(实时性余量)。三个数分别回答"服务器能带多少路""终端还剩多少算力""最坏帧会不会超时"——会议服务、终端 App、嵌入式设备的选型关心点各取所需。
测量时三个坑要避开:SIMD 编译开关没开(数字差两三倍,结论全错);测的是编码还是解码没说清(两者差一个量级,混用必然误导);后台负载没清空(笔记本的温控降频会让数字漂移)。规范的报告格式是"机型 + 编译选项 + 三项数值 + 波动范围",缺项的数字引用时一律打折。
💡 关键直觉:三维权衡的正确用法不是"谁的分高",而是先问自己的约束哪一个最硬。延迟硬就往 Opus 的象限走,兼容硬就往 AAC 的象限走,两个都硬(低延迟 + 全设备兼容)才是真正的难题——那通常意味着做双轨(5.1 节的选择策略会给出双轨方案)。
数字从哪来、可信度如何,是下一节的主题:同样的编码器,在一套糟糕的听感测试里可以得出完全相反的结论。