4.2 音质评测方法论:MUSHRA、PESQ与ABX实战
4.2 音质评测方法论:MUSHRA、PESQ 与 ABX 实战
本节摘要:编码器对比结论的可信度取决于评测方法。本节拆解三类手段的适用边界与操作要点——MUSHRA 多刺激盲测(工程金标准)、ABX 强迫选择(最小可行验证)、PESQ/POLQA/ViSQOL 客观指标(批量筛选),并给出一套可直接落地的对比实验流程与常见统计陷阱。
4.1 节给了一堆量级数字,本节回答"这些数字该怎么产生、读到别人的数字该问什么"。这也是对比驱动的修养:不掌握测量方法的人,只能背诵别人的结论。
为什么"听起来更好"不能当证据
人耳听感判断受三类系统性偏置污染。顺序偏置:后听到的版本在记忆里更新鲜,判断天然偏向近因。标签偏置:知道哪个是"高码率"哪个是"新编码器"后,期望会直接改写感知——这是音频发烧圈"线材听感"争议长期的根源。训练偏置:长期接触某类失真的听音者会对该失真异常敏感,而普通用户毫无察觉——工程师听到的"金属感",用户可能根本不存在。
所以规范的方法论都在做同一件事:把"更好的听感"改造成"统计上可复现的判别"。三件工具分别对应三个精度与成本档位。
MUSHRA:多刺激盲测的工程标准
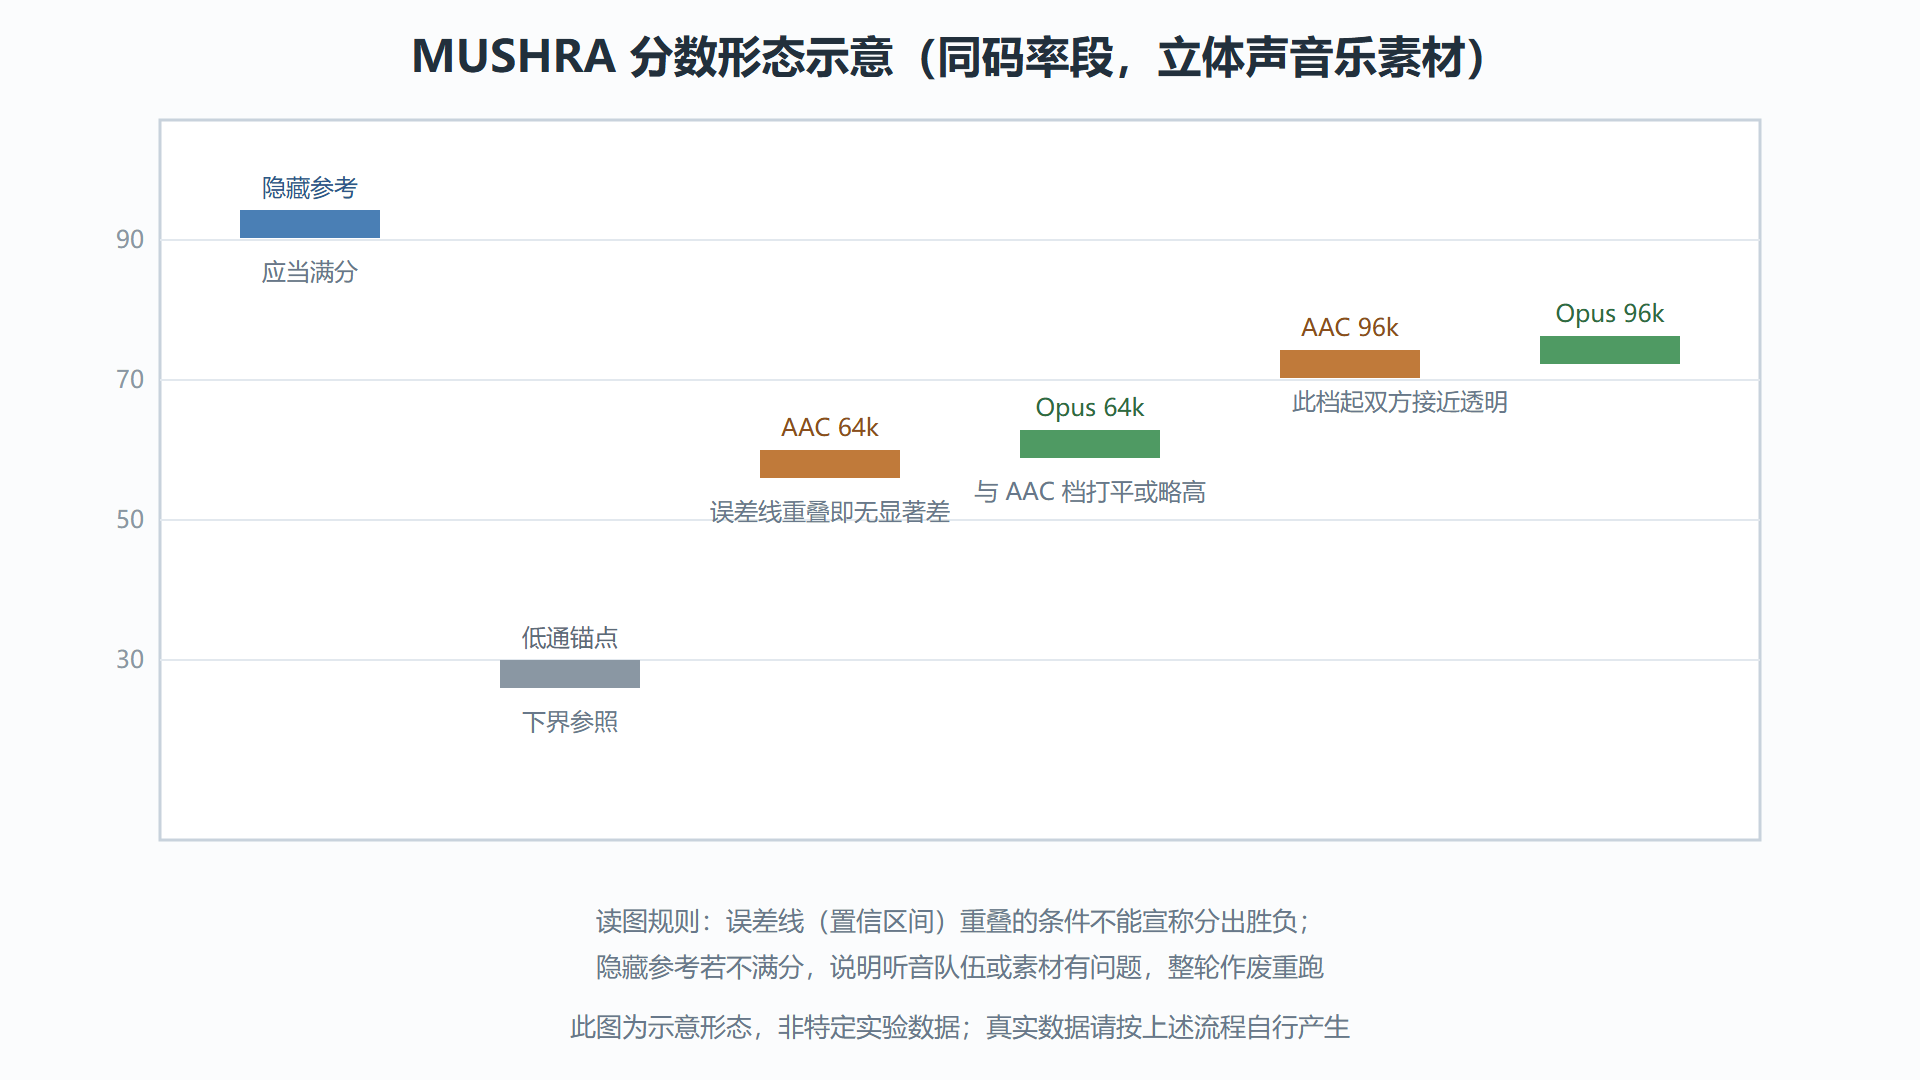
MUSHRA(ITU-R BS.1534,多刺激隐藏参考与锚点测试)的机制:一次 trial 内同时给出隐藏参考(原始信号,身份保密)、低通锚点(3.5 kHz 截止的劣化版)、若干待测条件,听音者对每条打 0–100 分。锚点的作用是给分数一个下界参照——听音者被迫把"明显劣化"锚定在锚点附近,而不是凭心情给 60 分。
操作要点按流程列出:
- 素材选择:选"难编"的素材(临界段落)——镲片衰减、女声齿音、钢琴弱奏混响尾、多人语音重叠。平滑的流行乐大多编得动,拉不开差距;
- 条件设计:隐藏参考 + 锚点 + 待测(如 AAC 64k/96k/128k、Opus 48k/64k/96k),单次 trial 条件数控制在十以内防疲劳;
- 听音队伍:八至二十人,含若干"受过训练"的听音者(他们负责抓细节失真),也含普通用户(他们代表真实体感);
- 环境与设备:统一耳机或监听环境,静音室或安静房间,音量校准——不同设备上同一对比的结论可以翻转;
- 数据分析:报分数分布而非仅均值;条件间差异做显著性检验;训练轮数据剔除。
图:一次对比实验的分数形态
ABX:最小可行的强迫选择
不需要 MUSHRA 的整套流程时,ABX 是性价比最高的验证:听音者先熟悉 A(参考)与 B(待测),然后盲听随机出现的 X,判断 X 是 A 还是 B。统计 N 次判对的比例——显著高于随机水平(通常取 75% 判对率为"可闻差异"的经验线)即认定差异可闻。免费工具与脚本生态成熟(命令行与图形界面都有),单人即可运行。它的局限也明确:只能回答"有没有差异",不能量化差异大小;样本量小,结论限于本人此设备此素材。
工程上 ABX 的最佳用途是"验收":上线某个码率档前,自己先 ABX 一轮原始与编码版,若判不出差异,该档大概率安全。
客观指标:批量筛选的代理尺
主观测试贵且慢,大批量对比(比如扫几十组参数)先靠客观指标粗筛:
- PESQ(ITU-T P.862):窄带/宽带语音质量预测,通话场景经典;对音乐素材完全失真(会给出荒谬的高分/低分);
- POLQA(P.863,PESQ 继任):支持超宽带与全带宽,仍是"语音"尺;
- ViSQOL(Google 开源):基于频谱时间相似度,语音音乐都能用,与 MUSHRA 的相关性在音乐素材上明显更好;
- PSNR/SNR 类:对感知编码基本无意义(波形变了不代表听感差了),仅作工程 sanity check。
客观指标的共同天花板:它们建模的是"平均听感",对 1.3 节讲过的预回声、立体声像塌陷等"结构型失真"敏感度不足。正确用法是"粗筛 + 抽样主观验证",永远不要把 PESQ 分数当最终结论写进发布标准。
一套可直接落地的对比流程
把三件工具串成流水线,兼顾成本与可信度:
# 第 1 步:批量编码生成条件集(示例为 64k 档三方对比) ffmpeg -i trial.wav -c:a libfdk_aac -profile:a aac_he -b:a 64k a64.m4a ffmpeg -i trial.wav -c:a libopus -b:a 64k o64.opus # 第 2 步:客观指标粗筛(ViSQOL 对每条算相似度分) viswol --reference trial.wav --degraded a64.m4a viswol --reference trial.wav --degraded o64.opus # 第 3 步:差距在 0.1 分量级内的条件,进入 ABX 个人验收 # 第 4 步:上线档位变更时,组织一轮 10 人规模 MUSHRA 存档
流程背后的原则:客观指标排掉明显劣化的档位(省时间),ABX 拦住"我觉得更好"的自我欺骗(省口水),MUSHRA 给出可存档、可复现的正式结论(省争议)。
一个最小听感测试套件的定义
把方法论收进一个可复用的"套件"定义,团队任何人都能照跑。素材集五段、每段十五秒:女声朗读加空调底噪(测降噪交互与齿音)、男声电话场景(测低码率语音)、流行乐副歌(测瞬态与立体声)、古典弱奏段(测掩蔽精细度与噪声底)、语音加背景音乐混合(测双引擎或参数化的边界)。设备与环境:一副统一型号的监听耳机、安静房间、音量先校准到对话响度。人员:三名以上(含一名受过训练的听音者)。流程:先跑客观指标(ViSQOL 类)排掉明显劣化档,再对相邻档做 ABX 十次判别,存档判对率;档位变更上线前,加跑一轮五素材的 MUSHRA 简化版(隐藏参考加锚点加两三个条件)。
套件的成本约半天搭建、每轮一小时执行,换来的是"每次调参都有数可看"。维护规则三条:素材集每半年补一段新暴露的失真样本(遇到线上问题就沉淀进来);设备型号固定、更换时全套重跑基线;所有结果带版本号与日期入库——三个月后你只会相信带元数据的旧数据。
⚠️ 常见坑:三类陷阱最毁数据。素材太容易(平滑流行乐全员 90 分,白测);听音不盲(标签漏给听音者看到,期望污染);只报均值不报区间(把噪声里的零点几分差说成胜负)。另外跨实验的分数不可直接比——不同素材、不同队伍的 MUSHRA 分没有可比性,能比的只有同一实验内的相对排序。
💡 关键直觉:评测方法本身就是对比能力的一部分。会说"AAC 64k 比 Opus 64k 好"的人满街都是,能说出"在我们 12 人 MUSHRA、三段临界素材、误差线重叠"的人才有资格下结论。
测量方法就位后,下一节把视角从实验室拉回业务现场:四类场景约束场如何划分两个编码器的领地。