6.1 神经音频编码:Lyra、Satin与生成式压缩
6.1 神经音频编码:Lyra、Satin 与生成式压缩
本节摘要:神经音频编码把目标从"重建波形"改成"合成听感等价的音频"——编码器提取低维潜变量,解码器用生成网络重新"演出"声音。本节拆解这一范式与传统编码的对照(Lyra 与 Satin 两条代表路线)、它在极低码率上的真实收益、以及算力/可控性/评估三大落地障碍。
第 6 章开篇:先把变化最大的范式讲透。2.3 节埋的"参数化重建"伏线在这里抵达终点——生成式编码是参数化思想的极限形态。
范式变化:从重建到合成
传统编码(AAC 与 Opus 都是)的契约是"重建一个与原始波形在听感上等价的版本":变换或预测、量化、熵编码,解码端忠实还原。神经编码换了契约:编码端只提取一组描述"这段声音是什么"的潜变量(语义内容、说话人特征、能量与韵律轮廓),解码端用生成网络从潜变量合成一段新波形——它不必与原始波形逐样本相似,只要听感上无法区分(甚至更干净)。
这条路线的收益曲线很特殊:在 3 kbps 以下的极低码率区,它对传统编码形成了代差优势——传统编码在这个区间连"骨架"都传不完整,而生成模型可以只传几十维特征就合成出可懂且自然的语音。Lyra(Google,2021 年发布)以约 3 kbps 量级的工作点引发关注;Satin(Microsoft,2022 年公开)把目标提到 6 kbps 上下的宽带音乐与语音。后续工作(如更通用的声学 token 系路线)把这个思想扩展到音乐与音频大模型的接口层。
图:两种范式对照
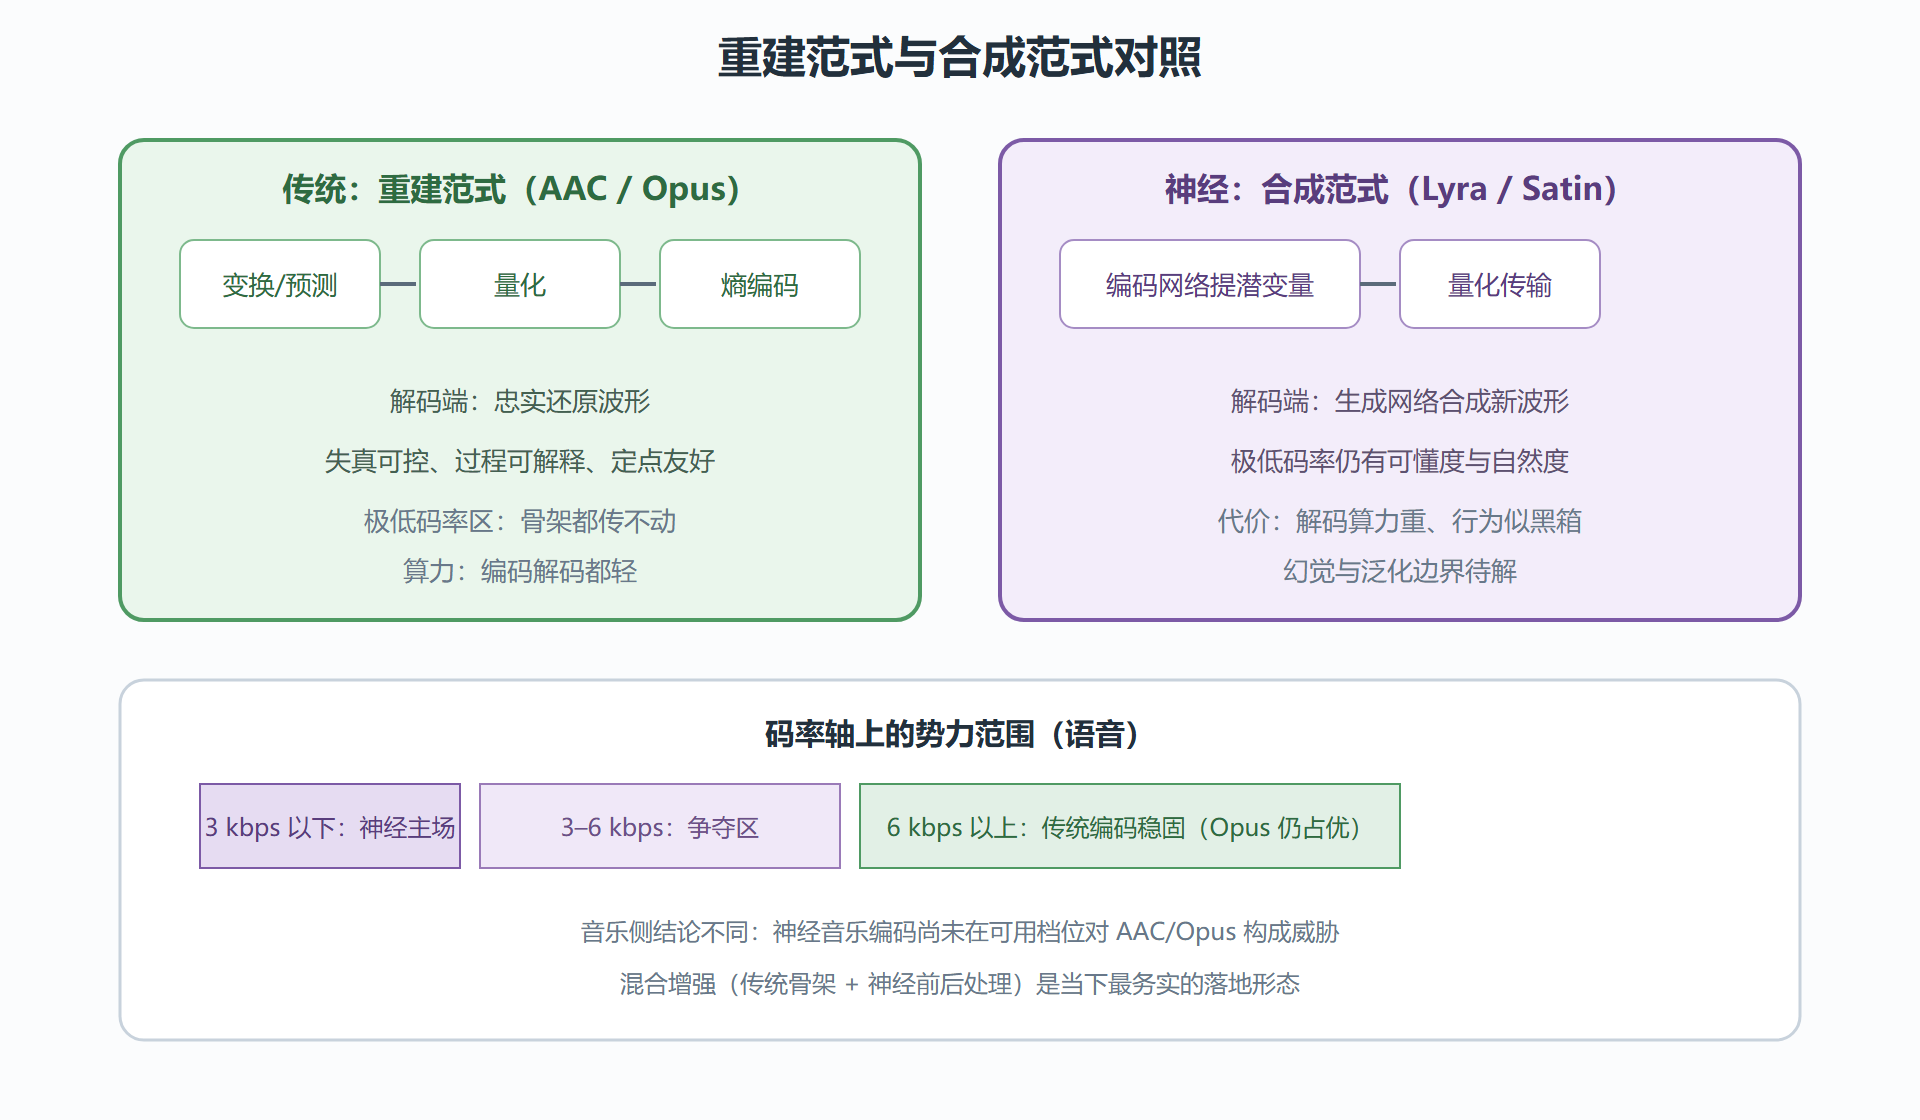
两条代表路线的分岔
Lyra 与 Satin 代表合成范式内部的两种取向。Lyra 的取向是"端侧可跑":编码端极轻(特征提取),解码端用一个紧凑的生成模型(早期为循环网络声码器路线),瞄准移动端弱网语音;它的哲学是"把算力花在解码端一次,把带宽省在传输里每一次"。Satin 的取向是"质量上限":以 6 kbps 左右为工作点,追求与 Opus 更高码率档打平的音乐与语音质量,模型更重、部署更偏服务端。
两条路线的共识比分歧更重要:潜变量 + 生成解码的框架、对"听感等价而非波形一致"的目标函数(训练损失用感知加权的频谱距离、对抗损失、甚至语音识别一致性项)、以及对极低码率区的共同专注。
三大落地障碍
算力障碍。生成模型的解码开销比传统解码器重一到两个数量级。语音通话里解码端跑在手机上,功耗与发热直接约束模型规模——这是神经编码器至今未能进入主流通话链路的首要原因。边缘侧量化(int8、剪枝)在推进,但与 libopus 那种"百元设备流畅"的门槛仍有距离。
可控性与幻觉障碍。生成模型会在训练分布外"编造"内容:罕见口音、背景非语音声、多说话人重叠时可能出现细节失真甚至内容漂移。传统编码的失真是"可预测的劣化"(变糊、变闷),生成编码的失真是"不可预测的替换"——对通信场景,后者更难被工程接受。级联与转码场景下,生成解码的输出再进传统编码器时,其合成纹理还会放大级联损伤(5.2 节的问题以新形态回归)。
评估障碍。4.2 节的方法论在神经编码上部分失效:PESQ/POLQA 对"合成但更好听"的输出系统性低估,MUSHRA 能给出排名却无法描述"合成保真度"这种新维度。评估体系的滞后不是小事——没有可信的尺子,工程验收就无从谈起,这也是标准组织(如 ITU 的相关研究组)当前的重点工作之一。
混合增强:当下最务实的落点
在范式完全切换之前,落地形态是"传统骨架 + 神经血肉":编码前用轻量网络做降噪、去混响、带宽扩展(替 AAC-LC 补高频、替 Opus 省出码率);编码后用生成模型做丢包恢复(比 3.4 节的 PLC 更聪明的合成)、高频细节增强。这类增强不动码流格式、不破坏互操作,收益立取,风险可控——是神经技术进入生产链路的低摩擦通道。AAC 与 Opus 的码流格式都已稳定多年,恰好给这类"外挂增强"留出了干净的接缝。
落地路线图与评估要点
把神经编码的落地形态按时间纵深排成三级路线图。近期(已在发生):外挂增强——编码前的降噪与带宽扩展、编码后的丢包恢复与高频补偿,不动码流格式,随取随用;这类方案在弱网语音与低码率广播里已有生产案例,评估要点是增强模块自身的算力预算与失效行为(网络出错时增强模块输出什么,必须可预期)。中期(技术与标准并行推进):潜变量接口标准化——生成解码作为"可替换的渲染端",码流只规定特征格式,解码端可从传统解码平滑升级到神经解码,互操作性由标准兜底;当前各标准组织的相关探索都在这个方向上。远期(依赖算力与评估体系):端到端神经编码进入主流链路——前提是解码算力在目标设备上足够便宜、且评估体系能回答"合成保真度"的可验收定义。
给评估者的三问清单:第一问,它的极低码率优势在你的目标码率区间还存在吗(很多方案在 8 kbps 以上就失去优势,而你的业务未必需要那么低)?第二问,解码算力在你的最弱终端上什么档位(手机?耳机?服务器按路计费)?第三问,训练分布外内容的表现如何(拿你的真实素材——带口音、带噪声、带多说话人——跑极限测试)。三问答完,新闻稿里的数字就会还原成你的工程结论。
⚠️ 常见坑:拿新闻稿的"3 kbps 可用"直接做产品决策。演示素材多是干净语音;真实通话的噪声、口音、多人场景里,合成范式的边界会显形。评估任何神经编码器,请回到 4.2 节的流程,用自己的素材、自己的听音队伍、自己的设备跑一轮。
两条路线的参数细节对照
把 Lyra 与 Satin 的公开参数并排,能看到"合成范式内部"的取舍光谱:Lyra 早期版本工作在 16 kHz 采样、约 3 kbps、每 40 ms 提取一次特征向量、解码端为紧凑声码器(后期版本扩展了采样率与码率档位);Satin 工作在 48 kHz 全频带、约 6 kbps 档、以"达到传统编码更高码率档的听感"为目标、模型更重更偏服务端部署。一个把宝押在"极低带宽下的可用性",一个押在"同带宽下的质量上限"——恰好对应 3.1 节里 SILK 与 CELT 当年的两种出身,历史在范式更替时又演了一遍。
工程细节上两者也有共性可提炼:特征提取端都极轻(这是端侧部署的前提);量化都采用矢量量化或其残差变体(连续特征压成离散索引,天然适配信道传输);解码端都接受"生成而非还原"的验收标准(评估用听感测试而非波形距离)。这三条共性基本定义了"工程上站得住的神经编码器"的形态——任何新方案偏离其中一条,落地阻力都会陡增。
💡 关键直觉:重建范式解决"怎么传得像",合成范式解决"怎么传得起"。前者优化的是失真,后者优化的是描述效率。极低码率是两者的交接区——而交接区的归属,最终由解码端算力的普及速度裁决。
下一节把镜头从"时间轴的码率"转向"空间轴的声场":当编码对象从声道变成三维声场,格局如何重排。