6.2 空间音频与沉浸式编码:MPEG-H与Ambisonics
6.2 空间音频与沉浸式编码:MPEG-H 与 Ambisonics
本节摘要:空间音频把编码对象从"声道"升级为"声场"——用球谐函数描述三维声能分布(Ambisonics 路线),或用对象加元数据描述声源位置(MPEG-H 3D 路线)。本节讲清两种表示的原理互补、MPEG-H 的分层架构,以及 AAC 与 Opus 在这场升维中的位置:AAC 的谱系直通 MPEG-H,Opus 靠多声道 Ambisonics 传输在实时领域占位。
6.1 节改写了"时间-码率"轴上的竞争,本节引入一条新轴:"空间"。这也是 AAC 与 Opus 对比的一个有趣转折点——在单声道与立体声的世界里并肩竞争的两个编码器,到了三维声场里走向了不同的入口。
表示域的升维:从声道到声场
立体声与环绕声的本质是" prescribe 扬声器":内容按预定的扬声器布局混音,播放端有对应布局才能还原。这套范式在沉浸式场景(VR、头部追踪、个性化渲染)下不够用——用户的头在转、扬声器布局不可知、声源需要交互。于是出现了两种升维表示:
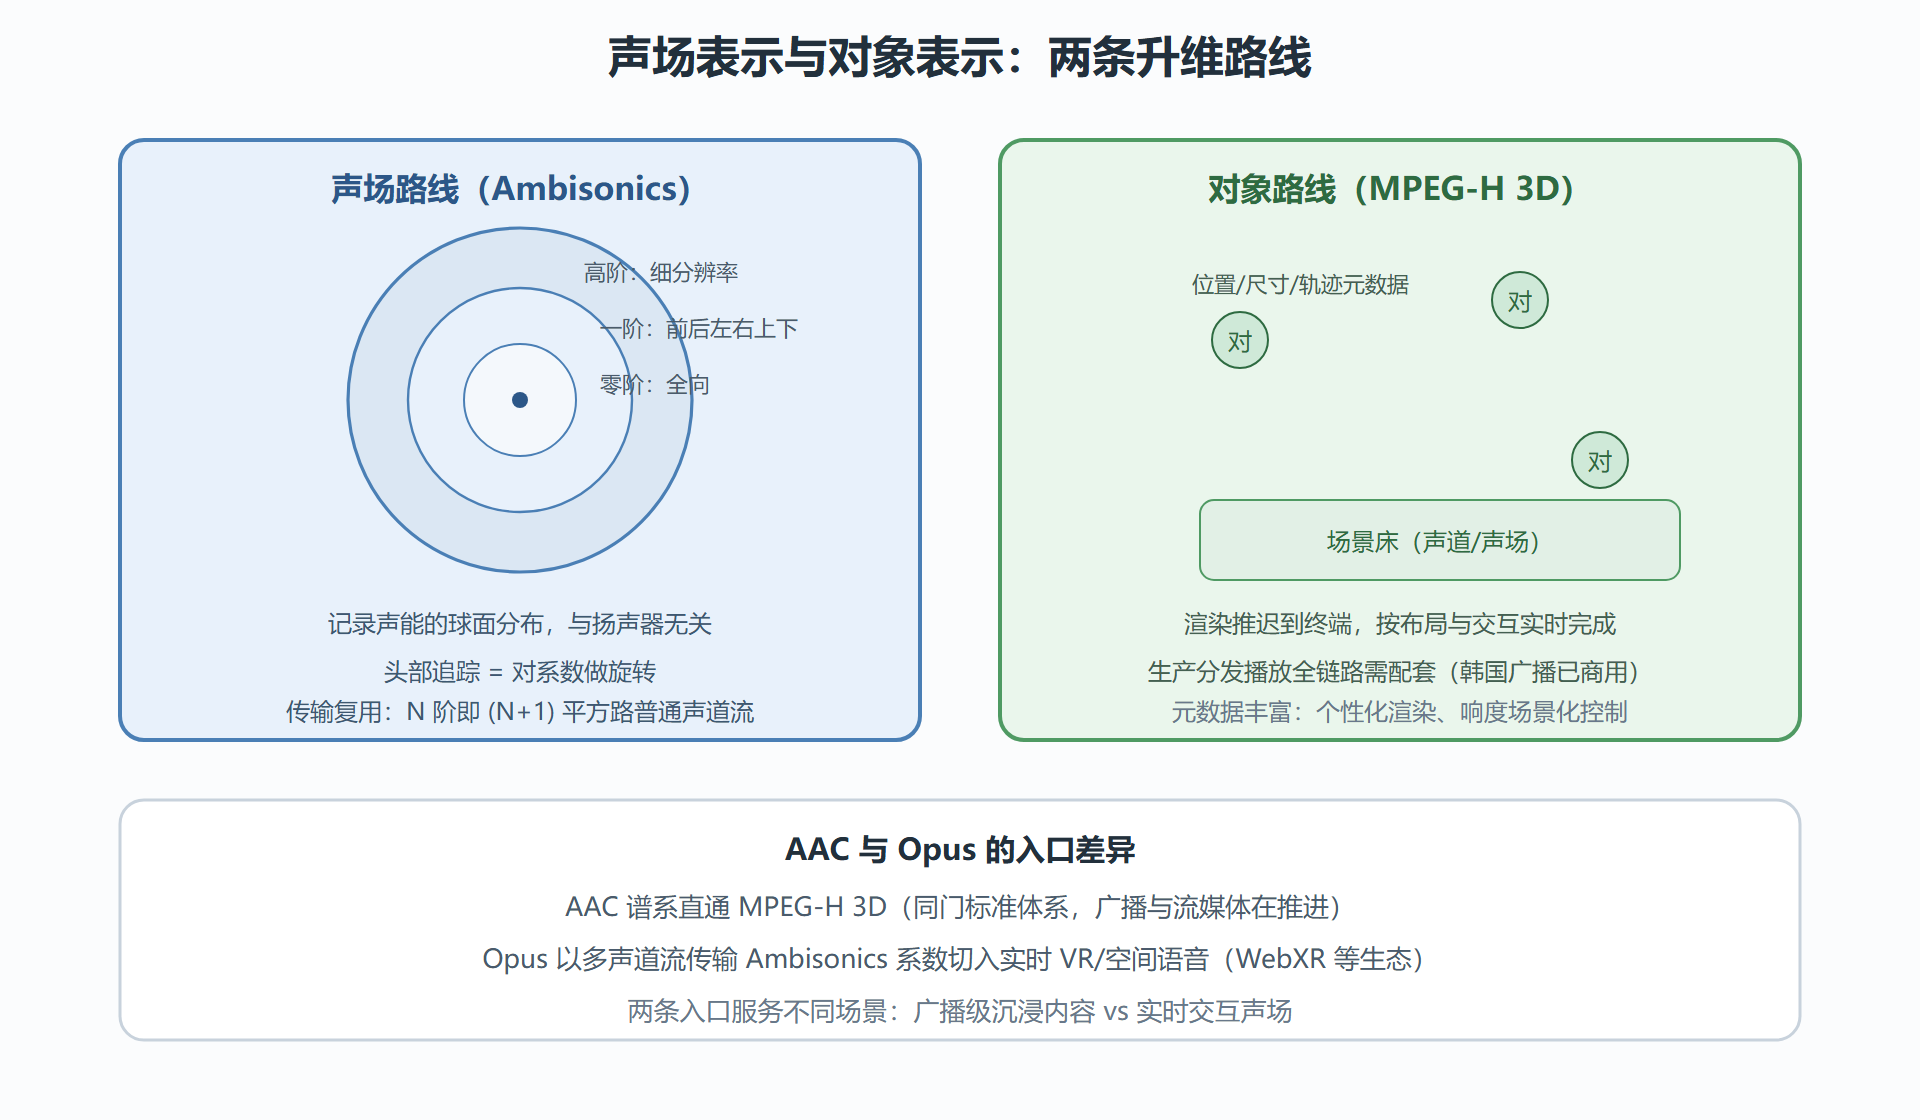
声场表示(Ambisonics 一族):不记录"哪个扬声器响",而记录声场在听音点的球谐分解系数。零阶是全向分量(近似单声道),一阶加三个方向梯度,阶数越高空间分辨率越高;N 阶完整系数有 (N+1)² 路。关键性质是与播放端解耦——同一份声场数据可渲染到耳机(配合头相关传递函数)、任意扬声器布局、甚至随头部转动实时旋转。VR 与 360 视频的音频底座多用此路线。
对象加场景(MPEG-H 3D 一族):把内容拆成若干"声源对象"(每个带位置、尺寸、轨迹元数据)加一张"场景床"(传统声道或声场),渲染在终端完成。创作者获得前所未有的灵活性(终端可按需交互、按扬声器布局渲染),代价是整个生产-分发-播放链路都要换代。
图:两种空间表示的对照
MPEG-H 3D:对象时代的广播标准
MPEG-H 3D Audio(ISO/IEC 23008-3)是对象路线的集大成者:支持声道床、对象、高阶声场三种元素的混合场景,配套完整的元数据体系(声源位置与几何、渲染提示、响度与动态范围控制)。它的杀手级应用在广播——韩国地面电视已用它开播沉浸式与个性化音频(听障用户可单独调对话增益就是元数据能力的直观展示),流媒体侧也有平台用它做多声道分发。
它继承的是 AAC 的标准化路径与产业关系:同在 MPEG 体系内、沿用类似的授权与演进节奏、面向"内容创作-广播分发-终端渲染"的传统链条。这既是优势(成熟的产业协同)也是约束(换代周期以年计)。
Opus 侧的空间占位:多声道即声场
Opus 没有专门的空间音频 Profile,但它的多声道支持(255 路)与低延迟特性让"传 Ambisonics 系数"成为实时场景的实用方案:N 阶声场的 (N+1)² 路系数,每路当普通声道编,接收端解码后做旋转与双耳渲染。一阶 Ambisonics 四路、二阶九路——在 Opus 的码率体系里都是可负担的(一阶 128 kbps 量级已可用)。WebXR 与社交 VR 的空间语音普遍走这条路线,传输效率与头部追踪延迟都由 Opus 的帧结构红利兜底。
代价是"哑通道"式传输:编码器不理解声道间的空间语义,系数间的相关性靠通用多声道编码利用,压缩效率不如"懂空间"的专用方案。这与第 1.4 节的分岔一脉相承——Opus 优先保证传输的弹性与低延迟,语义理解让给上层。
要不要上空间音频:判断清单
| 问题 | 若答"是" | 若答"否" |
|---|---|---|
| 内容是 VR/360/头部追踪场景? | 声场路线,实时用 Opus 多声道 | 传统立体声足够 |
| 面向广播级沉浸分发? | 评估 MPEG-H(按目标市场核对接收端) | AAC 5.1/7.1 或双耳立体声 |
| 用户需要个性化混音(对话增益独立调)? | 对象元数据路线 | 声道床即可 |
| 终端以耳机为主? | 双耳渲染(可先用立体声加 HRTF 验证需求) | 不必上高阶表示 |
一个务实建议:空间音频的很多收益(沉浸感、方位感)用"立体声加双耳渲染"就能拿到七成,先用它验证用户需求,再决定是否投入完整的空间链路——这是 5.1 节"按业务语义翻译参数"思想在新维度的复用。
阶数、码率与双耳渲染的工程账
把声场路线的参数账算实。阶数与通道数的对应:一阶 4 路、二阶 9 路、三阶 16 路、四阶 25 路;空间分辨率的经验值是一阶足以区分"前后左右"的方位层级、三阶支持十度级的定位精度(VR 头部追踪的常用档)。用 Opus 传输时,码率按"通道数 × 单路码率"粗算:一阶 4 路 × 32 kbps 即 128 kbps 得到可用的空间语音;三阶 16 路要压到单路 24 kbps 才能维持 384 kbps 的总量——注意各路系数能量不均(全向分量最重、高阶分量轻),按路差异化分配码率还有两三成的优化空间。
双耳渲染是另一笔账:声场系数经头相关传递函数卷积到左右耳,头部转动时系数要实时旋转(球谐旋转运算)。旋转延迟必须与编码延迟一起计入总预算——转动延迟超过约 30 ms,用户会感知声像"跟不上头",这是空间音频特有的延迟红线。渲染计算在现代手机 GPU/DSP 上是毫秒级负担,真正的瓶颈通常仍在传输与缓冲。
最后一条工程判断留给内容制作侧:空间音频的制作成本(采集设备或对象混音工具链)远高于立体声,且观众的感知收益随内容类型剧烈变化——现场音乐与竞技体育收益大,纯谈话类内容几乎无感。先小规模 A/B 验证观众感知,再决定制作链路的投入,是空间音频落地的标准节奏。
一条 VR 通话链路的完整走法
把空间音频的散件串成一条真实的 VR 通话链路。采集:每人一路单声道语音(Opus 24 kbps)加一路头部朝向数据(每秒几十次的小数据包,走控制通道)。远端合成:接收端把对端声源按虚拟位置(对方头像位置)渲染——用一阶 Ambisonics 声场加双耳渲染,声像随双方头部运动实时更新。关键账目:语音传输延迟与 5.4 的连麦轨同构(80 至 160 ms);声场旋转在本地完成、零传输延迟;方位感精度受声场阶数限制,社交场景一阶足够(需要"谁在左边说话",不需要"精确到几度")。
这条链路的取舍处处是 4.3 约束场的影子:语音用传统 Opus(低延迟、抗丢包),空间信息用声场表示(渲染权在终端),双耳渲染放在最末端(适配每个人的耳机与头型)。三层各司其职、互不越界——空间音频工程化的成熟形态,恰恰是"克制地使用空间技术",而不是把所有内容都塞进高阶声场。
💡 关键直觉:声道、声场、对象是三种"空间分辨率"递进的描述语言——声道绑定扬声器、声场绑定听音点、对象绑定声源本身。描述越自由,编码与生态的配套越贵;选哪种语言,本质是选"谁拥有渲染权"。
最后一节把所有时间线合流:LC3 与 USAC 如何吸收两代编码器的经验,下一个十年的格局会怎样写。