6.3 并行计算与内存估算
6.3 并行计算与内存估算
本节摘要:下单硬件和开算之前先做两件便宜的事:数自由度、估内存。本节给出从粗网格试算外推内存的完整流程、直接与迭代求解器的内存经验区间,以及降规模三板斧与多线程设置——让"算不动"在发生之前就被拦下。
先数自由度,再谈内存
自由度是模型规模的硬通货,来源在 5.1 讲过:节点未知数的个数。它不用手算,日志里每次计算都会报告,但等日志出来再发现内存不够就晚了。实用的预估流程四步:先用粗网格把模型算通(粗网格算不通的问题细网格更没戏);从日志读出这版网格的自由度数与峰值内存;估算加密计划带来的放大倍数——三维网格整体加密一档(特征尺寸减半)时,单元数与自由度大约翻八倍;按放大倍数外推正式网格的内存需求,留百分之五十余量后与机器配置对表。散热器算例演示一遍:常规网格约 5 万单元、12 万自由度(二阶四面体的自由度约为单元数的两倍上下),直接求解器跑掉约 2 GB;换 2.2 那版细网格,单元数翻倍、自由度翻倍,内存 4 GB 上下——都在普通工作站射程内,开算无虞。
内存都花在哪了?直接求解器时代答案几乎只有一个:矩阵分解的填充。原始刚度矩阵的稀疏结构尚且克制,分解过程中新产生的非零元会让内存远超矩阵本身;迭代求解器不做完整分解,预条件器只存近似的逆因子,这正是它省内存的根源。除此之外,几何与网格数据、解的存储(瞬态研究每个输出步都存一套解)是固定开销,瞬态模型文件动辄几个 GB 多半是解数据堆的。
图:自由度规模对应的内存阶梯
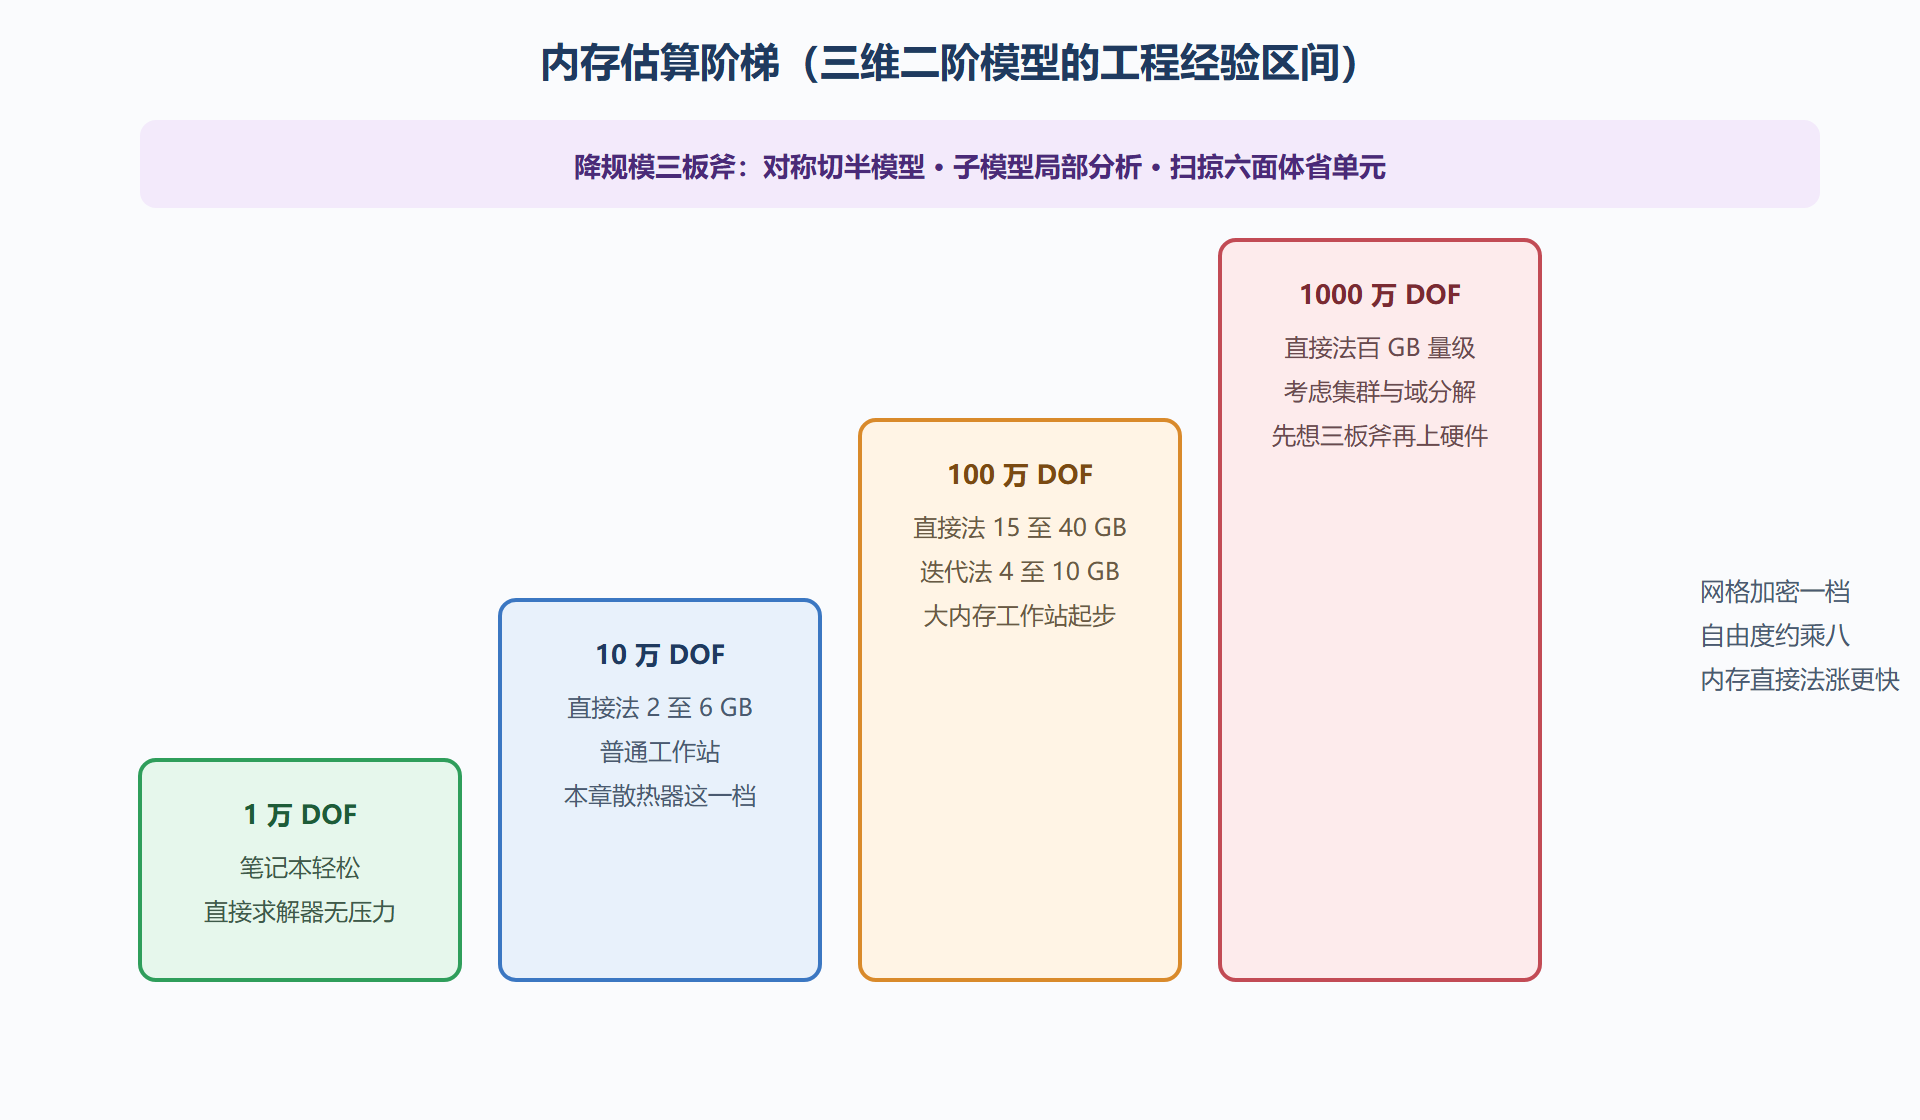
内存不够的三板斧与两换法
估算出来超预算,按代价从小到大的顺序动手术。第一斧,对称切分:模型几何、载荷、约束全对称时,取一半或四分之一建模,对称面上换对称条件(传热的零通量、结构的对称面约束),规模直接砍半再砍半——铜排本是全对称问题,教程里保留整条只为后处理直观。第二斧,子模型:整体用粗网格拿到场分布,再切出应力集中或热点区域用细网格精算,粗解作为子模型的边界输入;应力集中精度与整体计算成本就此解耦。第三斧,扫掠与映射网格:2.2 已经验证过,六面体网格用五分之一的单元达到更高精度,规模账同样成立。两换法在三板斧之后:换迭代求解器(内存立省过半,代价是配预条件的学习成本),换瞬态输出策略(只存关心时刻的解,文件体积立竿见影)。三板斧加两换都动过还超预算,才轮到加内存条或上集群——顺序反了就是用钱掩盖建模懒。
多线程与集群的现实收益
并行设置藏在选项→偏好设置→并行性里,线程数默认取物理核数,一般不用动;手动填写时记住"物理核"三个字,超线程的逻辑核对求解加速几乎无益。多核加速的物理上限在内存带宽:求解器是带宽饥渴型负载,四个核以内加速比接近线性,八个核以后收益明显衰减,十六核以上单机几乎吃满带宽——所以"核心多就快"只对到八核附近,再往上钱花在内存频率与通道数上比花在核数上划算。模型大到单机内存装不下时,集群与域分解(配合相应许可与模块)把矩阵切块分机求解,网络互联质量决定成败;对多数工程团队,更现实的路线是"降规模三板斧 + 云端大内存工作站",把百万自由度级别的模型交给一台大内存机器单机啃,比维护集群便宜也省心。新版本对部分求解环节提供了 GPU 加速,适用面随版本扩展,但选型时以官方当前支持列表为准,别为用上显卡而扭曲建模流程。
本节要点回顾
- 四步预估流程:粗网格算通 → 读日志自由度与峰值内存 → 加密一档乘八外推 → 留五成余量对表。
- 内存大头在直接分解的填充,迭代求解器省内存的根源是不做完整分解。
- 降规模三板斧:对称切半、子模型、扫掠网格;后接两换:迭代求解器、精简瞬态存档。
- 多核收益到八核附近封顶,瓶颈在内存带宽;更大规模走集群域分解或大内存单机。
- 规模判断先于计算发生:让"算不动"死在估算阶段,而不是死在三天三夜的挂机之后。
并行计算的内存估算是一门必修的预算课。以一个典型的三维稳态传热问题为例:自由度数为 N,直接求解器的内存需求约为 N 的平方到 1.5 次方(取决于填充模式),迭代求解器约为 N 的 1.1 到 1.3 倍。换算到具体数字:100 万自由度的模型,直接求解器约需 16-32 GB 内存,迭代求解器约需 8-12 GB。加上操作系统和 COMSOL 本身的开销,一台 64 GB 内存的机器大约能处理 200-300 万自由度的直接求解问题——超过这个规模就必须用迭代求解器或分布式并行。并行计算的另一个维度是 GPU 加速:COMSOL 支持 GPU 卸载非键合力的矩阵运算,对大规模线性系统(百万自由度以上)的加速比可达数倍,但对小模型(10 万自由度以下)GPU 的启动开销反而可能让速度变慢。GPU 加速的一个先决条件是 GPU 内存必须足够存放预条件子的数据——消费级 GPU 的 8-11 GB 显存通常只够处理 100 万自由度以下的模型。并行和 GPU 加速不是"有就能用"的即插即用——它们需要模型规模、硬件规格和求解器配置三者匹配才能发挥效果。
补一个并行效率的测量方法。并行加速比的定义是:单核时间除以多核时间。理想情况是线性加速(4 核快 4 倍),但实际中因为通信开销和负载不均,加速比通常只有 2-3 倍。测量方法:同一个模型分别在 1 核、2 核、4 核、8 核下求解,记录时间画加速比曲线——曲线偏离线性的拐点就是你的并行效率极限,超过这个核数只会浪费计算资源。影响并行效率的因素:模型大小(模型太小则通信开销占比高、加速差)、问题类型(传热比结构力学的并行效率好,因为传热的耦合弱)、以及域分解的均衡性(各域的自由度数差异大则负载不均)。实用建议:在购买更多计算资源之前先测量并行加速比——如果 4 核的加速比已经只有 2.5 倍,买 16 核的机器不会带来 4 倍的进一步提升,反而可能因为内存带宽瓶颈让效果更差。把钱花在内存和存储上通常比花在 CPU 核数上回报更高。
内存估算的一个更精确的方法是基于"稀疏矩阵的非零元个数"。对于三维有限元,每个节点的非零元个数取决于它的邻居节点数(通常 30-80 个),因此稀疏矩阵的非零元总数约为 N×50(N 为自由度数)。直接求解器的内存需求约为非零元数的 8 字节乘以填充因子(LU 分创会引入新的非零元,填充因子取决于网格质量和节点排序——好排序的填充因子约 2-5,差排序可达 10-50)。用公式估算:直接求解器内存 ≈ N × 50 × 8 字节 × 填充因子。代入 N = 100 万自由度、填充因子 3,得到约 12 GB——这与实际经验值一致。迭代求解器的内存需求远低于直接求解器(只需存储预条件矩阵,通常几个 N 的量级),但迭代次数受预条件子质量控制。实际操作中的一个技巧:在正式求解前先用 COMSOL 的内存估计工具(求解器节点右键→估计内存)预览内存需求——这个功能可以在不实际求解的情况下给出内存和时间的估算,帮助你在提交计算前判断是否需要优化模型或增加硬件资源。