1.2 从双螺旋到测序仪:读写能力的百年积累
1.2 从双螺旋到测序仪:读写能力的百年积累
本节摘要:DNA 存储的读写两端,各有一段漫长的前史。读取端从 1977 年桑格的双脱氧链终止法起步,经人类基因组计划的工程化锤炼,到 2005 年后高通量测序仪爆发;写入端从手工寡核苷酸合成走向柱式合成仪与芯片级并行合成。本节沿这两条装备演化线,说明一个关键结论:存储实验出现在 2012 年而非更早,不是观念滞后,而是读写通量恰好在那几年跨过了"存一本书"的门槛。
先说读:测序的四次换代
读是写的前提——你连写进去的序列都读不准,谈何存储。测序技术的每次换代,都直接改写了 DNA 存储实验的可行边界。
第一代是 1977 年弗雷德里克·桑格发明的双脱氧链终止法。原理说穿了很优雅:在体外复制 DNA 时掺入缺少特定羟基的双脱氧核苷酸,链一旦掺入这种"哑弹"就停止延伸;把四种终止反应并行做在凝胶上按长度分离,读出梯子一样的条带,就能推断序列。桑格法一炮开启了此后三十年的测序工业,人类基因组计划用的主要就是它的自动化版本。但对存储而言,第一代测序有两个硬伤:通量低——一台机器一天读不了几万碱基;成本高——计划层面每测一个碱基约要一美元。这个价格存数据,比黄金还贵。
第二代的分水岭是 2005 年前后商业化的大规模并行短读测序,业内称下一代测序。以 Illumina 的桥式扩增加可逆终止技术为代表:把千万条模板固定在流动槽表面,边合成边拍照,每一轮循环识别一种荧光碱基。通量的跃升是数量级式的——到 2010 年代初,一台机器一轮能产出数百吉碱基,单位成本比桑格时代低了五六个数量级。2012 年丘奇团队的存储实验、2013 年戈德曼团队的存储实验,读回端用的都是这类平台。换句话说,正是第二代测序把"读回"的账算平了,存储实验才从想象变成论文。
第三代与第四代是并行的两条线。单分子实时测序(PacBio 为代表)不再需要扩增放大,直接观察单个聚合酶工作,读长以千计、碱基修饰可辨。纳米孔测序(Oxford Nanopore 为代表)则彻底改变了物理方式:让单条 DNA 链穿过一个纳米尺度的蛋白孔,不同碱基组合阻塞孔道引起的电流变化不同,实时解码为序列——长读长、便携、实时,代价是原始错误率更高且以插入缺失为主。2014 年 MinION 掌上测序仪进入尝鲜用户手中,对存储研究者而言,这意味着读取端从此有了"工艺路线选项",编码方案开始要回答"你打算用哪种仪器读"这个问题。
再说写:从手工合成到芯片阵列
写入端的故事相对低调,但同等重要。寡核苷酸合成的主流化学是亚磷酰胺法:把固体载体上固定好的核苷酸链逐个循环"去保护—偶联—盖帽—氧化",每次循环在链尾接上一个碱基。这套化学 1980 年代就已成熟,早期是单柱合成,一条 oligo 一管,通量极低;1990 年代出现 96 孔板并行合成;2000 年代芯片级合成登场——用光刻或喷墨在硅片表面同时构筑数十万到百万级序列位点,通量又上两个台阶。
与存储直接相关的两个数字在这里形成合流:其一,合成读长。化学合成的单链精度随长度衰减,偶联效率哪怕高达 99.5%,合成 200 个碱基的全长产率也只剩三成多,所以商业合成长期停留在百碱基量级——这直接决定了存储系统必须"把大文件切碎成大量短序列",也决定了每条序列都要携带自己的地址索引。其二,合成成本。芯片并行合成把寡核苷酸池的单碱基价格从以美元计压到以千分之一美分计,丘奇团队 2012 年实验的写入成本才第一次可以承受。有趣的是,这次实验直接买的就是商业合成的寡核苷酸池——存储研究者第一次发现,生物学的"耗材供应链"顺手就能当"存储生产线"用。
图:读写能力积累时间线
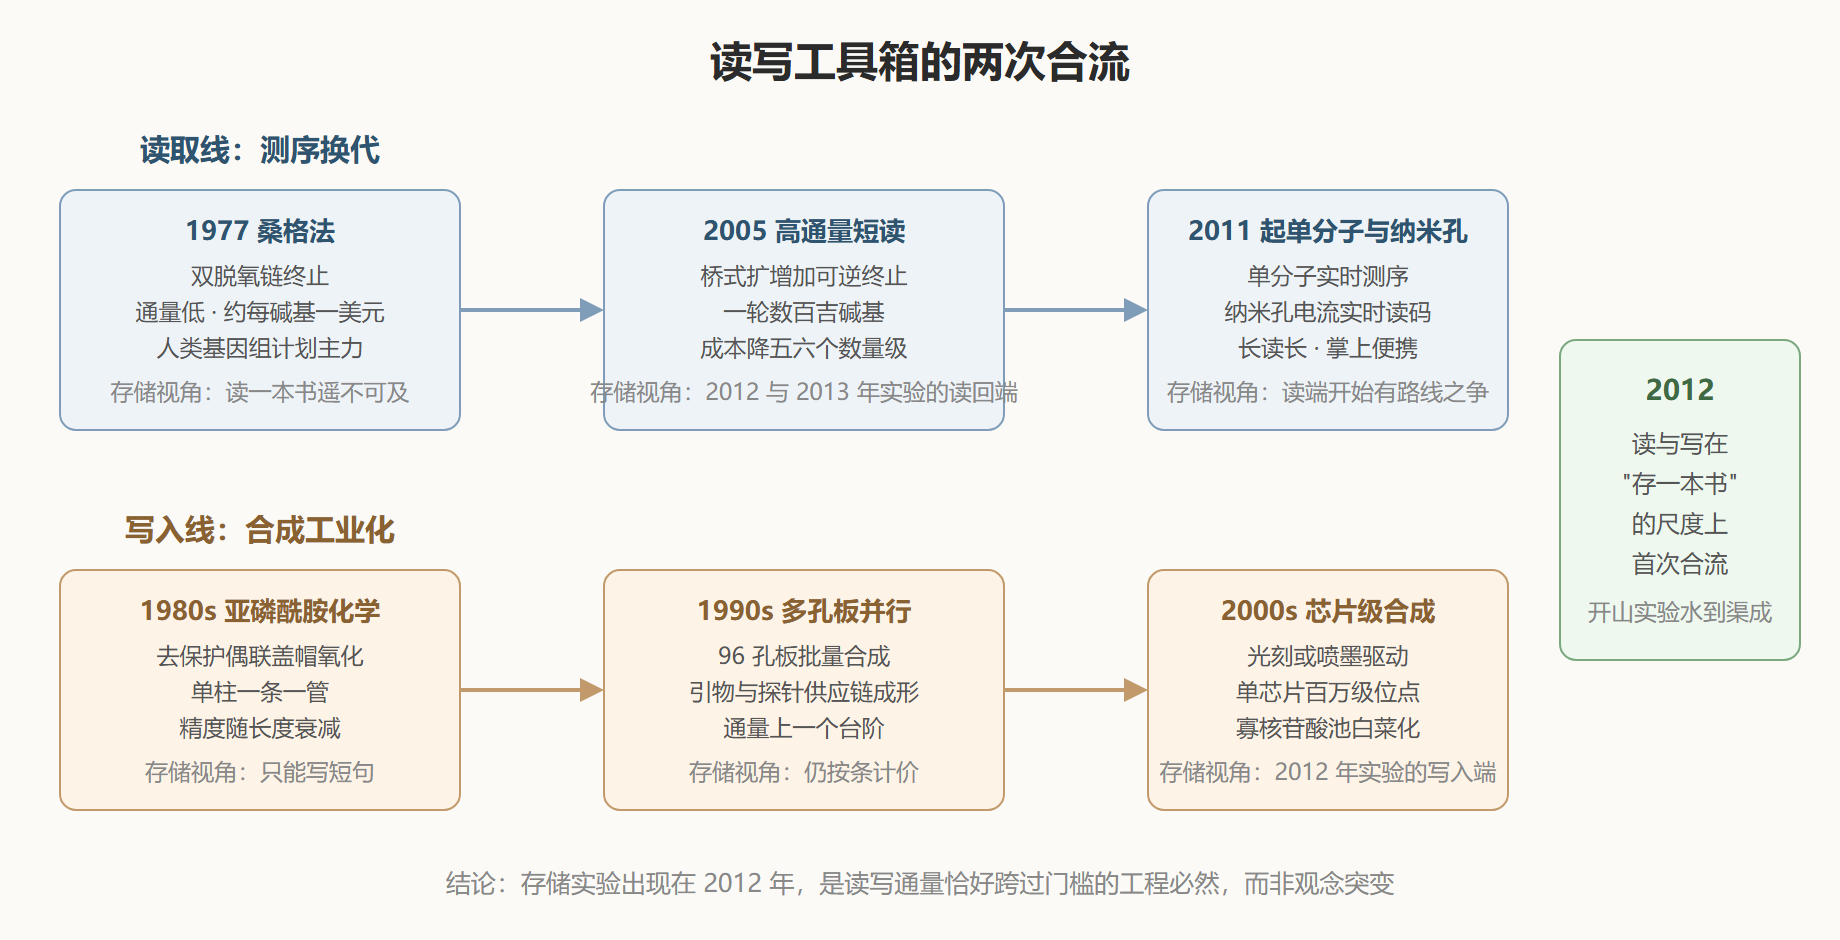
工具成熟如何改写存储叙事
把两条线放在一起看,会发现一个常被忽略的历史逻辑:DNA 存储的每一次跃迁,几乎都能追溯到读写装备的某次换代。高通量短读测序成熟,才有 2012 与 2013 年的两篇开山论文;纳米孔读长变长、错误谱系变化,才有编码界围绕约束与纠错的重新设计;芯片合成把寡核苷酸池变成便宜耗材,才有"存一本书"级别的实验;而 enzymatic 写入与半导体芯片合成,则是写入端正在发生的第四次换代——那是第四章与第六章的故事。
对学习者的启示很实际:读 DNA 存储领域的论文,先看实验用的合成平台与测序平台,再看编码方案。同样一套编码,在短读高精度仪器上与在纳米孔低精度仪器上的表现可能天差地别。脱离装备谈编码,就像脱离路况谈轮胎。
要点回顾
- 读取端走完四代:桑格法、大规模并行短读、单分子实时、纳米孔,通量与成本各跨若干数量级,2012 前后短读平台的成熟直接解锁了开山实验。
- 写入端沿"单柱—多孔板—芯片阵列"演化,亚磷酰胺化学至今仍是主流骨架;商业寡核苷酸池成了存储实验的第一条"生产线"。
- 合成读长受偶联效率的指数衰减限制,长期停留在百碱基量级——这解释了"文件必须切碎、每条序列带地址"的结构性设计。
- 存储技术的每次跃迁背后都是读写装备的换代:分析存储论文,先看平台,再看方案。
历史旁注:两次成本雪崩的相同配方
把测序与合成两条线放远看,会发现成本雪崩的配方惊人一致。第一步,化学或生物学原理定型(桑格法、亚磷酰胺法),此时通量低到只能做研究;第二步,工程化改造把并行度提上来(多孔板、毛细管阵列),成本降一到两个数量级;第三步,换物理原理(桥式扩增的光学成像、芯片上的位点阵列),把"一管一反应"变成"一片千反应",成本再降几个数量级;第四步,产业需求接棒——测序线是被基因组学与医疗市场养大的,合成线是被制药与诊断市场养大的。DNA 存储至今没有为一台核心仪器付过钱,它沿着两条现成曲线的交点一路搭车。
还有一个容易被忽略的细节值得记下:两篇开山论文的作者名单里,好几位的本职工作是合成与测序方法学,而不是"存储研究者"。这说明这项技术从出生起就是装备演化的副产品——理解了这一点,就能理解为什么第五、六章把装备竞赛与产业生态当作主线,而把编码方案当作变量。
三句话备忘
一句话记读取线:桑格法定原理,高通量定成本,纳米孔定形态——三代接力把"读"从实验室手艺变成基础设施。一句话记写入线:柱式定化学,多孔板定并行,芯片阵列定价格,半导体与酶法正在抢第四棒。一句话记合流:存储实验不是被谁发明出来的,而是当读写成本曲线各自跨过"存一本书"的门槛时自己长出来的——2012 年只是这个交点的名字。留一道思考题:若合成读长十年内涨到千碱基级,本节哪些结构性设计会最先松动?提示是从"文件必须切碎"这条假设想起,答案在第四章与第七章之间浮现。
读与写的账本都铺开了,下一节我们把介质本身的物理账算清楚:密度到底有多高、能放多久、以什么形态存在——这些数字是全书后续所有工程与经济讨论的底座。