- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
DNA存储技术:一部用分子写成的存储史
文集简介:这部教程以演化历史为主线,沿着这项技术的源头一路讲到大洋彼岸的产业前线——从费曼那场关于小尺度的著名演讲,到丘奇与戈德曼先后交出的开山之作,再到寡核苷酸池合成、酶法写入、纳米孔读取的管线成型,以及当下的半导体合成生物学路线。读完你将理解:这项技术为何出现在它出现的时间点,各个关键部件是被什么问题逼出来的,以及它还要跨过哪些坎才能真正走进机房。
最初,存储与记忆是同一件事。人类把要紧的话刻进龟甲、铸上青铜、抄在莎草纸上,载体换了又换,焦虑始终未变:刻下去的东西,能不能比刻它的人活得更久。DNA 存储技术把这个古老的追问,带到了一个反直觉的答案面前——用生命自己书写基因的分子来存放数据。把文件编码成以碱基为字母的序列,用合成仪写出来,封存进试管,需要时再上测序仪读回。它是密度冠绝所有介质的存储材料,也是唯一与每个生命同源的信息载体。
把时间拨回 1959 年 12 月的加州理工学院。物理学家理查德·费曼在美国物理学会年会上做了那场后来被反复引用的演讲《底部还有很大空间》。他估算:把当时全世界印刷在书页上的文字全部缩小后,可以写进一个边长约百分之一英寸的立方体里。这个当时听来像戏言的数字,其实是 DNA 存储的第一份"需求文档"——它第一次把"信息应该存放得更密"上升为值得严肃对待的物理问题。此后半个多世纪,这条线索时断时续:1964 年苏联工程师提出用大分子记录信息的设想;1988 年 MIT 的艺术家乔·戴维斯把一个微缩符号写入大肠杆菌;1994 年计算机科学家伦纳德·阿德曼用试管里的 DNA 解了一道图论题。直到 2012 年,哈佛的乔治·丘奇团队把一本五兆字节的书写入 DNA,次年欧洲生物信息研究所的尼克·戈德曼团队跟上并给出更稳健的工程方案,这条沉睡的线索才真正苏醒。
此后十年,故事的主角从证明可行性转向搭建流水线:纠错码与随机访问把分子信道驯服成可用的存储信道;寡核苷酸池合成把写入成本拉低了几个数量级;纳米孔测序改变了读取的物理方式;2021 年 DNA 数据存储联盟成立,标准开始收紧;2024 年,微软把合成化学搬上半导体芯片,揭示了这条技术路线下一个十年的方向。本教程的全部章节,就沿着这条时间主线铺开。
为什么用"演化历史"的方式讲技术
市面上讲 DNA 存储的材料常有两种写法:一种是论文综述式,堆术语和指标;另一种是科普式,只讲密度惊人的数字。我们选择第三条路——按时间顺序,把每个技术部件放回它被发明的年代,讲清楚"当时卡在哪、谁用什么办法打开了局面、代价是什么"。这样组织有三个理由。
其一,这项技术是典型的"约束驱动"产物。碱基编码为什么不能直接按二进制映射?因为同聚物会让合成与测序出错。为什么需要喷泉码?因为寡核苷酸丢失是常态而非异常。不知道这些约束从哪来,就没法理解设计的取舍。其二,演化视角天然适合判断趋势。看懂了合成成本十年下降的曲线,就明白为什么产业界现在才认真讨论冷数据归档;看懂了纳米孔读长对编码方式的反向影响,就明白为什么编码标准必须与装备演进同步。其三,对工程实践者而言,历史提供了最完整的失败样本库——那些被证伪的路线(比如早期直接编码的高错误率方案)同样有价值。
全书结构与知识地图
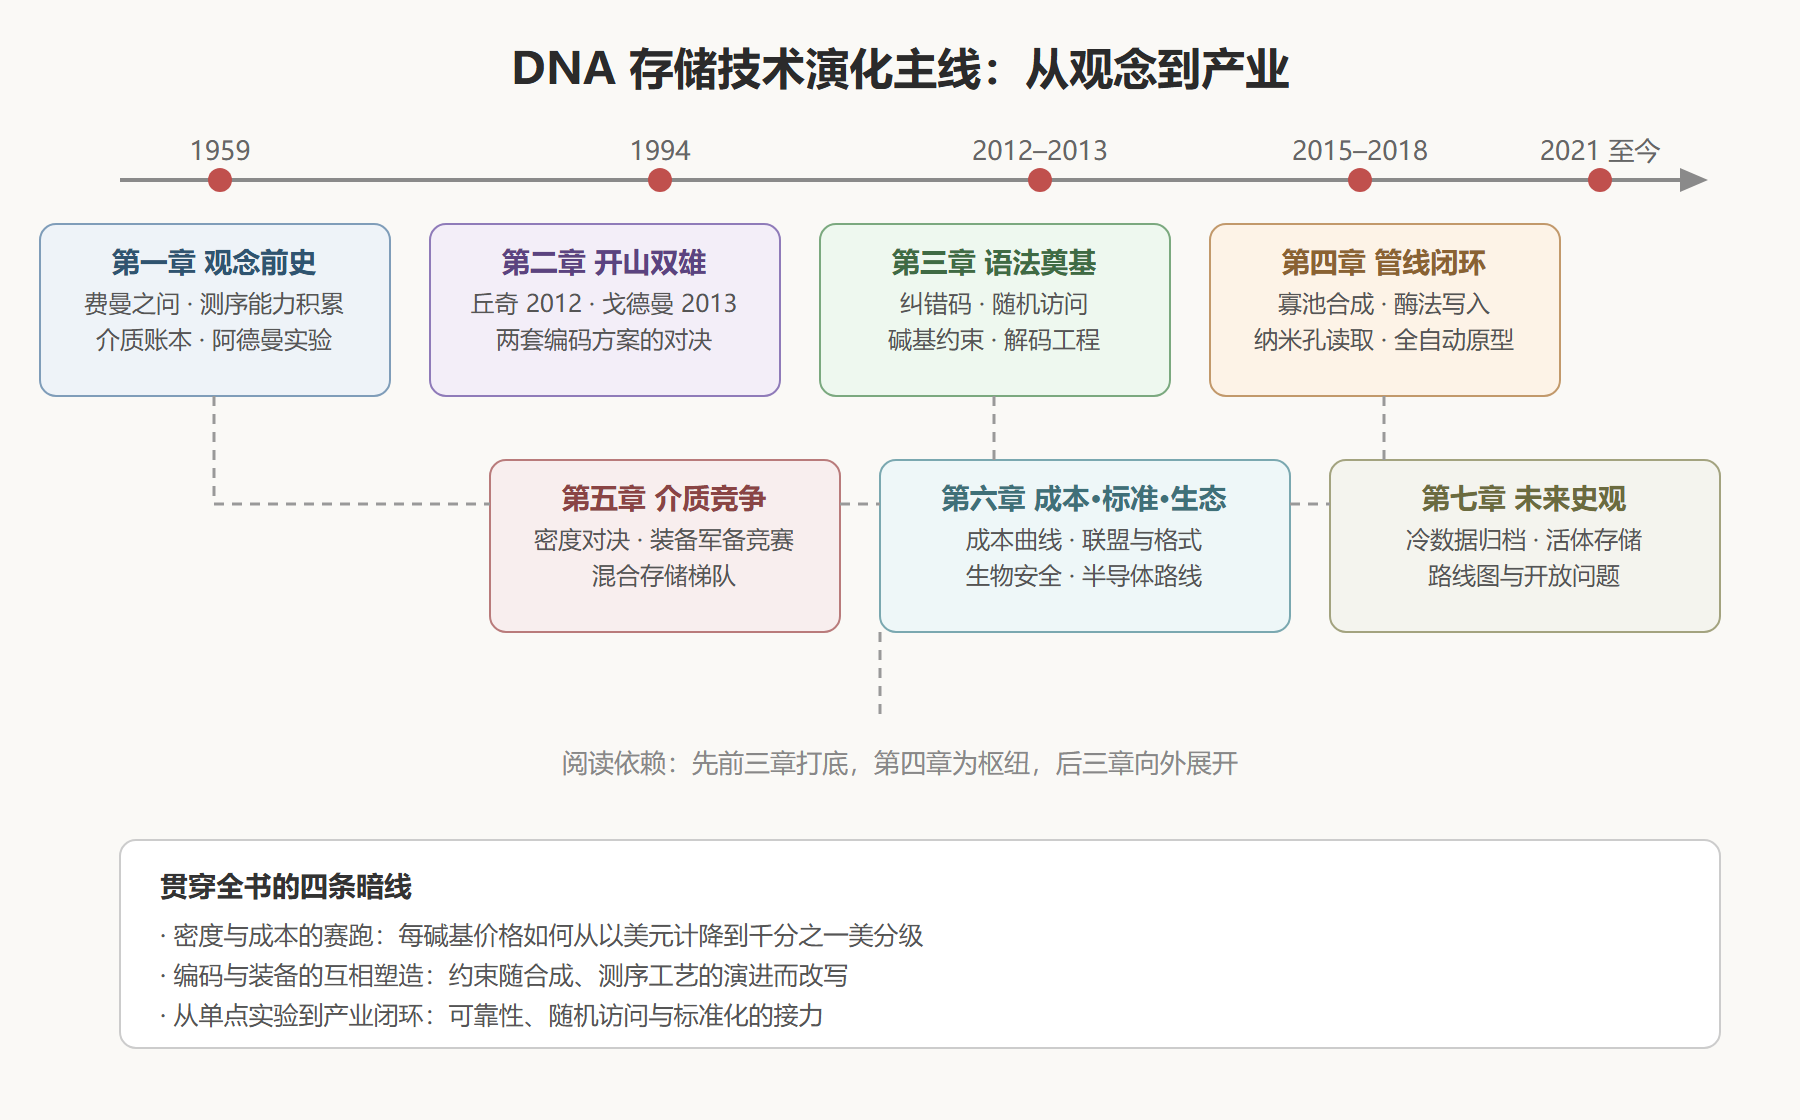
全书七章大致对应这项技术的七个发展阶段,但章节之间不是简单的时间罗列,而是"问题—解法—新问题"的接力。下面这张全册知识地图给出了学习的先后依赖:第一章到第三章是理解一切的基础(观念、介质属性、编码语法),第四章的管线闭环是全书枢纽,第五到第七章则是管线成熟后向外展开的工程、经济与未来图景。
图:全册知识地图——沿时间线的技术演化
这部教程适合谁
做存储系统、归档基础设施的工程师,可以从第一、四、五章直接获得与磁带库对标的技术账本;生物信息与合成生物学方向的学生,建议完整跟随主线,特别留意第三章——编码语法是这个领域里最接近"内功"的部分;关注科技战略与投资的研究者,第六章的成本与标准分析提供了判断产业拐点的坐标系。每个章节都附有可检验的学习目标与具体数字,你可以随时跳入自己关心的年代,也可以从头顺着时间线读完。
一点提醒:DNA 存储至今仍是一门快速演化的技术,本教程里的成本、通量数字反映的是写作时可查证的行业口径,量级可靠、具体值会过时。学会用"约束—解法—代价"的框架去审视新的论文与产品,比记住任何一个数字都重要。这也是历史视角能给读者的最大礼物。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...