1.4 阿德曼的1994:DNA计算的史前史
1.4 阿德曼的1994:DNA计算的史前史
本节摘要:1994 年 11 月,计算机科学家伦纳德·阿德曼在《科学》发表论文,用试管里的一管 DNA 求解了一个七节点有向图的哈密顿路径问题。这场实验是分子计算的原点,也第一次系统展示了 DNA 作为信息载体的并行威力与工程麻烦。本节完整还原实验的每一步操作,并解释它如何为 DNA 存储划定了"保留并行性、驯服不可控性"的议程。
问题先摆出来
哈密顿路径问题是计算理论里的经典难题:给定一张有向图,问是否存在一条恰好经过每个顶点一次的路径。顶点一多,穷举就会爆炸,它与旅行商问题同属 NP 类。阿德曼选了一个只有七个顶点的迷你实例——对一个数字计算机来说这是小菜一碟,他偏要用 DNA 来解。用意不在比快,而在验证一个猜想:分子的杂交反应天然具备海量并行的选择性,也许能把"计算"从硅片搬进试管。
他的编码方案直白得漂亮。每个顶点用一段二十个碱基的单链 DNA 表示,且顶点名的首位与末位碱基按规则设计,保证不同顶点不会互相混淆;每条有向边则用一段二十个碱基的互补链表示,其中前十个碱基是起点顶点名的后半段的补链,后十个碱基是终点顶点名的前半段的补链。这样一来,当所有边的 DNA 与所有顶点的 DNA 混在同一个试管里时,碱基互补配对会自动把"边链"搭在相邻两条"顶点链"之间——随机路径就这样在分子层面自发生长出来。
实验全程:七天的一管化学反应
编码只是开始,真正的解在四步生化操作之后浮现。
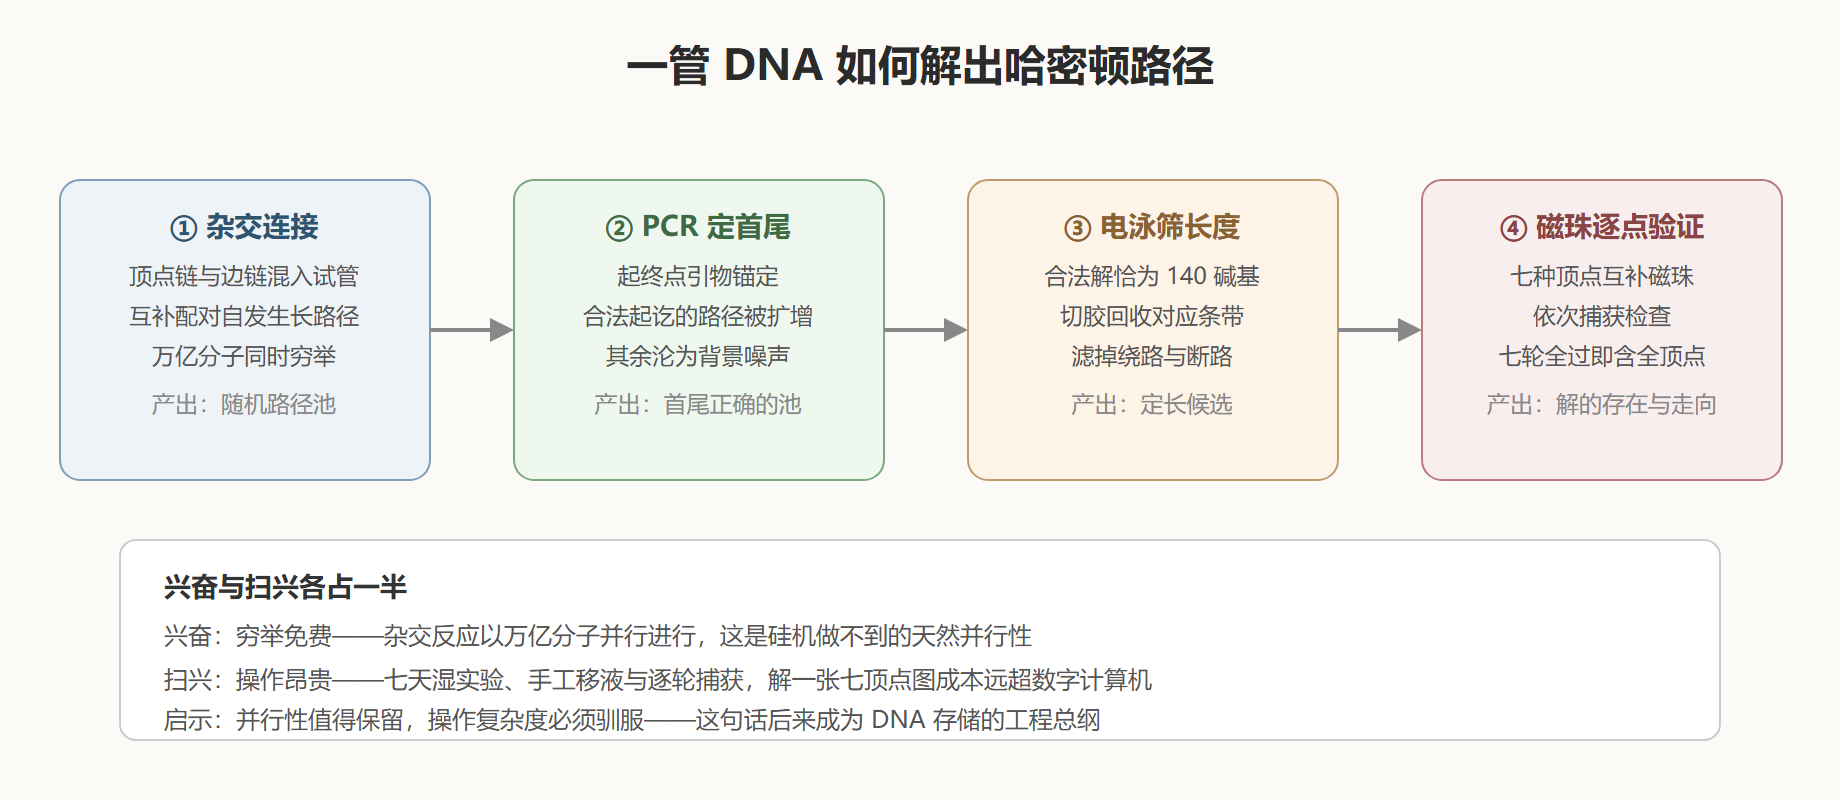
第一步,生成随机路径池。把足量的顶点链与边链混合,加入连接酶恒温反应——任何合法相邻的顶点都会被边链"焊接"起来,构成长短不一的随机路径。这一步是分子并行的精髓:试管里数以万亿计的分子同时在进行"穷举",阿德曼后来自嘲说,这是人类做过的最大规模的并行计算,只是指令集只有一条——配对。
第二步,用 PCR 筛出起点与终点正确的链。设计一对引物,一端锚定起点顶点、另一端锚定终点顶点,只有从起点走到终点的完整路径会被指数级扩增,其余分子沦为背景。
第三步,用凝胶电泳筛长度。合法答案恰好覆盖七个顶点、长度为一百四十个碱基;电泳按长度分离,把对应条带切出来回收。这一步筛掉了走进死胡同的短路径和重复经过顶点的长路径。
第四步,逐个顶点"点名"。把回收的 DNA 与固定了某顶点互补链的磁珠温育,只有含该顶点的分子被捕获;七轮磁珠捕获依次进行,每轮过后检测上清是否仍有分子留存。七轮全过,说明幸存者包含全部七个顶点——答案存在。阿德曼随后测序确认了路径的具体走向。
用今天工程师熟悉的方式重述这个算法,大致是四行伪代码:
1. 混合全部顶点链与边链,让连接酶焊接出海量随机路径 // 并行穷举 2. 以起点与终点为引物做 PCR,只放大首尾正确的路径 // 约束满足 3. 凝胶电泳,回收长度恰为 140 碱基的产物 // 长度过滤 4. 依次用七种顶点磁珠捕获,七轮全中即为解 // 覆盖检查
图:阿德曼实验的四步筛选流水线
一管化学留下的两条遗产
以"计算速度"论,这场实验输了,而且输得毫无悬念。七天湿实验解七顶点图,任何一台计算器都能在微秒内完成同样的事,且图规模每加一个顶点,湿实验的分子用量与操作轮数还要继续涨。学术圈的热度在几年内就退了潮。但站在存储史的立场上回望,这场实验留下两条极其值钱的遗产。
第一条是方法论层面的:它证明了序列可以被当作"可执行的信息"来操作——杂交、连接、扩增、捕获,每一个分子生物学常规动作都可以被赋予计算语义。后来存储系统里的随机访问(用引物在分子池里"点名"),本质上就是阿德曼磁珠捕获步骤的直接后代。第二条是工程议程层面的:实验把湿操作的所有毛病暴露得淋漓尽致——每一步都要手工干预,错误会沿着步骤串门,产物无法精确计量。此后的研究者从此明白:分子并行性是资产,湿操作复杂性是负债;任何想在这个方向上做工程的人,第一要务都是把负债压缩到只发生在"写入一次"和"读取一次"两端,中间的保存期则是完全静态的零维护状态。存储,恰恰是唯一满足这个苛刻要求的形态。
换句话说,DNA 计算的挫折直接把方向让渡给了 DNA 存储:既然算不动,那就只存。这个从计算到存储的方向修正,正是 2012 年开山实验的前传。
要点回顾
- 阿德曼 1994 年的实验用顶点链与边链的互补配对实现了分子层面的并行穷举,配合 PCR、电泳与磁珠捕获四步筛选,解出七顶点图的哈密顿路径。
- 编码方案的核心技巧是"名字首尾碱基的交错设计",它让边链只能搭在正确的相邻顶点之间——这是最早的生化约束设计思想。
- 实验输在速度与操作成本,赢在证明了分子并行的真实存在,并把"保留并行性、驯服不可控性"的议程摆在了所有后来者面前。
- 随机访问、约束编码、纠错筛选——今天存储系统的核心概念,都能在这场实验里找到原型。
再深一层:并行性的真实账目
阿德曼实验常被描述为"万亿路并行",值得把这个数字掰开看清楚。试管里参与反应的分子数以万亿计,听起来远超任何超级计算机的核数;但每条"处理器"的工作只持续一次杂交反应,且所有分子执行的是同一套化学规则——它不是通用并行计算,而是一次性的、单指令的大规模枚举。真正让它在新奇性之外仍有价值的,是枚举结果的筛选机制:PCR、电泳、磁珠捕获三步,每一步都在把"解空间"压缩一个数量级以上。把这套语言翻译到存储语境:分子的写入天然并行(一批合成几十万条序列),但筛选与纠错需要精心设计——今天的随机访问与纠错码,本质上就是阿德曼那三步筛选的工程化后代。
还有一个历史细节常被忽略:阿德曼在实验成功后并没有顺势成立公司,而是转头去研究分子计算的极限问题——他想知道这条路的天花板在哪里。答案令人清醒:分子计算要在通用性上与硅竞争,需要应对错误率、接口与规模化的三重放大,每一重都比演示难百倍。这个清醒的判断为整个分子信息领域省下了大量资源,也让存储——一个只需单向可靠、不需通用计算的方向——顺利接过了火炬。
旁注
阿德曼实验还有一个常被引用错的细节:媒体当年渲染"DNA 计算机将淘汰硅芯片",但论文原文的措辞相当克制,通篇在讲"组合化学的并行潜力"而非"通用计算的替代品"。把演示误读成路线图,是新兴技术叙事里最常见的放大器效应。三十年后回看,分子计算确实没有淘汰硅,却以存储的形态把并行性留在了产业叙事里——这不是实验的失败,而是叙事纪律的价值:边界清晰的主张,才能在几十年尺度上持续兑现。
观念、工具、算法三条支流至此全部到齐。下一章进入正题:2012 与 2013 年,丘奇与戈德曼的两篇论文如何把"存一本书"从口号变成经过同行评议的事实。