2.1 DNA 读取、编写与编辑
2.1 DNA 读取、编写与编辑:三大工具族的全景
本节摘要:合成生物学的原料操作可归为三族:读取(测序,回答"天然序列是什么")、编写(合成与组装,回答"设计的序列怎么造出来")、编辑(原位改造,回答"能不能直接在基因组上动刀")。本节盘点三族工具的原理要点、成本曲线与选型逻辑,并给出"什么时候该合成、什么时候该编辑"的工程判据。
一、问题与直觉
接到"砷感应装置"任务的团队首先要面对一个朴素的问题:感应砷的蛋白序列从哪里来?答案是先去公共数据库里找天然存在的砷感应启动子家族——这需要读取能力;找到之后序列要按宿主的密码子偏好优化、按标准接口加接头——这需要编写能力;如果想把改造过的序列直接嵌进宿主染色体而不是质粒上——这需要编辑能力。三族工具各管一段,缺一段主线就断。本节在知识体系中处于"原料供应"的位置:第 3 章的线路、第 4 章的底盘改造,全部建立在这三族工具之上。
二、读取:测序的三次换代
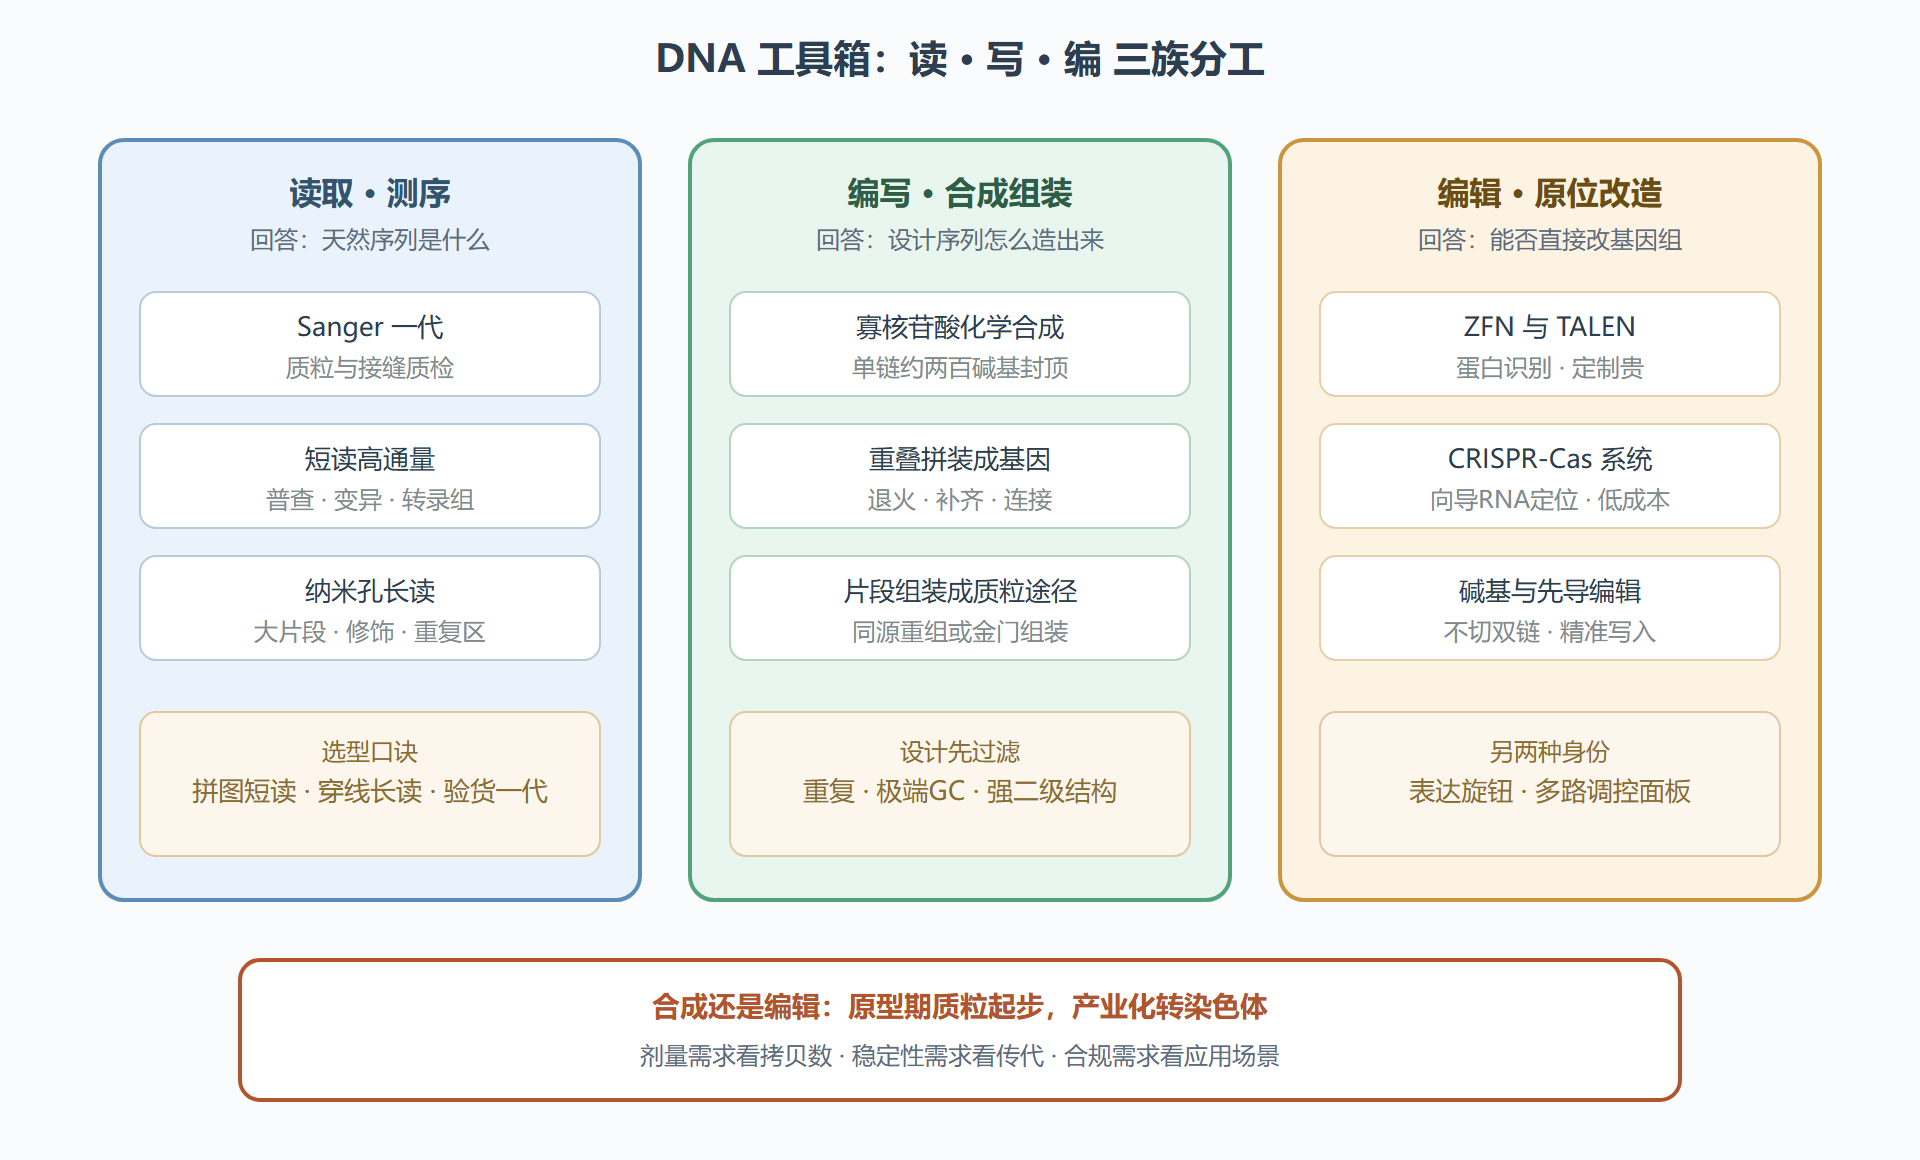
第一代 Sanger 测序靠链终止法逐个确认碱基,读长短但准确率极高,至今仍是"质检一小段"的默认手段——组装完一个质粒,送样测三个反应确认接缝,用的是它。第二代短读长高通量测序(ILLUMINA 一类)把人类基因组的成本从数十亿美元打到千元级,靠的是桥式扩增与大规模并行;代价是读长只有一两百碱基,拼接复杂序列区域时力不从心。第三代单分子测序(纳米孔与单分子实时)读长可达数十万碱基,能直接穿过重复序列与甲基化修饰——纳米孔甚至能在测序的同时读出碱基的化学修饰,这对合成生物学的表观调控研究价值很大。
选型逻辑可以用一句话概括:拼图选短读,穿线选长读,验货选一代。宏基因组样本、大质粒、人工基因组的完整确认,优先长读;表达量与变异频率普查,选短读;克隆质检,选 Sanger。
三、编写:从寡核苷酸到完整基因组
编写能力的基础是固相亚磷酰胺化学合成,它决定了单条寡核苷酸链的长度上限(约两百碱基,越长错误率越高)。工程上的做法是把目标基因拆成几十条重叠的寡核苷酸,靠重叠区退火、聚合酶补齐、连接酶封口,拼成完整双链——这就是基因合成的底层逻辑。合成公司再把它克隆进标准载体,测序验证后以冻干质粒或甘油菌的形式交付。今天的行情是一条几千碱基的基因一周左右到货,成本按碱基对计价;这个价格曲线正是 1.2 节"加速期"的经济学注脚。
合成之后还有组装:把多个合成片段按设计顺序拼成质粒或途径,方法从经典的酶切连接、到 Gibson 等同源重组法、再到金门组装,第 5.2 节会从 DBTL 视角再盘一次。编写这条线的两个工程细节常被低估:一是合成序列要先过滤——重复序列、极端 GC 含量、强二级结构都会让合成失败或组装出错,设计阶段就要规避;二是交付形态要匹配下游——下游要做的是蛋白纯化还是线路调试,决定了选低拷贝还是高拷贝骨架、要不要加溶解标签。
四、编辑:在原位动刀的三代工具
编辑解决的是另一个问题:不动质粒,直接改基因组。第一代是 ZFN 与 TALEN,靠蛋白模块识别靶序列,定制成本高、周期长。第二代 CRISPR-Cas9 改用一段向导 RNA 定位,把"定制识别模块"的成本降到合成一条 RNA 的水平——编辑能力的民主化由此而来。第三代是精准编辑:碱基编辑不切断双链就能完成单个碱基的转换,先导编辑则能写入小段插入缺失,把编辑精度再推一层。
CRISPR 在合成生物学里还有超越编辑的用法:失活版的 Cas 蛋白融合转录调控域,可以充当可编程的基因表达旋钮;用向导 RNA 阵列做多路调控,一条线路同时压低几个基因的表达——这些应用让 CRISPR 从"手术刀"变成了"控制面板"。
五、工程判据:合成还是编辑
给一个实际场景:要把优化过的砷感应模块放进工程菌株。方案一是组装到质粒上,方案二编辑进染色体。判据有三条:表达量需求(质粒拷贝数带来的剂量优势)、稳定性需求(无选择压力下质粒会丢,染色体稳定)、合规与风险(医用与环境释放场景对基因操作的 containment 要求)。实验室原型几乎都从质粒起步,走向产业与环境应用时再转入染色体——这个次序本身就是一条设计纪律。
图 4 读、写、编三族工具的分工与选型地图
六、一次选型的完整推演
回到砷感应项目,把三族工具串成一次完整操作。读取:在数据库里检索到天然砷感应启动子家族,短读测序确认候选启动子序列与文献一致,排除样本传代引入的点突变。编写:把配套的阻遏蛋白编码序列按大肠杆菌密码子偏好优化,去掉一个内部终止子与一段重复回文,交给合成公司;到货的冻干质粒经 Sanger 全长确认。编辑:原型期先在质粒上调试线路;性能达标后,用 CRISPR 辅助重组把模块整合进染色体的安全港位点,甩掉抗性标记——为将来可能的环境应用解除一处合规隐患。三段操作各有明确的验收标准:测序比对一致、合成序列无错、整合位点两端连接正确且菌株无抗性仍稳定表达。
这个推演里藏着一个值得记取的次序:先读后写、先质粒后染色体、先原型后合规。顺序反了的代价,通常是数周返工。
补充:密码子优化的三件事与两个陷阱
正文提到砷项目"按密码子偏好优化",展开说清楚。三件事:偏好档位对齐——把异源基因的密码子换成宿主高频档位,提升翻译顺畅度;顺式元件清理——移除内部的隐秘剪接位点、提前终止框与强二级结构区,这些在原宿主无害的"暗物质"在新宿主里可能捣乱;表达节奏保留——不是越快越好,某些蛋白的折叠需要翻译速度的快慢交替(共翻译折叠),一刀切的高速翻译反而降低可溶比例。两个陷阱:一是过度优化——全部换成最高频密码子可能丢失节奏;二是只优化编码区——信使核糖核酸的非翻译区与起始窗口的二级结构对表达的影响不亚于密码子档位,合成订单前要把整条转录本过一遍结构预测。密码子优化不是一键美化,是带生物学判断的序列编辑——这也是为什么优化结果要写进设计文档:它改变了序列本身。
问题:基因合成的订单,设计端要多做什么?
下单前过一遍"合成友好性清单":重复序列与极端碱基含量会让合成失败或加价,强二级结构影响组装;序列里的隐秘酶切位点要与下游组装方案核对(别让合成出来的基因带着你计划用的粘端序列)。下单时确认交付形态——克隆进什么骨架、抗性是什么、是否附测序结果——这些决定到货后能不能直接进流程。一份合格的订单是设计的延伸,不是随便发个序列文件。
本节要点回顾
- 读取三代的分工:一代验货、短读普查、长读穿线,选型看任务形状。
- 编写的物理上限由寡核苷酸化学决定,工程做法是拆链重叠拼装;设计阶段就要过滤合成不友好序列。
- 编辑三代工具的演进主线是"定位成本"的下降;CRISPR 兼任表达调控面板。
- 判据:剂量看拷贝、稳定看传代、合规看场景;原型用质粒,产业进染色体。
序列有了、写下来也不难了,但零散的零件还不算"元件"。下一节看标准化接口怎么把一堆序列变成可复用的工程零件。