6.1 存储层级入侵者:四个家族卡进哪条缝
6.1 存储层级入侵者:四个家族卡进哪条缝
本节摘要:存储级内存(SCM)是非易失器件在层级里最现实的落点。本节标注四家族在存储金字塔上的攻防位置:MRAM 攻末级缓存、PCM/RRAM 攻 SCM、FeRAM 攻专用缓冲,并解释各自被更高层级挡住的机制原因。
存储级内存,指的是一条缝而不是一种器件
SCM(Storage-Class Memory)指填在 DRAM 与 NAND 之间的层级:字节寻址或细粒度寻址、非易失、延迟 100 ns~3 μs、位成本低于 DRAM。这条缝的存在理由很硬:DRAM 掉电丢数据且密度到顶,NAND 按块擦写且延迟太慢,中间的"非易失内存"位置长期空缺——数据库检查点、内存计算的热数据层、持久化键值存储都眼巴巴等着。忆阻器家族的存储革命,第一战场就是这条缝,而不是宣传语里"取代 DRAM/取代 NAND"的整体战争。
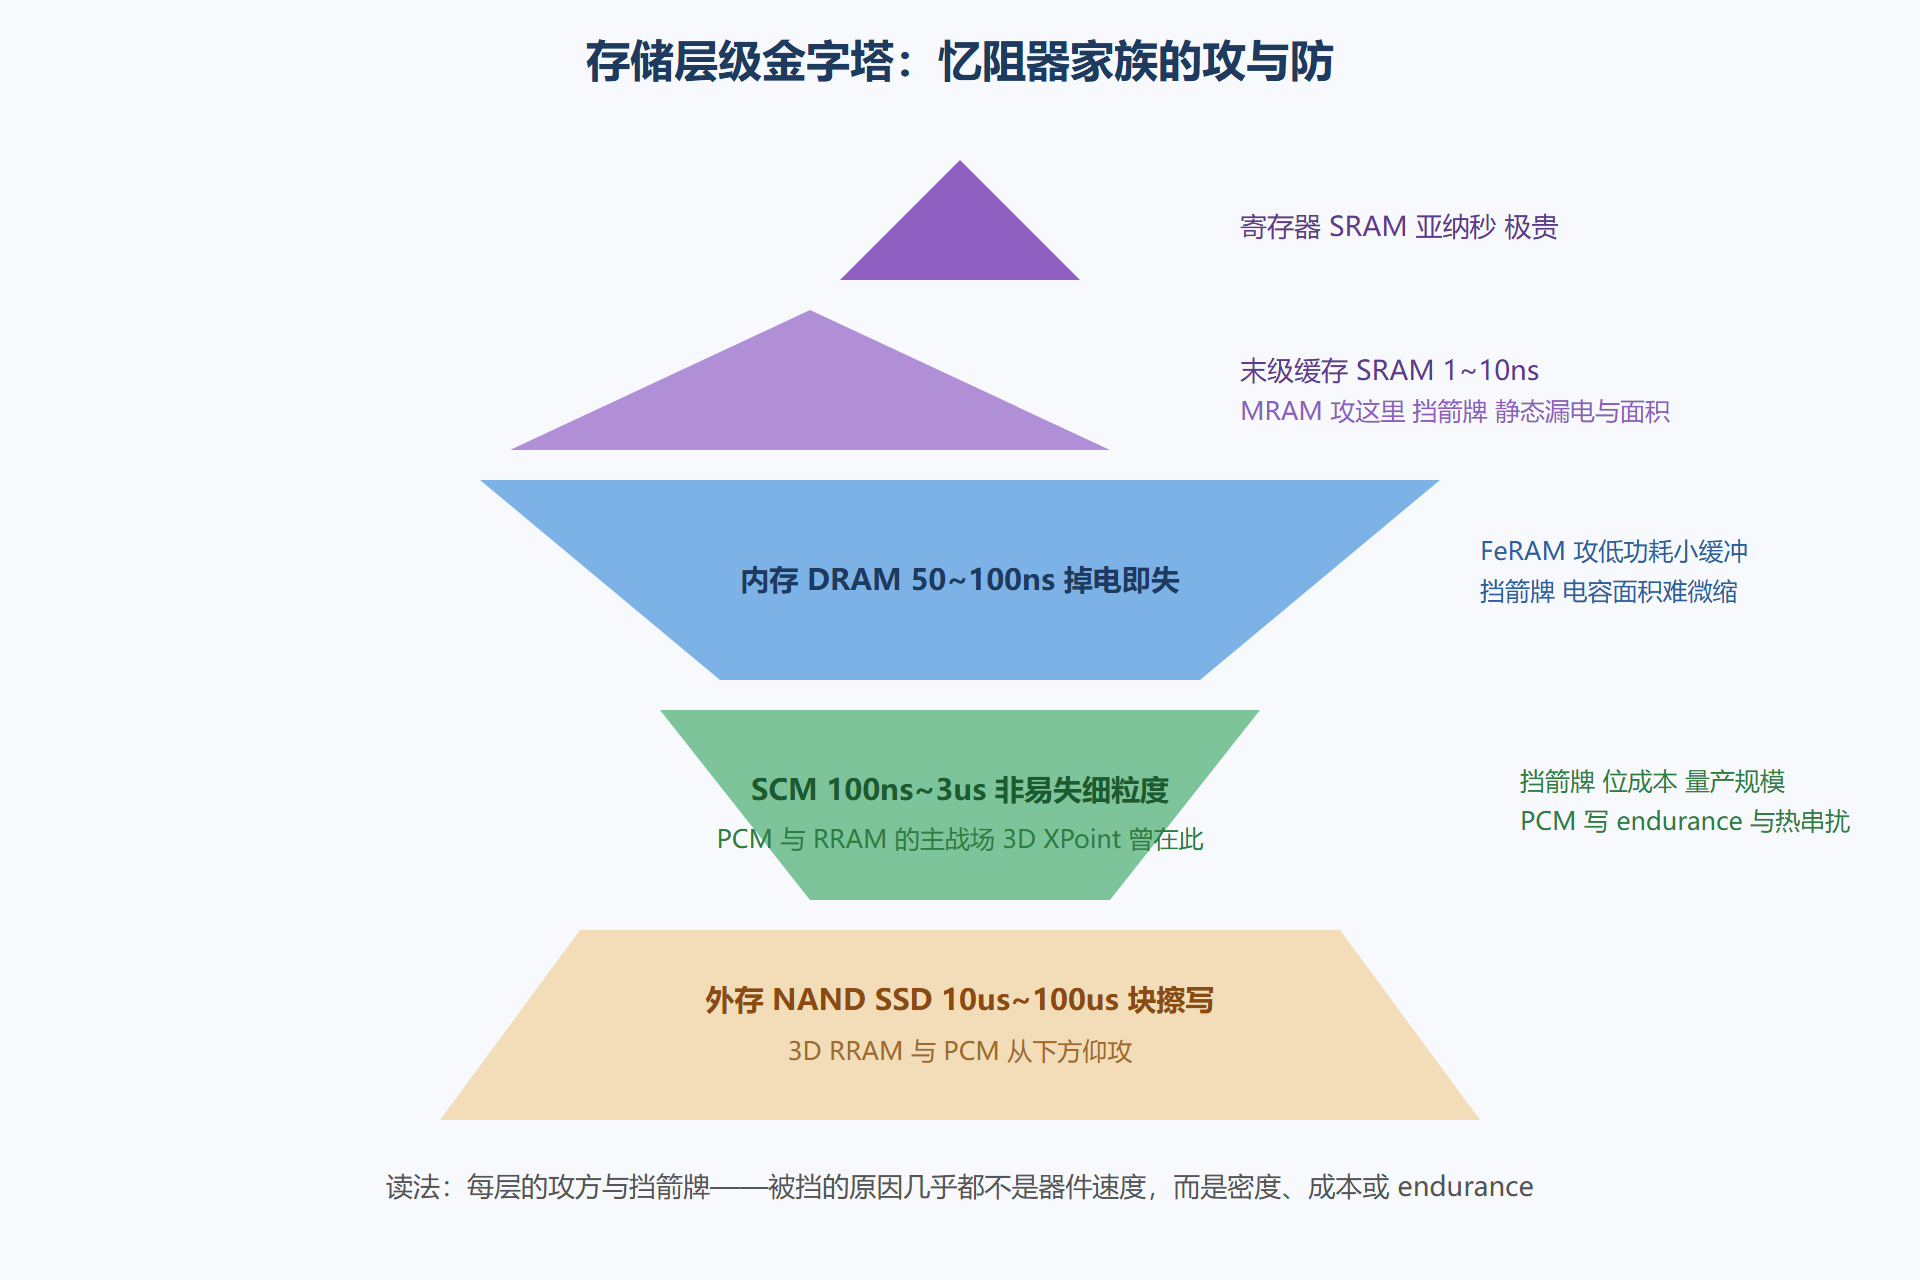
图:存储层级金字塔与四家族攻防标注
逐层的攻防盘点
MRAM 攻末级缓存:进展最大,全靠 endurance。 末级缓存(L3/LLC)的定义属性是容量×延迟×漏电的乘积。SRAM 六管单元的静态漏电在先进节点已占芯片功耗的大头(数十瓦级的服务器 CPU 里 LLC 漏电可达个位数瓦),而 MTJ 非易失、零静态功耗,且 10¹² 以上的 endurance 恰好匹配缓存的写入洪流。挡箭牌有二:系统面积并非免费(1T1MTJ 单元本身约 2040 F²,与先进节点的六管 SRAM 单元面积在同一量级,再加上每个位的感放与写驱动电路后,系统级面积互有胜负);以及 STT 写入延迟(220 ns vs SRAM 的 1 ns 以内)放到 L3 尚可、上 L2 就吃力。现实进度:多代服务器 CPU 已把 LLC 换成 eMRAM 的衍生方案,嵌入式场景(MCU 缓存、网络包缓冲)更早已商用。
PCM/RRAM 攻 SCM:唯一的量产前科。 3D XPoint(PCM+OTS 选通)是家族在 SCM 的登基证明——字节寻址、延迟约 300 ns~1 μs、密度超同期 DRAM 三倍,虽然 2022 年退市,其退市原因是市场(需求规模与成本曲线)而非技术失败。它的继任者姿态:CXL 内存扩展 + 持久内存软件栈让这条缝的需求转移到了新接口上,PCM 的技术资产(OTS 选通、多层堆叠)转投存算与嵌入式。
FeRAM 攻低功耗缓冲:窄而稳。 电表、智能卡、医疗贴片的写入缓冲不需要密度与速度的极致,要的是"每次记一笔几乎不费电、记一亿次不坏"。FeRAM 在这个生态位年供货数亿颗,活得比所有存算芯片都滋润。它上不去的原因也经典:电容式单元的 6~14 F² 面积在高密度战场毫无胜算。
RRAM 的嵌入式外存替代:侧翼包抄。 正面攻 SCM 受挫后,RRAM 在 2840 nm 嵌入式平台找到了量产生态:替代 eFlash(嵌入式闪存在 28 nm 以下工艺崩溃),做 MCU 的代码存储。这个位置要求的不是最快,而是"够快(读 20100 ns)、够稳(10 年保持)、够省(后道集成、不加掩模版)"。
卡位判据表
| 层级 | 定义属性 | MRAM | PCM | RRAM | FeRAM |
|---|---|---|---|---|---|
| 寄存器/L1 | 亚 ns 写读、最高 endurance | 否(写 ns 级太慢) | 否 | 否 | 否 |
| 末级缓存 | 10 ns 级、容量 GB 级、低漏电 | 攻入(部分产品) | 否(写慢电流大) | 否 | 否 |
| 内存/近存 | 100 ns 级、掉电安全可选 | 部分(持久化缓存) | 曾攻入(XPoint) | 边缘 | 否 |
| SCM | 100 ns~3 μs、细粒度、非易失 | 边缘 | 主战场 | 主战场 | 否(容量小) |
| 嵌入式外存 | 10 年保持、MCU 代码 | 攻入(eMRAM) | 攻入(车规 PCM) | 攻入(eRRAM) | 攻入(专用) |
| 大容量外存 | 最低位成本 | 否 | 边缘(3D 化中) | 潜力(3D crossbar) | 否 |
读表的正确姿势:没有一家族在两级以上同时称王——层级定义属性的互斥性决定了"万能存储器"不存在。这也是第 8 章选型决策表"先定层级再选器件"的直接依据。
一道系统级算术题
为什么"延迟比 DRAM 慢三倍"的 SCM 依然能赚钱?把数据库检查点算一遍:传统路径是"DRAM 数据 → 序列化 → 写 SSD",路径延迟毫秒级且烧 CPU;持久内存路径是"直接写非易失内存",单次写 300 ns。系统收益不来自器件变快,而来自路径上少了两段协议栈。这个算法适用于一切 SCM 价值评估:先画数据流路径,再算节省,别只盯着器件手册第一行。
SCM 价值速判三问 Q1 热数据集多大?(小于 DRAM 预算 -> 不需要 SCM;超过 -> 继续) Q2 掉电丢多少算事故?(几乎无 -> DRAM 够;秒级数据值钱 -> 继续) Q3 访问粒度多细?(整块顺序写 -> SSD 够;字节/缓存行级随机 -> SCM 有戏) 三问全过,SCM 才值得进 BOM 单 —— 器件再先进也救不了不需要它的架构。
⚠️ 常见坑:拿器件延迟直接对标层级延迟。DRAM 的 50 ns 是列命中延迟,SCM 的 300 ns 是器件物理延迟,两者的系统观感差距远小于数字差距——因为 DRAM 还有刷新、行激活等隐藏税。对比时用"随机读端到端"口径。
💡 关键直觉:存储层级不是速度阶梯而是"属性组合"阶梯——每一级是一组属性的交集(速度×密度×耐久×成本×易失性)。新器件的卡位成功 = 找到一组此前没有器件能满足的交集,而非在单项上碾压现任。
层级卡位的历史视角:每一代"入侵者"都走过同一条路
把时间轴拉长看,忆阻器家族并不是第一批冲击层级的入侵者:DRAM 自己当年就是替代磁芯的入侵者,NAND 替代过硬盘的归档位,3D NAND 又替代了平面 NAND 的容量位。每一轮入侵都遵循同一个剧本:先在"现任者最难兼顾的属性"上撕开口子(当年 DRAM 撕的是速度,如今忆阻器撕的是非易失),站稳后靠规模效应降成本,最后要么守住新生态位、要么进一步上攻。用这个剧本对照当下:忆阻器家族正处于"撕开口子"与"站稳"之间——SCM 的口子撕开了(XPoint 证明可做),站稳(成本曲线)还没完成。判断它们能否走完剧本,就盯一个数字:位成本的学习曲线斜率。技术叙事会变,学习曲线不会说谎。
本节要点回顾
- SCM 是第一战场:PCM 曾凭 3D XPoint 登基,退市因市场不因技术;需求正迁移到 CXL 等新接口。
- 分层攻防:MRAM 卡缓存靠 endurance 与零漏电、RRAM 侧翼攻嵌入式、FeRAM 守低功耗缓冲,各得其所。
- 万能存储器不存在:层级属性互斥,家族没有任何成员能在两级以上称王,选型必须先定层级。
- 系统收益看路径:SCM 的价值来自砍协议栈,评估先画数据流再算节省。