3.1 单元延迟:查表、外推与 Liberty 模型
3.1 单元延迟:查表、外推与 Liberty 模型
本节摘要:单元延迟不是公式算出来的,是查出来的——Liberty 库文件里的二维表以输入翻转率与输出负载为索引。本节拆开 NLDM 查表的完整过程,说明翻转率沿路径传播如何让延迟互相耦合,并对比更精确的电流源模型 CCS。
一、两个索引决定一个延迟
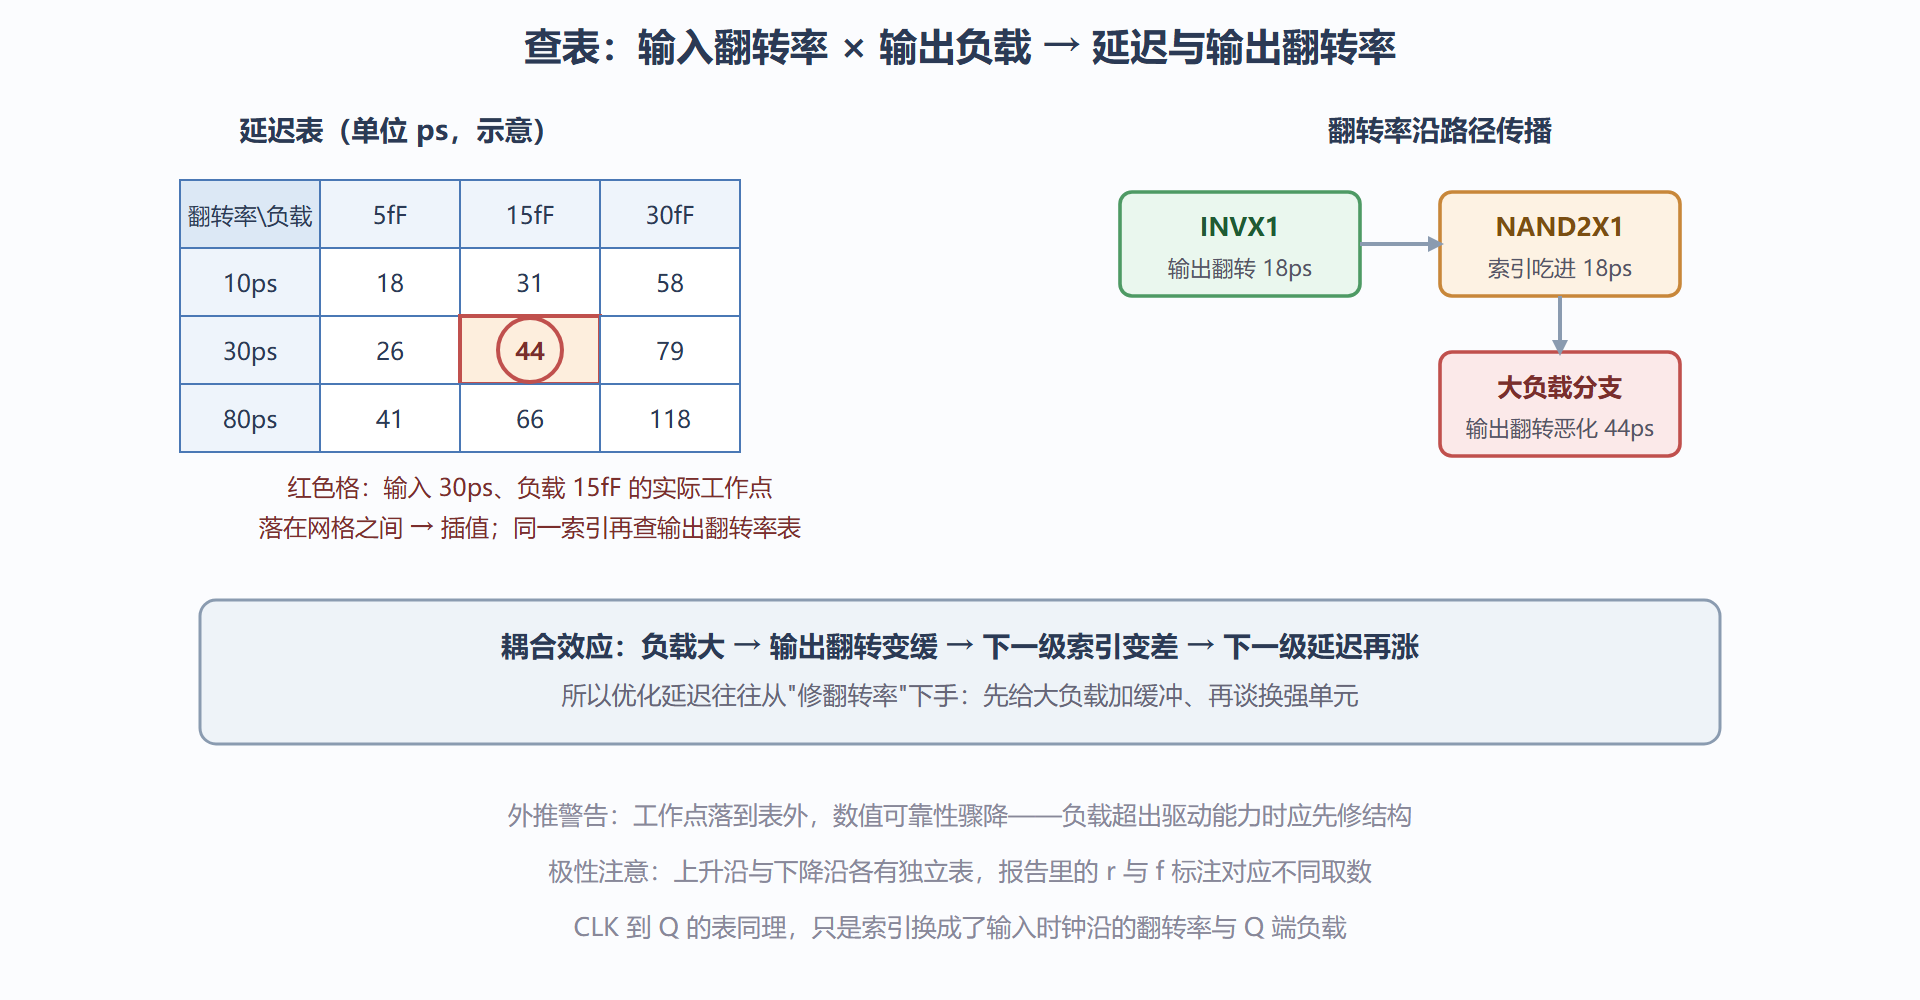
报告里那行 0.098ns 的 CLK 到 Q,来历是一次二维查表。Liberty 文件里每个时序弧挂着一张延迟表,两个索引变量:输入翻转率(input transition,信号沿的斜陡程度,常用 20% 到 80% 摆幅时间衡量)与输出负载电容(output load,接在输出上的全部电容,包括引脚电容与互连电容)。表芯是工具厂商从 SPICE 仿真中提取的延迟值网格。查表时先拿设计里的实际输入翻转率与负载定位,落在网格点之间就插值,落在网格之外就外推——外推区通常意味着设计越界了,比如负载超出了单元的合理驱动范围。
同样的表还有一张"输出翻转率表":同一个索引对,查出的是输出沿的缓急。这张表是理解延迟耦合的钥匙——本级的输出翻转率,就是下一级的输入翻转率索引。
图:NLDM 二维查表与翻转率传播链
二、耦合链条:延迟为什么互相牵连
NLDM 的两个索引把路径上的延迟串成了链条。设想一级反相器带着三个分支负载:一个到下级小门、一个到一根长线、一个到一个大寄存器。总负载把它的输出翻转拖缓;这个缓翻转作为下一级的输入索引,把下一级的延迟也抬高;下一级带着更缓的沿再驱动再下一级——翻转率像债务一样沿路径传递。这解释了两个常见的优化现象:其一,在长线中间插 buffer 常常比把驱动单元换大一档更有效,因为 buffer 先把翻转"洗"干净了;其二,负载重的分支应该用更强的单元驱动或者分成多级驱动,而不是让一级硬扛。
延迟与输出翻转是两张表,但对同一对索引。工具查完延迟表再查翻转表,把输出翻转写进下一级的输入索引。签核级的 delay calculation 还会做线端负载的细分(引脚电容与线电容的分配影响各接收端的实际翻转),这些细节属于 3.2 与 8.1 的内容。
三、Liberty 文件里长什么样
下面是一段简化后的库描述,能对上前面说的所有概念:
lu_table_template (delay_template_3x3) { variable_1 : input_transition; /* 索引一:输入翻转率 */ variable_2 : total_output_cap; /* 索引二:总输出负载 */ } cell (NAND2X1) { pin (Z) { direction : output; capacitance : 0.0022; /* 引脚自身电容,算进上级负载 */ timing () { related_pin : "A"; timing_sense : negative_unate; cell_rise (delay_template_3x3) { index_1 ("0.010, 0.030, 0.080"); /* 翻转率网格 */ index_2 ("0.005, 0.015, 0.030"); /* 负载网格,单位 pF */ values ("0.018, 0.031, 0.058", \ "0.026, 0.044, 0.079", \ "0.041, 0.066, 0.118"); } rise_transition (delay_template_3x3) { ... } /* 输出翻转率表 */ /* fall 系列表格同理;setup/hold 也是按索引查的表 */ } } }
库文件里还有几类常被引用的表值得点名:max_transition 与 max_capacitance 是单元的物理护栏,越界意味着设计违规而不是延迟变大;pin cap 是引脚自身电容,是上级负载账的一部分;电平敏感单元(锁存器)的表按透明与锁存两个状态分别表征。读库是一门手艺——签核争议发生时,能直接打开库文件核对表值的工程师,与只能盯报告的工程师,说服力不在一个量级。另外别忘了:建立与保持要求本身也是查表的结果——索引通常是数据端翻转率与时钟端翻转率,这就是同一触发器在不同工况下 Tsetup 取值不同的原因。记住这一点,报告里 library setup time 一行就不再是常数,而是查表值。
四、NLDM 之外:电流源模型
NLDM 用电压摆幅的离散表格近似真实行为,在慢沿、大负载、长互连的工况下误差会被放大。先进工艺普遍转向电流源模型:CCS(Composite Current Source)与 ECSM。它们以"驱动电流随时间与电压变化的波形"描述单元,延迟由电流对负载网络积分得出,不再依赖"输入是理想斜坡"的假设,与 SPICE 的偏差显著缩小,尤其在低电压角与串扰敏感的场合。代价是库体积与计算量都上了一个量级。
| 维度 | NLDM 查表 | CCS / ECSM 电流源 |
|---|---|---|
| 建模对象 | 延迟与翻转的二维表 | 输出电流波形 |
| 精度 | 中等,慢沿工况误差放大 | 高,接近 SPICE |
| 库体积 | 小 | 大数倍到十数倍 |
| 计算开销 | 低 | 明显更高 |
| 适用节点 | 成熟工艺、常规签核 | 先进工艺、低压角、高速接口 |
| 与互连的配合 | 需简化负载模型 | 可精确耦合 RC 网络 |
工程上的取舍很直接:成熟工艺的数字主流程,NLDM 足够且快;先进节点的签核角(尤其低压慢角与高速接口路径)逐步换用 CCS,或至少对关键路径用电路级仿真复核。本册后续示例为可读性统一按 NLDM 叙述,概念全部平移。
本节要点回顾
- 单元延迟是查表值:索引为输入翻转率与输出负载,表外即外推,负载越界先修结构。
- 翻转率沿路径传播:本级输出翻转是下一级输入索引,负载问题会沿着路径"滚雪球"。
- 建立保持要求也是查表值:随数据端与时钟端翻转率变化,不是常数。
- CCS/ECSM 用电流波形建模:先进工艺慢沿工况下精度更高,代价是库与计算量。
单元这一半账算清了,另一半——互连——在先进工艺里往往占比更大,而且布线之前根本看不见。下一节把线的电阻电容模型讲透:从布线前的估算到布线后的提取,延迟差多少、为什么差这么多。