7.1 机器学习驱动的 EDA:落点与判断
7.1 机器学习驱动的 EDA:落点与判断
本节摘要:机器学习进入 EDA 十余年,产线上真正落地的模式只有三类:用预测模型替代昂贵的试跑、用强化学习替代人工调参的搜索策略、用生成模型辅助 RTL 编写。本节逐类拆解代表工作(含 2021 年《自然》强化学习布局的机制与争议),给出"落点地图"与价值判断的三个问题。读完你能对新工具做出专业判断,而不是跟着宣传走。
为什么 EDA 会向 ML 开门
前六章的算法有一个昂贵的共同结构:搜索靠试。综合的优化策略组合、布局的迭代参数、时序修复的动作序列,都靠"跑一遍看结果再调整",一次物理实现全程要跑几百上千次工具调用。机器学习瞄准的正是这个结构:把"跑了才知道"变成"预测出来再跑"——历史设计数据里蕴藏着"什么参数组合会出什么结果"的模式,模型学走这些模式后,搜索空间被剪到原来的几十分之一。EDA 因此是 ML 的理想客户:信号规整(网表、几何、表格数据结构清晰)、试错昂贵(一次全流程几天)、数据积累丰厚(大厂数十年的设计档案)。但 EDA 也是 ML 的苛刻客户:错误零容忍(签核数字要能追责)、分布不稳定(换一个设计域数据分布就变)、可解释性刚需(工程师要接受"为什么这么摆"的理由)。
落点一:预测模型替代试跑
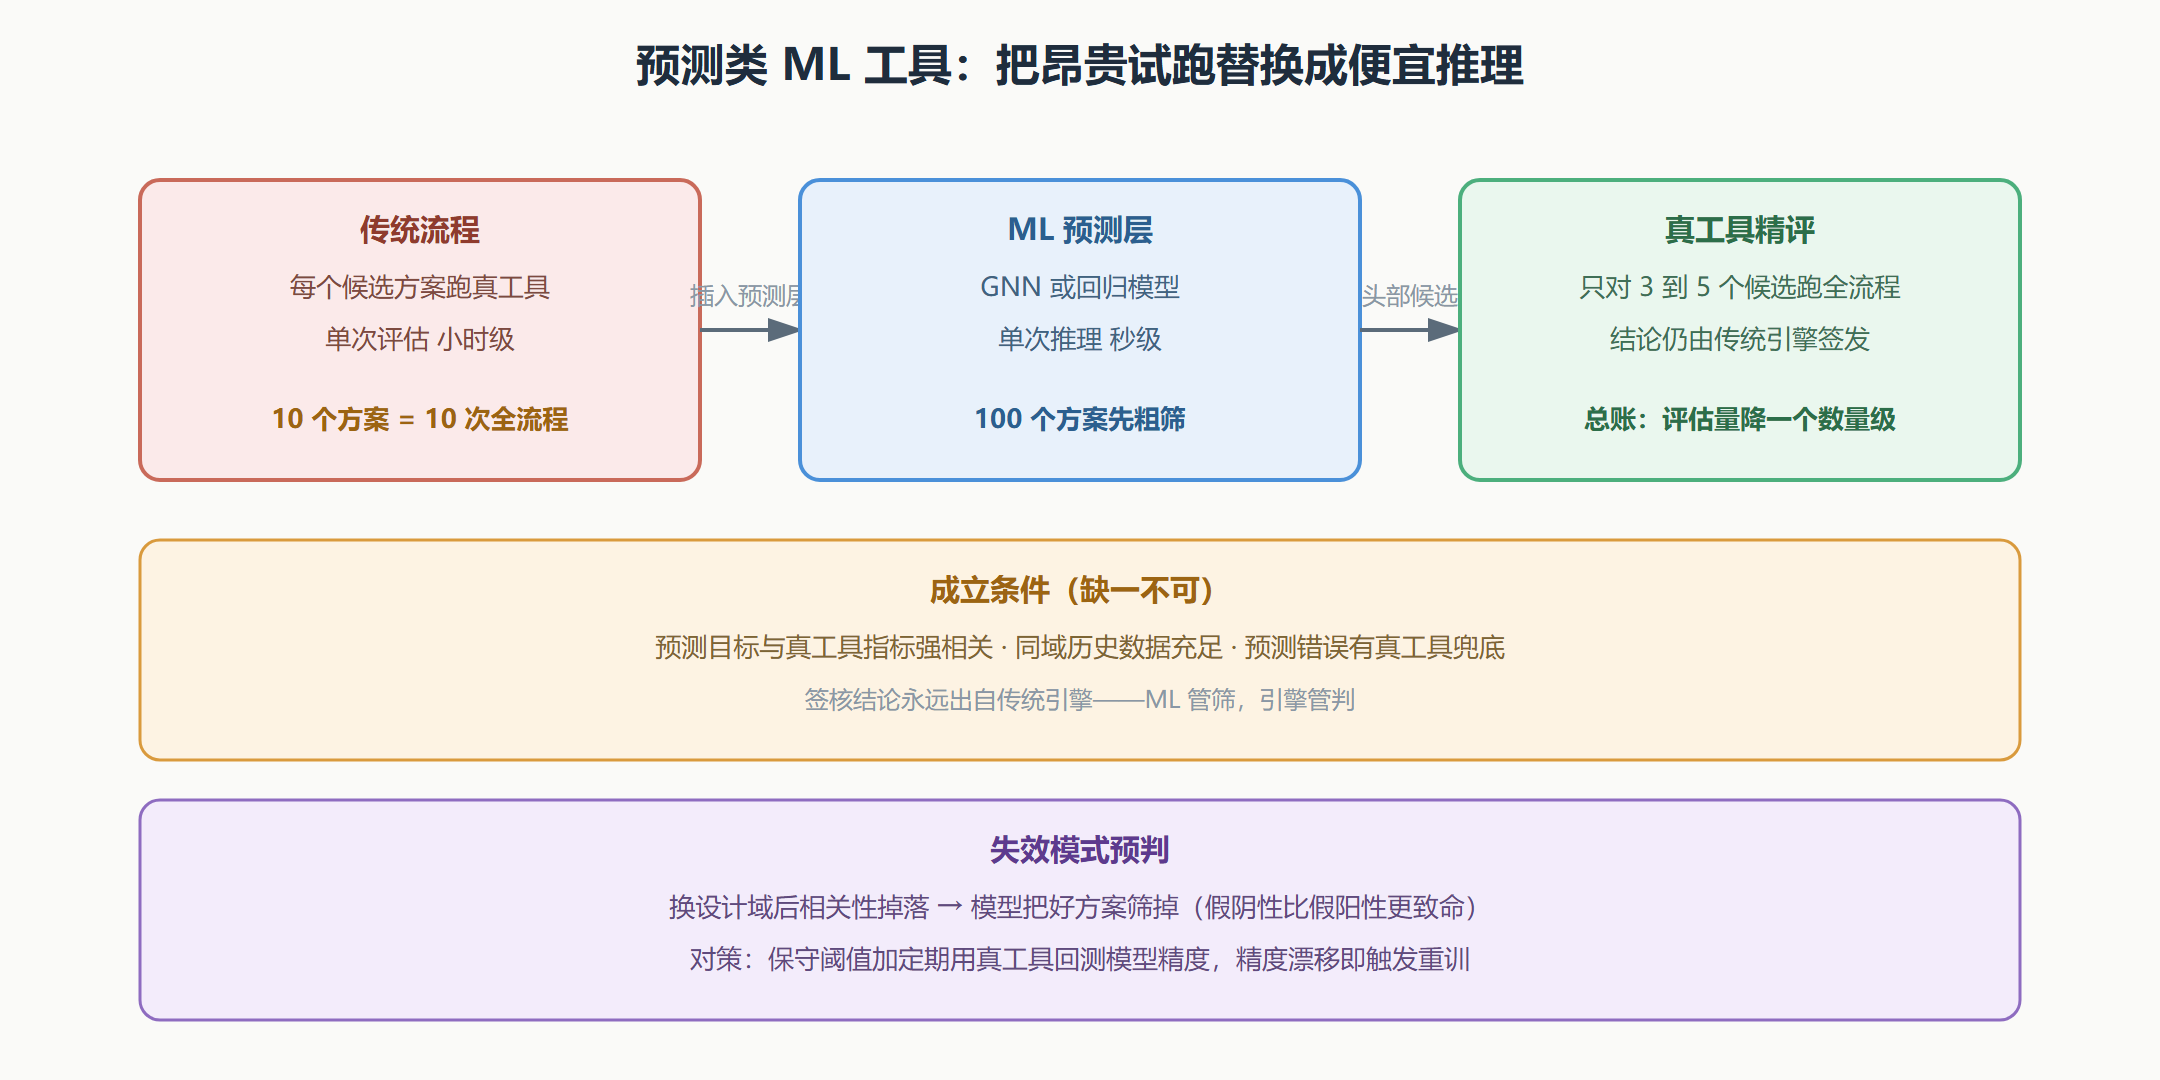
这是最成熟的一类。布线拥塞预测:布局早期就要知道"这个摆法后面布线会不会堵",传统做法是跑一次全局布线估计(小时级);图神经网络(GNN)把网表与布局图喂进去,秒级输出拥塞热图,准确率足以筛掉大半坏方案——剩下少数候选才跑真布线。综合后时序预测:综合策略(约几十个可调参数的组合)对最终时序的影响,传统靠布局布线全流程验证;回归模型从综合网表的特征(深度、扇出分布、路径结构)直接预测 WNS,参数寻优从"每次全流程"降到"每次模型推理"。SPICE 收敛参数预测:仿真器的步长与容差设置由模型推荐,避免保守设置浪费算力、激进设置不收敛。这一类的共同配方在支柱页已总结:可预测的信号、昂贵的试错、充足的同类数据。三者缺一,模型就是玩具。
落点二:强化学习改写搜索策略
2021 年谷歌团队发表于《自然》的芯片布局工作(训练一个强化学习智能体摆放宏单元,6 小时内产出与人类工程师数周工作相当甚至更优的布局)是这一类的标志性事件,也是争议中心。机制值得拆开看:状态是当前已放置的宏单元与标准单元的嵌入表示(网表图加部分布局),动作是选择下一个宏单元的落点(离散化网格),奖励是完成放置后的代理代价(线长、拥塞、密度、时序的加权)。智能体在自家历史设计上训练后,对新设计直接推理出放置策略。它真正的价值不在"比人强",而在探索速度:一个新设计的布局方案空间,人工评估几个、RL 能评估上百个,把"设计空间探索"从月级压到天级。
争议同样有教学价值。后续复现研究(2023 年 Ishigaki 等人的评测)指出:与随机放置和标准工具对比时,优势数据对预训练数据的选择敏感,"超过人类"的声明需要在公平基线下重估——论文作者团队也回应了评测口径的分歧。这场争论的结论不是"RL 没用",而是评测基准与公平基线在 ML-EDA 领域还没有共识,读任何"超越人类"的声明都要先查对比基线。商业工具的同类落地(如 Cadence Cerebrus、Synopsys DSO.ai 一类的设计空间优化产品)采取的是更稳妥的形态:RL 或贝叶斯优化在工具参数与流程策略空间上搜索,底层算法仍是前六章的经典引擎——学习层管策略,引擎层管执行,出错可回退。
判断 ML-EDA 工具价值的三个问题(实操版) 问题一 替代什么成本? 预测类: 省的是试跑工时与算力 → 收益 = 试跑次数 乘 单次成本 策略类: 省的是人工调参 → 收益 = 方案数增量 乘 每方案人工 生成类: 省的是写代码时间 → 但验证成本没省, 总账要合并算 问题二 数据与泛化? 训练数据是同产品历史? 跨工艺节点还灵? 跨设计域(手机 SoC 到 AI 芯片)还灵? 厂商话术里的 "自适应学习" 要追一句: 自适应的样本量是多少 问题三 谁兜底? 预测错了有没有传统流程回退? 签核数字还是不是传统引擎出? 红线: 学习模型可以直接探索, 但不得直接出签核结论
落点三:生成模型写 RTL 与验证的未解难题
大语言模型掀起的第三波是 RTL 代码生成:给定自然语言或伪代码描述,模型生成 Verilog。基准测试(如 VerilogEval 一类)上的通过率逐年在涨,工业试点集中在两类低风险场景:测试激励生成(写 testbench,错了容易发现)与文档注释生成(无风险)。核心矛盾在验证负担:生成的 RTL 必须经过与人工代码完全相同的验证流程,而验证恰是最贵的环节——生成提速十倍、验证不变,总周期未必缩短。第 6 章的形式化方法因此被寄予厚望:若属性证明能自动兜住生成代码的功能正确性,生成才有规模化的价值。这个闭环(生成、证明、修正)目前还在学术原型阶段。判断这类工具时记得第 6 章的语法:"跑过没问题"不等于"证明没问题",生成的代码尤其如此。
给工程师的行动清单
把判断框架落成日常动作。第一,分清工具的两种身份:探索器(错了重来,风险低,可以大胆试)与签核器(结论进交付物,要求可追责,默认不信任 ML)——工具商往往故意模糊这条线。第二,算总账不算局部账:某环节提速十倍,若上下游环节(验证、签核、数据准备)不变,项目周期改善通常不到两成;反之,验证缺口学习这类"攻最贵环节"的工具,哪怕只提速三成,总账也更可观。第三,盯住数据飞轮的归属:工具在学习你的设计数据时,谁拥有模型、换厂商时数据能不能带走——这决定了五年后你是工具的主人还是俘虏。本章剩下两节分别展开平台与对象的变化,判断框架一路通用。
图:预测类工具的流程替换结构
本节要点回顾
- EDA 是 ML 的理想与苛刻客户:信号规整、试错贵、数据厚,但零容忍、分布漂移、要可解释。
- 三类落点:预测替代试跑(最成熟)、强化学习改搜索策略(标志性争议)、生成模型写 RTL(验证负担未解)。
- RL 布局的真实价值:设计空间探索提速,"超越人类"的声明要先查公平基线。
- 商业稳妥形态:学习层管策略、经典引擎管执行、出错可回退——副驾驶而非司机。
- 验证是生成类工具的总闸:生成提速而验证不变,总周期未必缩短。
- 行动三问:分清探索与签核身份、算总账、盯数据归属——对任何新工具通用。