3.3 长程可塑性与学习规则
3.3 长程可塑性与学习规则
短时可塑性让突触有了"状态",本节要让突触能"学习":哪些共活动模式会永久改写连接强度,改写的规则是什么,规则如何避免把权重推向发散。这是全册离"智能从经验中来"最近的一节——海马记忆、皮层技能习得、以及第 8 章脉冲网络的在线学习,用的都是本节这套规则或其变种。
从 Hebb 律到 LTP:规则的实验化
1949 年 Hebb 提出的原始表述是纯定性的:"当细胞 A 的活动反复参与引发细胞 B 的放电,两者的连接效率会提高。"这句后来被概括为"一起发放的细胞连在一起"(cells that fire together wire together)的话,1973 年在海马体上找到了生理实体:短暂高频刺激(如 100 Hz 一秒)穿通径通路后,突触响应持续增强数小时乃至数周——长时程增强(LTP)。反向的共活动模式则产生长时程抑制(LTD)。
Hebb 律要变成可计算的规则,必须补三件事:共活动用什么量测(发放率还是发放时序)、更新是线性的还是需要阈值、以及权重有没有上限。这三个问题的不同答案,生成了从率基学习律到 STDP 的整个规则谱系。
率基 Hebb 律与 BCM 规则。 最直接的量化:Δw = η · pre · post,pre 与 post 是两侧发放率。它的致命缺陷是正反馈——pre、post 互相抬升,权重无界增长。BCM 规则(1982)补上滑动阈值 θ:突触前活动与"突触后平均活动"比较,低于阈值时削弱、高于阈值时增强,且 θ 随平均活动自适应上移。这既稳住了权重,又干净对上了单眼剥夺实验:剥夺眼输入减少、其驱动的平均活动下降、θ 下移、剩余输入也被削弱——视觉优势柱的发育数据被一条规则说尽。
STDP:时间也计入共活动
率基规则把"谁先谁后"丢了,而因果方向恰恰是学习最想捕捉的信息。脉冲时序依赖可塑性(STDP)给出的答案:权重更新依赖突触前后脉冲的时间差 Δt = t_post − t_pre。
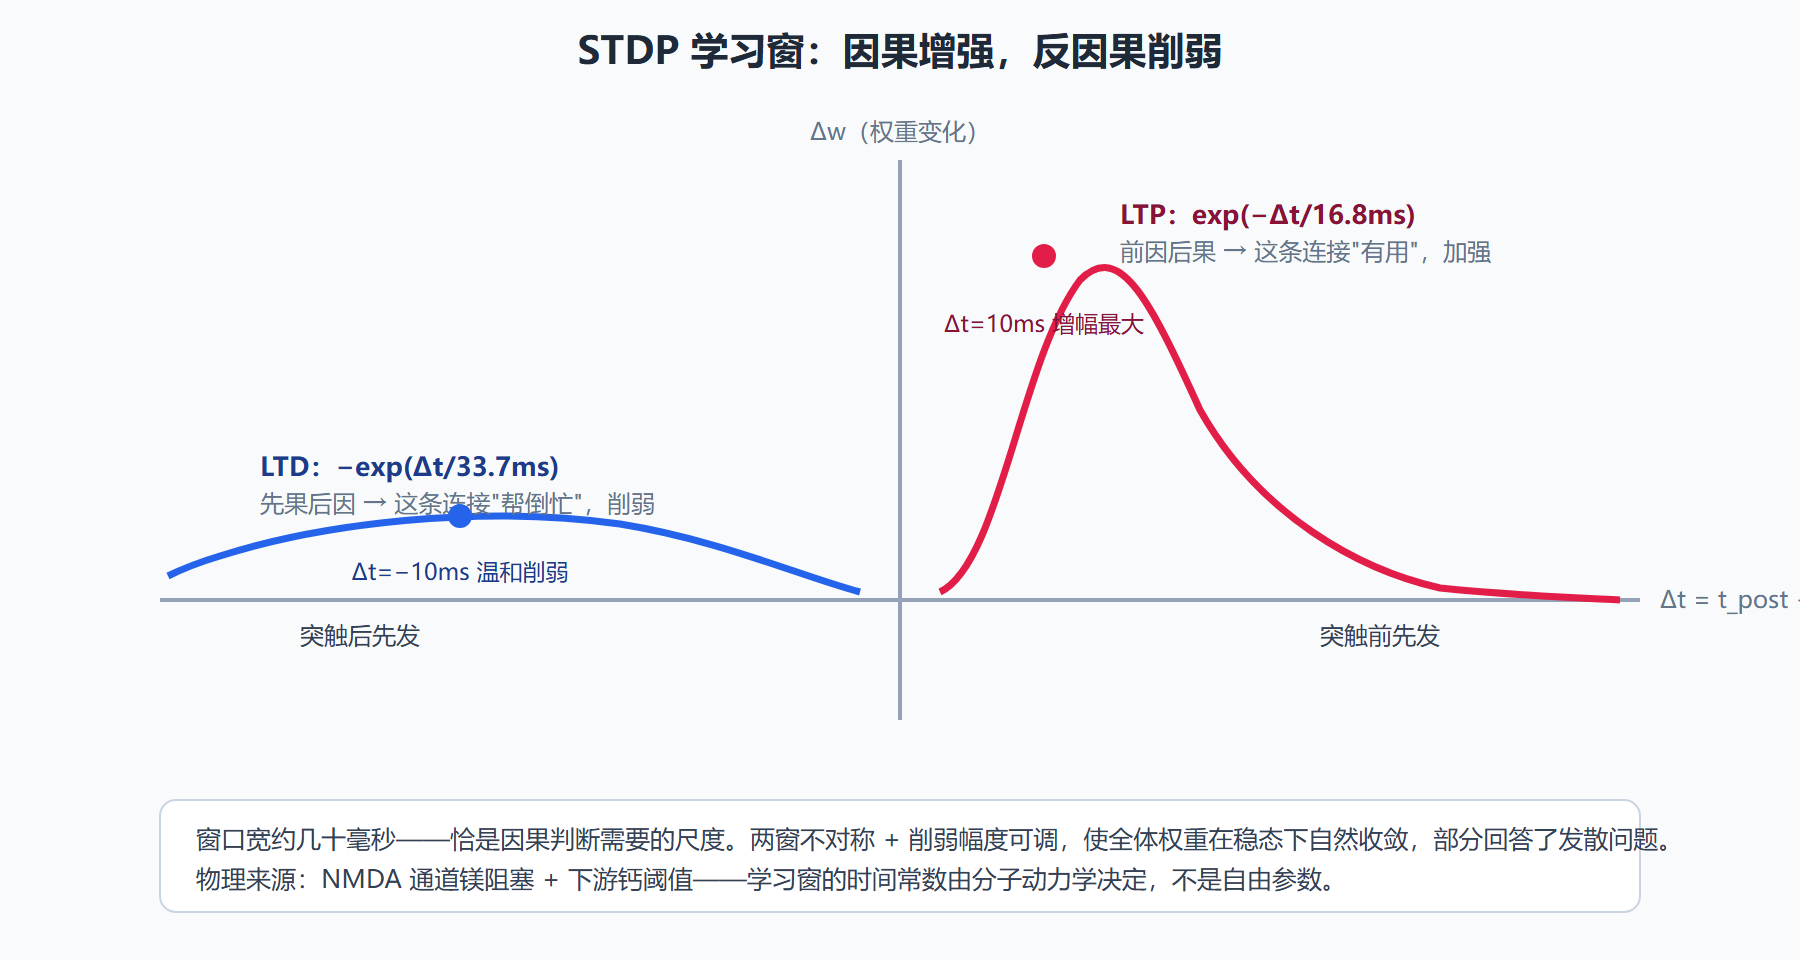
- Δt > 0(突触前先发、突触后后发——前因后果):增强,Δw ∝ exp(−Δt/τ+),典型 τ+ ≈ 16.8 ms,Δt = 10 ms 时增强最强、几十 ms 内衰减到零;
- Δt < 0(突触后先发):削弱,幅度 ∝ −exp(Δt/τ−),典型 τ− ≈ 33.7 ms。
两窗不对称、幅度不对称(通常削弱窗口更宽),合并起来就是经典的 STDP 学习窗。它的物理起点正是 3.1 节埋下的伏笔:突触前释放触发 NMDA 通道,而突触后的强烈去极化(即放电)把镁阻塞顶开——放电若发生在释放之后,钙瞬变足够大、触发增强级联;放电若在释放之前,NMDA 结合时尚未去极化,钙信号弱、走削弱通路。学习窗的时间常数直接由 NMDA 与下游钙动力学的时标决定——规则的时间尺度不是拍出来的,是分子给的。
图:STDP 学习窗——权重变化量随前后脉冲时间差的分布
概念代码:一串脉冲对过一遍学习窗
import numpy as np Aplus, Aminus = 1.0, 0.6 # 增强/削弱幅度(削弱通常更小) taup, taum = 16.8, 33.7 # 两个时间窗 ms pre = [10, 30, 50, 70] # 突触前发放时刻 post = [22, 45, 62, 95] # 突触后发放时刻 dw = 0.0 for tp in pre: for tq in post: d = tq - tp if d > 0: dw += Aplus * np.exp(-d/taup) # 前先于后:增强 else: dw -= Aminus * np.exp(d/taum) # 后先于前:削弱 print("净权重变化:", round(dw, 3)) # pre=[10,30,50,70], post=[22,45,62,95] 时为正——前导关系占优,权重净增强
把 post 序列整体前移 30 ms 再跑:净变化转负——同一对细胞,仅改变相对时序,学习方向反转。这是率基规则永远给不出的行为,也是 STDP 被视为"因果检测器"的原因。
稳定性:学习律的最后一道题
STDP 的非对称窗自带部分稳定性(纯泊松活动下权重有自然收敛趋势),但不够。网络级仿真里权重仍可能整体漂移或少数连接独大,主流补丁有三类:归一化(保持每个神经元的输入权重总和恒定,Oja 律 Δw = η·post·(pre − post·w) 是其局部化版本,同时实现主成分提取);阈值化(权重有上下界或软化饱和);三因子规则(把神经调质信号——多巴胺、乙酰胆碱——作为第三因子门控更新,"什么时候允许学"由全局状态决定)。三因子路线生物证据最硬:腹侧被盖区的多巴胺脉冲确实调制海马与皮层的可塑性窗口,它也是第 8 章"奖励调制 STDP"的源头。
💡 关键直觉:把三类规则放回同一张图——Hebb 律定方向(共活动即增强),BCM 与归一化定幅度(有阈值、有上限),STDP 定时序(因果才增强),三因子定时机(有奖励才落笔)。真实学习律是四个部件的合体。
本节要点回顾
- 要点一:Hebb 律是定性纲领,LTP/LTD 是其生理实体,BCM 补上滑动阈值。
- 要点二:STDP 用非对称时间窗编码因果:τ+ 约 16.8 ms、τ− 约 33.7 ms。
- 要点三:学习窗的时间尺度由 NMDA 通道与钙动力学决定,非自由参数。
- 要点四:归一化、阈值化、三因子规则是防发散的三类主流补丁。
- 要点五:完整学习律 = 方向 + 幅度 + 时序 + 时机四个部件的合体。
突触会学习了。下一章换个问题:站在细胞外面,我们能从一串尖峰里读回什么信息?
经典性质:LTP 的三条实验判据
LTP 之所以成为学习律的生理锚点,因为它满足三条可检验性质。协同性:单根纤维的弱刺激不产生 LTP,多根同时强刺激才行——对应 Hebb 律的"共活动"要求,机制上是单突触钙注入够不到阈值。联合性:弱输入与强输入同时作用时,弱突触也被增强——机制上是强突触的去极化经树突扩散顶开了弱突触的 NMDA 门,这为"联想"提供了突触级实现。输入特异性:只有共活动的突触被改写,旁边静默的突触不动——保证了学习的局部性。三条性质联合锁死了"学习律必须既有共活动检测又有局部性"的设计空间,STDP 与 BCM 都是这三条的数学后代。做模型时不妨自查:你的更新律能同时通过这三条判据吗?
问题:STDP 在所有脑区都成立吗?
不是,且这本身是重要信息。皮层兴奋性突触的经典非对称窗在海马与视皮层被反复证实;但海马 CA3 某些突触、以及抑制性突触上的"可塑性"表现出对称窗甚至纯增强形式;人脑组织上的实测还提示时间窗可随脑区与发育阶段伸缩。正确姿势是把 STDP 当作一个规则家族——时间窗形状、幅度不对称、阈值参数都可被神经调质与位点改造——而不是一条普适定律。8.1 节的奖励调制变体就是这个家族里的工程明星。