6.1 感知系统建模
6.1 感知系统建模
感知建模面对的核心事实是:世界只有一份,大脑却为它建了好几套不同精度的副本——视网膜上的光强图、初级视皮层的朝向与空间频率图、颞叶的物体身份。本节沿视觉通路走一遍这条"表示的升级链",看每一级的计算内容是什么,最后用预测编码把整条链重新表述一遍:层级不只是提特征,更是在预测下一级。
概念锚点:层级即加工深度
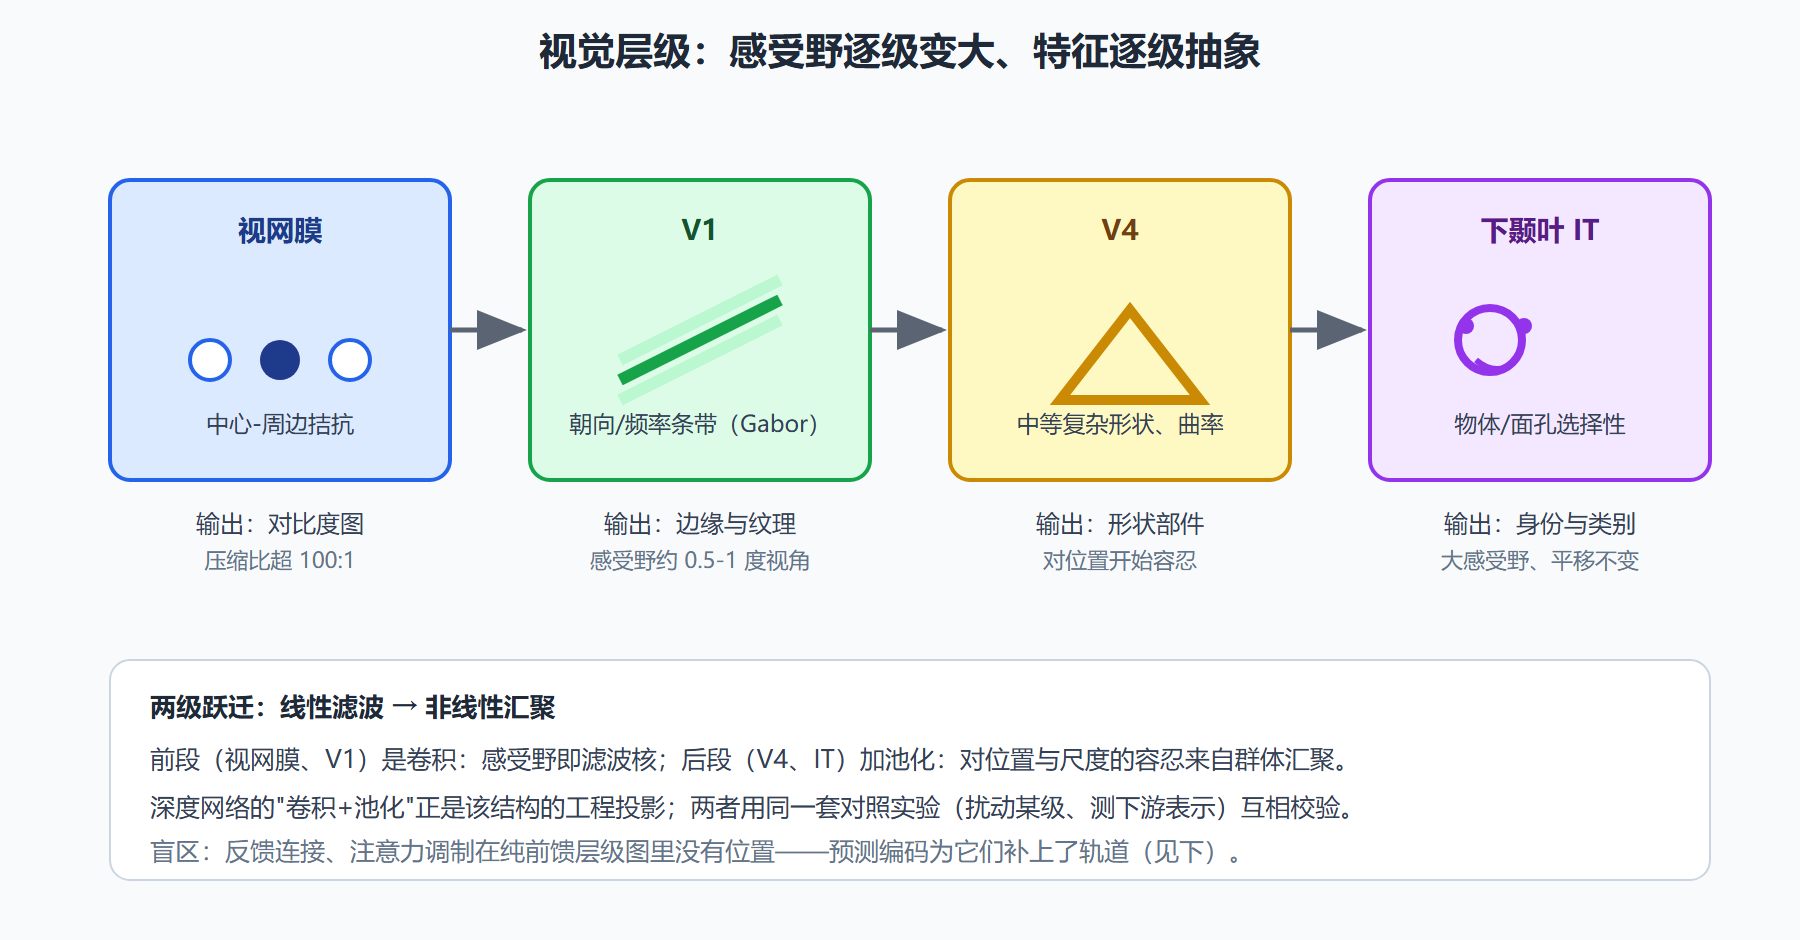
视觉通路的主干是一条清晰的层级链:视网膜(约一亿光感受器压缩到约百万节细胞输出)→ 外侧膝状体 → 初级视皮层 V1 → V2/V4 → 下颞叶 IT。每上一级,感受野变大、偏好特征变抽象:
- 视网膜做的是极限压缩与预处理:中心-周边拮抗感受野(93 万节细胞对约 1.26 亿光感受器,压缩比超百倍),强调局部对比而压制均匀照明;
- V1 的简单细胞偏好特定朝向与空间频率(Gabor 型感受野),复杂细胞对位置不敏感——第一批"边缘与条纹检测器";
- V4 偏好中等复杂度的形状特征;IT 的细胞对物体甚至面孔产生选择性(面孔区的细胞常对数百个身份各有调谐)。
这条链的计算逻辑可以概括为两级跃迁:线性滤波(视网膜、V1 简单细胞——感受野就是滤波核)+ 非线性汇聚(复杂细胞以上——对位置、尺度的容忍来自池化)。卷积神经网络的"卷积+池化"结构正是这条链的工程投影——这也是层级感知模型与深度学习共享数学词汇的原因。
图:视觉层级——感受野的升级链
预测编码:把层级倒过来读
纯前馈层级有个尴尬的事实:皮层内部连接里反馈纤维的数量与前馈相当甚至更多,层级图却没给它们安排工作。预测编码(predictive coding)框架给反馈派了差事:每一级维护一个对下一级活动的预测,把"实际输入减预测"的误差信号沿前馈通路上传,把预测沿反馈通路下发。各层做的事变成:用尽量少的误差信号解释当前输入。
这个框架的三笔收益。解释经济性:自然影像高度冗余,预测掉了的部分不必传输——误差通道天然是稀疏码,与第 4 章的高效编码原则无缝衔接。解释反馈通路:预测下发有了生理载体(皮层深层的下行纤维),层级图从"前馈流水线"升级为"双向预测回路"。解释注意与先验:注意被形式化为"上调某通道误差信号的增益"(第 5.3 节的振荡相位在此入场——高兴奋性相位即增益窗口),而先验就是历史经验沉淀下来的预测模型——6.3 节的记忆在此回声。
实证支持也已到位:V1 对期望刺激的响应被系统性压制(重复抑制), surprise(预测误差)诱发更强的响应与更大的伽马——误差通道的签名清晰可测。
概念代码:一层最小预测编码器
import numpy as np # 单层预测编码:权重 w 学习"预测输入",误差 e = 输入 - 预测 rng = np.random.default_rng(1) data = rng.laplace(size=(4000, 8)) # 自然影像的稀疏重尾统计近似 w = rng.normal(scale=0.1, size=8) lr = 0.02 for x in data: # 在线学习:最小化误差平方 e = x - w*np.dot(w, x) # 误差 = 输入 − 投影重建 w += lr*e*np.dot(w, x) # 误差驱动更新(与 Hebb 律同源) w /= np.linalg.norm(w) # 归一化防发散(第3章的补丁) print("学到的滤波器:", np.round(w, 2)) # 用边缘统计的数据跑:w 会收敛到稀疏方向——预测编码自动发现数据的低维结构
把数据分布换成高斯再跑:收敛结果退化为均匀方向——预测编码"学到什么"完全由环境统计决定。这一行为正是"感受野匹配自然统计"(4.1 节结尾)的最小演示。
何时层级模型不够
层级模型的三块盲区需要点名。一是注意与任务:同一个 V4 神经元在动物注意不同位置时响应可差数倍,纯表示链没有这个自由度。二是往返时间:感知不是单次前馈——3C 至 5C 的反馈重入在 150 ms 内完成多圈,识别是"回路收敛"而非"信号到站"。三是跨模态整合:视听冲突实验(如麦格克效应)显示高级表示会改写低级读数——信息不只在上行。三块盲区的共同解法是把层级嵌进循环动力学:反馈即预测、增益即注意、多轮即整合。这也再次呼应全册主线——功能产生于动力学组织,而非某个"感官认知模块"。
⚠️ 常见坑:把 IT 的"面孔细胞"读成"祖母细胞"(一个细胞认一个人)。实测是一群细胞稀疏分布式地表示身份(4.1 的群体码),单细胞选择性是群体表示的投影,不是编址单位。
💡 关键直觉:感知建模的全部进展可以压缩成一句话——从"大脑在提特征"走到"大脑在预测世界,只上报意外"。
本节要点回顾
- 要点一:视觉层级 = 线性滤波加非线性汇聚,感受野逐级变大变抽象。
- 要点二:视网膜的拮抗与百倍压缩是高效编码的第一现场。
- 要点三:预测编码把反馈通路用起来:误差上行、预测下行、稀疏即高效。
- 要点四:注意与先验在预测编码里有明确位置:增益上调与历史沉淀。
- 要点五:纯前馈模型的三块盲区——注意、重入、跨模态——都由循环动力学补齐。
世界被表示了。下一节看大脑如何拿着这份表示做选择:证据如何积累成决定,动作如何被选出来。
案例:盲视觉与预测编码的两条通路
预测编码框架有一个出人意料的临床应用现场。盲视(blindsight)病人:初级视皮层 V1 受损,主观报告"看不见"视野缺损区,但被迫选择时对该区物体的位置与朝向判断显著高于随机——说明视网膜到高级区的通路并未全断,只是那条通路上的信息不再到达"意识层"。预测编码给出的解读:意识相关的是层级间预测误差的整合广播,V1 损坏后误差信号无法上传,高级区只剩"猜"(先验)而没有"校"(误差),于是有行为读出而无知觉报告。这个案例把 6.1 的两个概念(层级表示、误差通道)一次性接到意识科学的门口,也示范了系统级建模的标准姿势:临床现象先于理论预言存在,模型负责解释"为什么恰好是这样分裂"。
问题:深度网络与视觉皮层到底像不像?
分层看答案不同。表示层相似:训练好的卷积网络中间层特征与 V1 至 IT 各级感受野的对应关系可量化(表示相似性分析),这是层级假说的强支持。机制层分歧:皮层有强反馈、脉冲通信、能量预算与发育可塑性,网络里这些几乎缺席或被简化;网络用梯度下降学习,皮层没有全局误差反传的解剖证据,更可能靠局部学习律与预测误差传播。务实的结论:深度网络是"行为层替代品 + 表示层对照组",把它当机制模型用就会在反馈与学习问题上翻车。