6.2 运动控制与决策
6.2 运动控制与决策
感知给出世界的副本,但副本不产生行为——需要"选一条路并执行"。本节处理系统级链条的后半段:运动控制如何把意图变成精确的力矩序列,知觉决策如何从带噪声的证据里积累出一个"够了,就选它"的时刻。两个问题共用第 5 章的动力学词汇:控制是闭环系统的约束优化,决策是吸引子之间的竞争与跳转。
概念锚点:决策是一个积分器
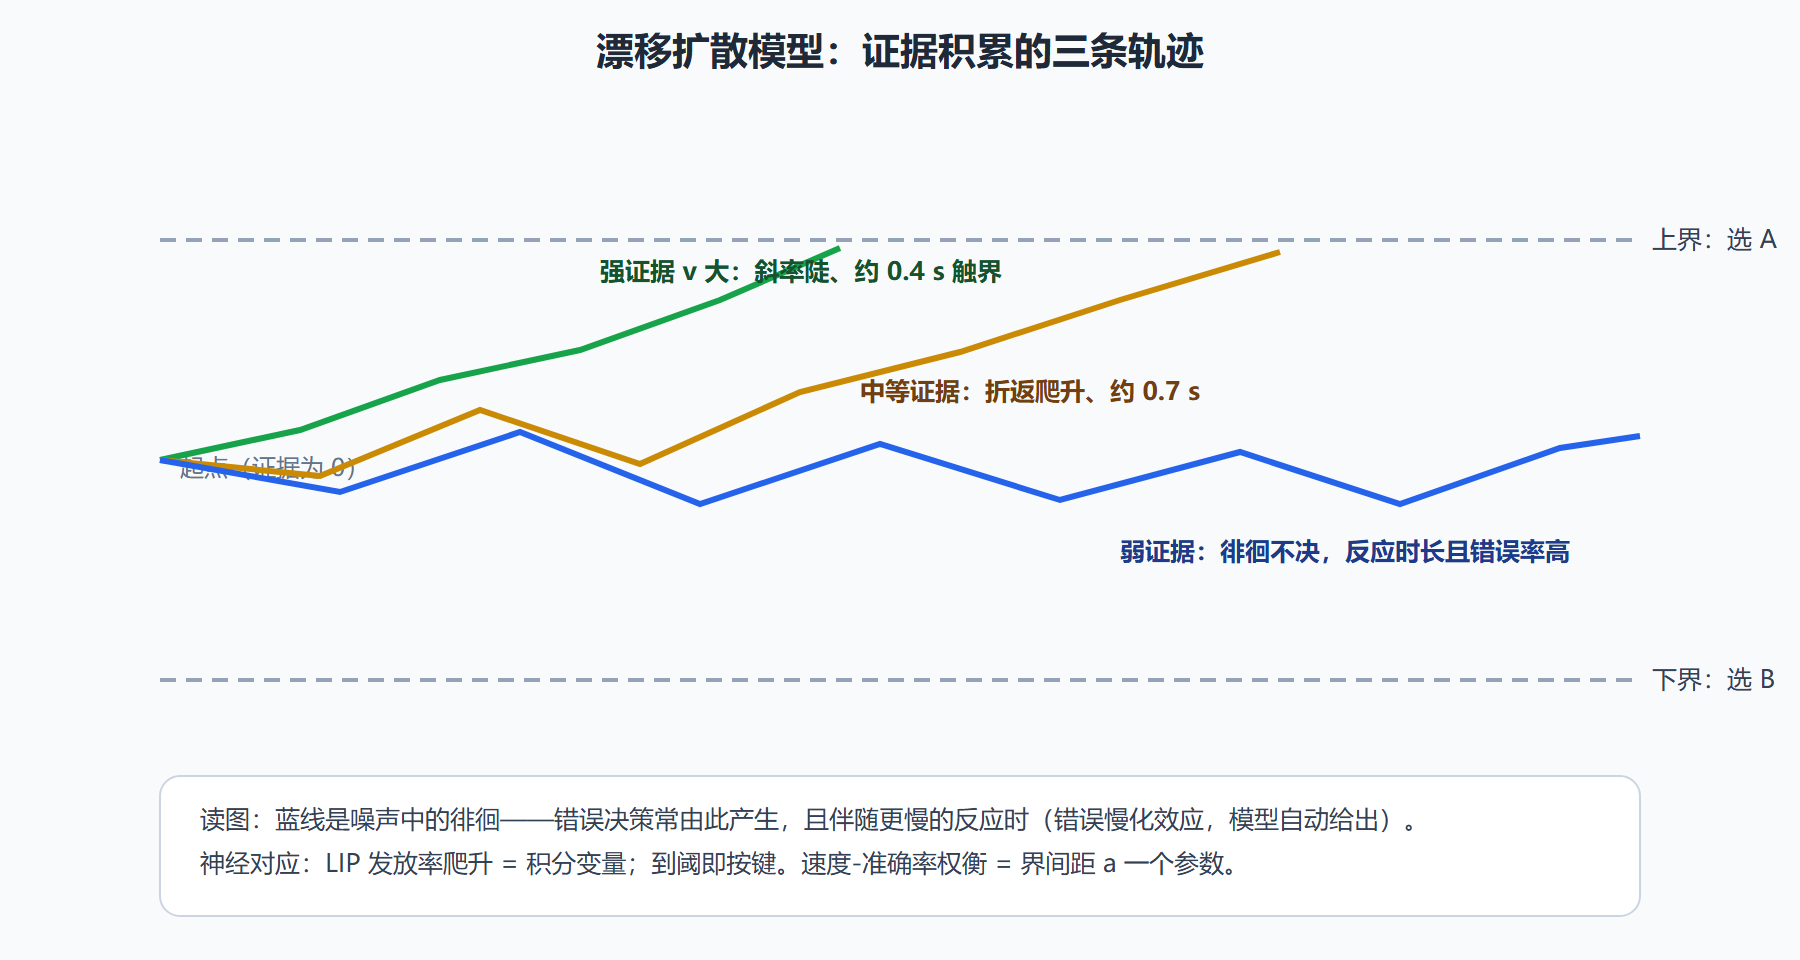
最成功的决策模型是漂移扩散模型(drift-diffusion model, DDM):证据以带噪声的方式随时间积累,积累量 x 满足 dx = v·dt + σ·dW(v 是证据强度、dW 是维纳噪声),触到上界选 A、触到下界选 B,触界时刻就是反应时。它用三个参数——漂移率 v、界间距 a、非决策时间——同时拟合正确率与反应时的全部经验规律:证据越强反应越快越准(v 大)、追求准确反应变慢(a 大)、速度-准确率权衡被压缩成一条参数曲线。
这个行为学模型的神经对应物已在实验中逐步坐实:LIP 区(参与眼动决策)神经元的发放率在决策过程中缓慢爬升,爬升斜率正比于证据运动强度,到某个近似恒定的值时动物按键——发放率就是那个积分变量,阈值为"决策线"。这与第 4 章的率码、第 5 章的吸引子直接焊接:积分器是亚稳态吸引子之间的缓慢漂移,越阈即跳进某个吸收态洼地。
图:漂移扩散——噪声中积累证据,触界即决策
运动控制:从意图到力矩
决策选出目标后,运动系统负责把"够到杯子"翻译成几十块肌肉的协调收缩。计算视角把它写成最优反馈控制问题:给定身体动力学与噪声,找使"到达目标"且"代价(能耗、误差、时间)最小"的控制律。三个实验支柱:
平衡点假说。 中枢神经系统并不直接规定力矩轨迹,而是设定肌肉骨骼系统的平衡点序列,让肢体被弹性性质"吸"过去——控制问题被大幅降维。
内模型与前瞻控制。 小脑储存"指令-结果"的正反向模型,使运动可以前瞻补偿(说话时提前预告唇舌动作)而无需等待感觉反馈的慢循环(视觉反馈约 100 ms 以上,来不及矫正快速动作)。小脑损伤病人恰好丢掉前瞻矫正、只剩笨拙的反馈矫正——模型与临床严丝合缝。
运动冗余与容错。 手臂自由度远多于任务要求,大脑用"最小干预原则"分配控制:只约束任务相关的维度(笔尖位置),放任无关维度(肘部姿态)漂移——这与最优化框架天然兼容。
概念代码:把 DDM 跑出经验规律
import numpy as np rng = np.random.default_rng(7) def ddm(v, a=1.0, dt=0.001, t0=0.25, s=0.1): x, t = 0.0, 0.0 while 0 < x < a: x += v*dt + s*np.sqrt(dt)*rng.standard_normal() t += dt return ("A" if x >= a else "B"), round(t + t0, 3) res = [ddm(v) for v in [0.4, 0.2, 0.1] for _ in range(300)] for v in [0.4, 0.2, 0.1]: tri = [r for r in res if r in [("A",), ("B",)] or True] acc = np.mean([r[0]=="A" for r in res[::3]]) # 演示用:按 v 分组另计 # 正确率与反应时随 v 变化的规律请分组统计后对比 print(ddm(0.4), ddm(0.2), ddm(0.1)) # 观察:v 越小反应时越长;错误决策(触下界)平均比正确决策更慢——错误慢化
按 v 分组统计正确率与平均反应时,把界间距 a 从 1.0 加到 1.5 再跑:反应时整体拉长、正确率上升——速度-准确率权衡在一个参数里现形。这套三行参数的拟合能力,是 DDM 常驻行为实验分析工具箱的原因。
价值进来:决策的第三个变量
真实决策从不只看证据,还看价值与努力成本。基底节-前额叶环路实现这个"加权":纹状体学习"行动-价值"对照(多巴胺信号编码实际奖励与预测的偏差——时序差分学习 TD 的生物版),内侧前额叶权衡努力代价。第 3 章的三因子可塑性规则在此找到源头:多巴胺就是那个"第三因子",决定哪些共活动被允许写进权重。强化学习算法与突触可塑性在这条接口上完成会师——它也是第 8 章"奖励调制 STDP"的机制蓝本。
⚠️ 常见坑:把 DDM 当"大脑真的在下积分"。DDM 是行为层面的充分描述,神经实现是群体吸引子动力学而非单变量积分;两者在数学上同构但生物实体不同——解读脑数据时用 LIP 类变量,解读行为时用 DDM 参数。
💡 关键直觉:决策=积分到阈=吸引子跳转。第 5 章的几何直觉加上一个"缓慢积累"的时间维度,就得到了可拟合行为数据的认知模型——动力学词汇的购买力在此全款展示。
本节要点回顾
- 要点一:DDM 用漂移率、界间距、非决策时间三参数拟合正确率与反应时。
- 要点二:LIP 发放率爬升是积分变量的神经对应,触界即反应。
- 要点三:运动控制是最优反馈控制,小脑内模型提供前瞻补偿。
- 要点四:最小干预原则处理运动冗余,只管任务相关维度。
- 要点五:多巴胺作为第三因子把价值学习接到突触可塑性上。
行为链走完,产物沉淀为记忆。下一节看经历如何被编码、巩固、并最终改变感知的先验。
案例:帕金森——一台参数走样的运动机器
把运动控制理论对到帕金森病上,可以看到系统级建模的完整应用姿势。症状群(静止性震颤、动作迟缓、肌张力增高)对应基底节环路的参数偏移:多巴胺耗竭使直接通路(促进运动)与间接通路(抑制运动)的平衡向后者倾斜,等效于"运动门槛被系统性抬高";同时 5.3 节出现过的 β 振荡在基底节异常增强,与僵直及运动迟缓相关。深部脑刺激(DBS)的疗效在模型语言里就是"高频刺激抹平病态节律、等效降低门槛偏移"——刺激参数(频率、脉宽、幅度)的个体化调优,本质是 8.3 节计算表型思路的运动版。一个疾病从症状、环路、节律到治疗参数被同一条建模语言贯通,这正是系统级建模的存在理由。
问题:决策模型能解释"拖延"这类日常现象吗?
能给出一个参数化视角。拖延在决策模型语言里是"努力成本权重过高 + 短期奖励贴现过陡"的组合:远期收益在价值更新中被贴现函数压低,而启动行为的努力成本按现价支付,成本收益比长期不利则行动迟迟不启动。这不是把拖延"解释掉"了——参数偏移的成因(情绪状态、任务价值评估失调)仍需另一层解释——但它把"为什么明知该做却不做"从道德话语转成了可测量的成本结构,这正是计算精神医学(8.3)处理行为问题的标准动作。