4.2 四类典型RAG应用系统拆解
4.2 四类典型 RAG 应用系统拆解
本节摘要:知识库问答、文档摘要、代码生成与补全、对话机器人,是 RAG 落地最广的四类系统。它们共用"加载、分块、向量化、检索、生成"的同一套管线骨架,差异集中在知识库的构成、检索策略的侧重与生成参数的配置。本节逐个拆解四类系统的架构要点与组件差异,给出一张对比表作为选型速查。读完你应当能判断自己的产品属于哪一类、该在哪一环加重投入。
学习目标
阅读完本节,你应当能够:
- 说明四类系统共用的管线骨架与各自的差异点;
- 为问答系统设计组件配置(分块、检索 K 值、链式组合方式);
- 解释摘要系统在链式策略(填充、映射规约、逐级精炼)间的选择逻辑;
- 指出代码类系统在分块与生成参数上的特殊处理;
- 为对话机器人设计多轮历史的检索融合方案。
一、一套骨架,四种产品
先把共同骨架亮出来。四类系统的底层都是这条链:加载文档 → 分块 → 嵌入向量化 → 存入向量库 → 按查询检索 Top-K → 拼进提示词 → 大模型生成。主流开发框架把这些步骤封装成可组合的"链",问答链、摘要链、对话链都是这条骨架的变体。
差异在哪?三个变量:知识库装什么(企业文档、待摘要长文、代码库、FAQ 与工单)、检索怎么侧重(准确率优先、覆盖率优先、语法边界敏感、上下文敏感)、生成怎么配置(温度、链式策略、输出格式)。四类系统就是这三个变量的四组典型取值。
四类 RAG 应用系统对比矩阵
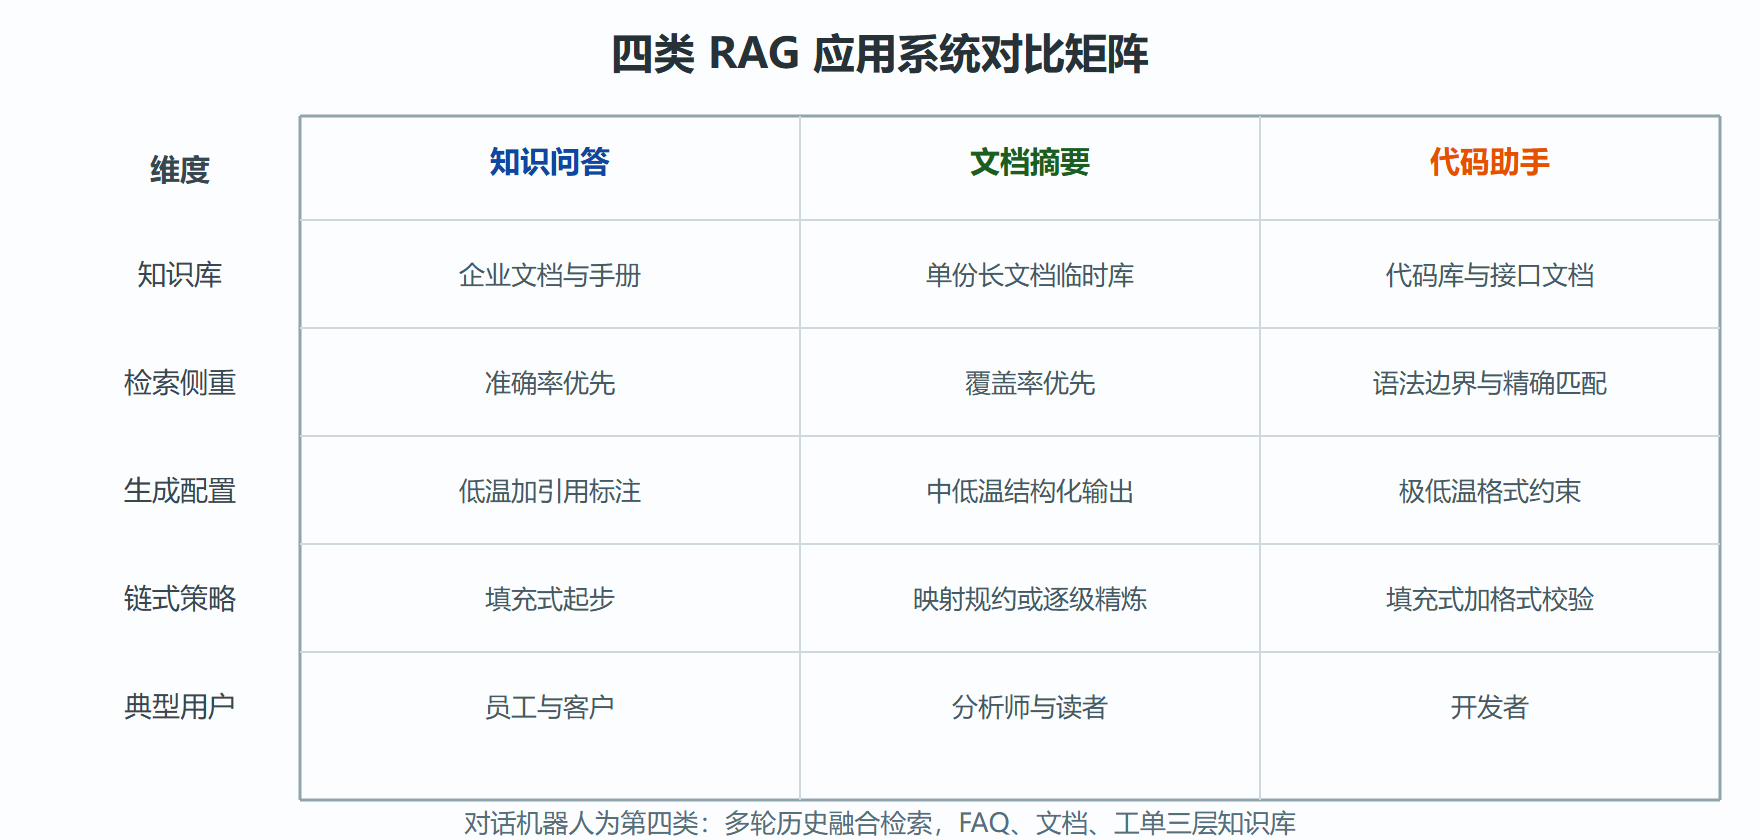
| 系统 | 知识库 | 检索侧重 | 生成配置 | 典型用户 |
|---|---|---|---|---|
| 知识问答 | 企业文档、产品手册 | 准确率、Top-K 三到五 | 低温、附引用 | 员工、客户 |
| 文档摘要 | 单份长文档 | 关键段落覆盖 | 映射规约或逐级精炼 | 分析师、读者 |
| 代码助手 | 代码库、接口文档 | 语法边界分块、精确匹配 | 极低温、格式约束 | 开发者 |
| 对话机器人 | FAQ、工单、服务条款 | 多轮历史融合 | 中低温、风格指令 | 终端客户 |
二、知识库问答系统
最常见的形态。应用面很宽:企业内部知识库(员工查政策、产品信息、技术文档)、在线客服(自动答常见问题,减轻人工压力)、教育场景(学生对学习资料提问,获得个性化解答)。
架构上有一个值得展开的细节——检索结果与生成模型的组合方式。框架通常提供几种链式策略:填充式把检索到的所有文本块直接塞进一个提示词,简单但受上下文长度限制;映射规约式先对每个块分别处理再汇总,适合块数很多的场景;逐级精炼式逐块融入、滚动完善答案,质量好但慢。问答系统块数不多,填充式通常是首选,块数爆炸时再升级。选链式策略时还有个隐性成本要算进去:三种策略的调试体验差别很大,填充式的答案偏差能直接追溯到某个文本块,映射规约式经过一层汇总,定位问题要多花一番工夫,逐级精炼式则是滚动叠加,中途任何一步的小错都会被带进最终答案。团队排错能力不足时,策略选择要往简单的一侧倾斜。
工程要点:向量库做持久化(首次构建后落盘,之后直接加载,避免重复计算嵌入);检索器暴露可调的 K 值;答案连同来源文档一起返回,支撑第 1 章讲的溯源价值。
三、文档摘要生成
对一份几十页的文档生成摘要,检索的角色发生变化——不再是"从大库里找相关块",而是"从这份文档里挑关键段落"。架构与问答几乎同构,知识库从常驻的企业知识库换成临时的单文档库,用完即弃。
应用场景包括新闻摘要(快速掌握事件要点)、研究论文摘要(目的、方法、结论速览)、合同摘要(关键条款与条件提取)。摘要系统的质量瓶颈常常不在模型在检索——关键段落漏掉一段,摘要就缺一角。覆盖率优先的检索策略(宁可多取几段)在这里是对的,与问答系统的准确率优先相反。
四、代码生成与补全
把代码库与接口文档入库,开发者提问时检索相关代码片段,模型据此生成新代码、补全现有代码或根据报错信息修复。
这个系统对第 2 章的分块原则提出最苛刻的要求:必须按语法边界切。函数、类、完整的方法体是天然的块单位,按字符数硬切会把一个函数腰斩,检索回来的残片对生成毫无价值。表格类的接口参数说明要整表保留,同理。
生成参数上,代码是所有场景里最不能发散的:温度压到极低,输出加格式约束(比如强制合法的语法结构)。检索侧重精确匹配——函数名、类名、接口名的精确命中率直接决定补全质量。生成专用代码模型在此类任务上的表现通常优于通用对话模型,模型选型时值得单独评估。
五、对话机器人
前三种系统处理的都是"一问一答",对话机器人要处理"聊着聊着问"。用户说"那退货呢",脱离上文无法检索——多轮历史的融合是这类系统的技术核心。
做法承接第 3 章的上下文感知检索:把对话历史与当前问题一起送入模型,先改写成一个独立完整的问题("订单签收后七天内退货怎么办理"),再走常规检索生成。对话链组件通常内置了这个"问题改写"环节。
知识库构成也有特点:FAQ(高频问题直接命中)、产品文档(深度问题)、历史工单(真实疑难案例)三层并存。检索时 FAQ 层可以走精确匹配优先,未命中再落到文档层的语义检索。风格控制通过系统级提示词实现(客服的礼貌分寸、语气基调),这是第 3 章控制生成技术的直接应用。
⚠️ 对话系统特有的坑:多轮改写的历史污染。用户十分钟前聊过物流,现在问支付,改写器可能把物流语境带进支付问题。改写环节要显式做"话题切换检测",切换时果断丢弃旧话题上下文。
💡 选型速查的用法:先在对比表里定位你的产品最接近哪一类,照抄该列的配置起步;产品形态混合时(客服机器人带摘要功能),按主形态配置、副功能用第 3 章的查询分流解决,别为副功能单独搭一套系统。
六、复用与定制
四类系统拆完,一个工程判断浮出水面:RAG 产品的边际成本递减得很快。第一套系统要搭全部管线,第二套只需换知识库与调配置,第三套可能只是加一个查询分流器。很多团队每做一个新需求就从零搭一遍,不是技术不会,是没把"骨架与变量"分开——骨架沉淀成平台,变量做成配置,这才是多产品场景的正确姿势。
平台化的具体路径值得给出三步:第一步,把加载、分块、入库、检索、生成封装成参数化的流水线组件,配置文件描述"库从哪来、块怎么切、检索用什么策略、生成用什么参数";第二步,把评估集与监控做成平台级设施,新产品接入即自动获得质量度量;第三步,再考虑查询分流、多库路由这类高级能力。顺序不能反——没有参数化和统一度量的地基,分流与路由只会放大混乱。
再补一个四类系统之间的"进化关系"观察,它们并非并列:问答系统是原点;摘要系统是"知识库退化为单份文档"的特例;代码助手是"分块规则领域化"的问答变体;对话机器人是"加上多轮状态"的问答升级。理解这层派生关系,你遇到新产品形态时就能快速归类——多数"新需求"都是四类系统的组合或变体,不必重新发明。
最后给一个从原型到产品的阶段提示。四类系统做原型都很快,从原型到产品之间隔着的往往是本节没展开的那些"非功能"部分:问答系统要过权限与审计,摘要系统要处理超长文档的稳定性,代码助手要接进开发者的工作流(在哪儿触发、结果怎么呈现),对话机器人要设计话题切换与转人工的边界。预算规划时,功能开发常常只占四成,剩下六成都在这些让产品"可用、可信、可运营"的环节上——提前知道这个比例,项目排期就不会一再失准。此外,四类系统对错答的容忍度也不同,验收时要区别对待:问答系统错一条政策,员工可能照错执行,容不得错;摘要漏一个要点,读者尚可回读原文;代码助手给出错误补全,开发者一试便知;对话机器人答偏了还能多轮纠回来。把容忍度排个序,测试用例的投入分配自然就有了依据——最不能错的那一类,坏案例集要建得最厚。
带走这几条
- 一套骨架:加载、分块、向量化、检索、生成六步是四类系统的公共底座,链式框架已高度封装。
- 三个变量:知识库构成、检索侧重、生成配置——四类系统就是这三组变量的典型组合。
- 问答系统:填充式组合起步,持久化向量库,答案附来源;块数爆炸再升级映射规约。
- 摘要系统:检索覆盖率优先,链式策略按文档长度与质量要求三选一。
- 代码助手:语法边界分块是命门,极低温加格式约束,精确匹配权重大。
- 对话机器人:多轮改写是核心,FAQ、文档、工单三层知识库,警惕历史污染。
- 平台化三步:先参数化管线,再统一评估与监控,最后才做分流路由,顺序不能反。
- 投入配比:功能开发约四成,权限、审计、工作流接入等非功能环节占六成,排期别只算前一半。
- 进化视角:四类系统同源派生,多数新需求是它们的组合变体,先归类再动手。
四类系统都拆完了,最后一个问题留给下一节:这套技术的边界与未来——哪些瓶颈还没解决,哪些风险必须直视。详见第 3 节。