4.1 垂直领域RAG应用:以医疗为例
4.1 垂直领域 RAG 应用:以医疗为例
本节摘要:垂直领域 RAG 针对特定行业优化,优势在知识精准性、语义理解深度、生成专业度与可定制性四项。本节盘点金融、医疗、法律、教育、技术支持五大场景的落地要点,再以医疗健康为例走完五步搭建路径——数据准备、知识库构建、检索模块、生成模块、流程整合——并讨论垂直场景特有的数据、伦理与安全挑战。读完你应当能把通用管线"翻译"成一个具体行业的方案。
学习目标
阅读完本节,你应当能够:
- 说明垂直领域 RAG 四项优势的实现路径;
- 指出五大行业场景各自的知识库构成与管线侧重;
- 复述医疗 RAG 的五步搭建路径与每步的关键决策;
- 识别垂直场景特有的数据获取、伦理与安全风险。
一、为什么"垂直"值得单独立章
通用 RAG 用公开语料,谁都能搭;垂直 RAG 用领域知识库,门槛立刻出现——但护城河也同时出现。四项优势,每一项都直接来自"领域化"这个动作:
知识精准性。 通用知识库什么都有,也就什么噪声都有。领域知识库只装医学文献、临床指南、药品说明书,检索时的信噪比天然高一截。
语义理解深度。 领域术语的微妙差别(医疗里"禁忌"与"慎用"是两个严重级别的词)只有领域化的嵌入与提示才能把握。用领域语料微调嵌入模型,是深度理解的主要手段。
生成质量提升。 基于领域知识的生成能产出符合领域规范的文本——诊断建议的措辞、法条引用的格式,通用模型写不出那个味道。
个性化定制。 管线可以按行业需求裁剪:医疗加文献溯源,金融加时效过滤,教育加学情适配。
二、五大场景落地要点
| 场景 | 知识库构成 | 管线侧重点 | 特殊约束 |
|---|---|---|---|
| 金融 | 财报、行业研报、监管政策 | 时效过滤、数字精确 | 溯源刚性、合规审查 |
| 医疗 | 医学文献、临床指南、病历 | 检索准确、术语处理 | 患者隐私、免责边界 |
| 法律 | 法律法规、判例、合同模板 | 条文精确匹配、混合检索 | 时效性(法条修订)、责任 |
| 教育 | 教材、习题、教学视频 | 个性化检索、分档生成 | 内容适龄性 |
| 技术支持 | 产品手册、FAQ、技术论坛 | 版本过滤、多轮对话 | 产品版本管理 |
以金融为例展开一笔:用户问某公司财报数据,系统检索公司财报、研报与监管文件生成分析。这里"检索结果的时效过滤"是生死线——去年的营收混进今年的问题,答案就是错的;数字的生成约束是第二条线——温度压到最低,必要时强制模型照抄原文数字。
三、医疗 RAG 五步搭建路径
医疗是所有垂直场景里要求最齐全的(数据敏感、术语密集、溯源刚性、责任重大),拿它当模板,其他场景都是它的降配版。
图:医疗 RAG 搭建五步路径
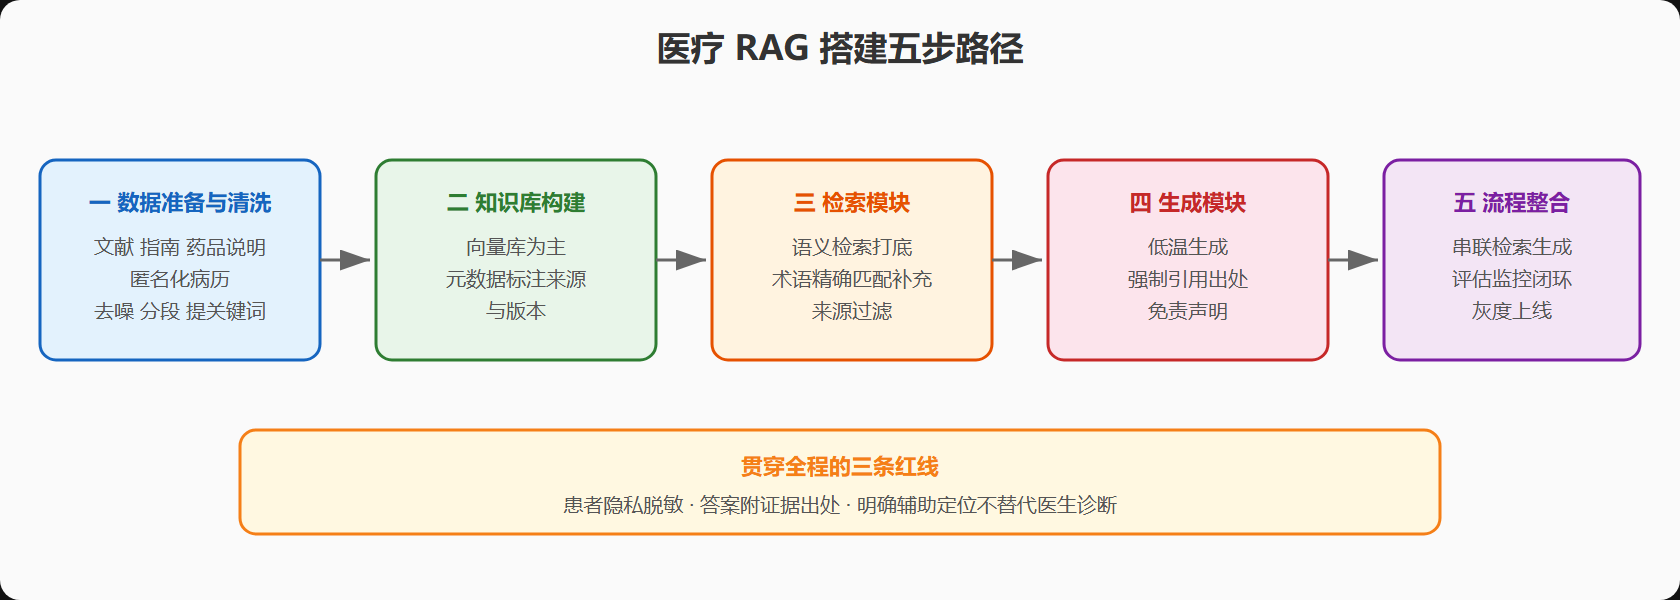
第一步:数据准备与清洗。 医疗数据源包括医学文献数据库的论文与综述、医学协会发布的临床指南、药品说明书、匿名化处理的患者病历、医学百科内容。清洗在通用动作(去噪、分段、关键词提取)之外,多两件医疗特有的事:病历的隐私脱敏(患者身份信息彻底移除)与来源权威性分级(指南与营销内容不能同权重入库)。
第二步:知识库构建。 向量数据库存文本嵌入,元数据记录来源、发布时间、权威级别。实体关系密集的子域(药物相互作用)可以考虑图数据库补充,但那是二期工程。
第三步:检索模块。 语义检索打底处理"换个说法的病情描述",关键词与术语精确检索补位处理药品名、指标名(这些不容混淆)。来源过滤常态化:默认只从指南与文献里取,患者个性化查询才动病历库。
第四步:生成模块。 三个刚性要求:温度调低压制编造;答案必须标注依据的文献与指南条目;输出附带定位声明——本系统提供参考信息,不构成诊疗建议,最终判断须由医生做出。
第五步:流程整合与上线。 串联检索与生成,接入第 3 章的评估监控闭环,灰度发布逐步放量。
医疗场景的检索与生成链路用一张图固化:
四、医疗数据源的治理细节
第三步的技术人人能学,真正的分水岭在数据治理。展开讲四个医疗特有的治理动作,它们对其他强合规领域同样适用。
权威分级。 临床指南、权威文献、药品说明书、医学百科、科普文章,五类来源的可信度完全不同。入库时打上权威等级,检索时高等级加权、低等级仅在前面全部未命中时兜底。没有分级,一篇营销软文和一份指南在向量空间里完全平等——这是医疗 RAG 最常见的隐性事故源。
证据时效。 医学认知持续更新,五年前的治疗建议可能已被修订。每份文献标注发表与修订时间,检索默认优先近年的高等级证据,除非问题明确指向历史("当时的诊疗标准是什么")。时效过滤的参数要留给运营人员调整,因为不同科室的文献更新节奏差异很大。
版本共存。 指南常有多个版本并存,直接全量入库会让新旧建议互相打架。策略是默认只检索最新版,历史版本单独归档,供明确需要历史对照的查询使用。这与第 2 章产品手册的版本管理是同一个模式。
审计留痕。 每次问答记录完整的证据链——检索到哪些块、来自哪份文献的哪个版本、模型如何引用。医疗争议的回溯要求这个粒度,它也让第 3 章的质量监控有了坚实的数据底座。
这四个治理动作有一个共同特点:全部发生在"入库与检索配置"层面,不涉及任何模型训练。它们再次印证了本节反复出现的判断——垂直领域的竞争力来自数据治理而非算法领先。同一家医院的两套 RAG 系统,用同样的模型与框架,数据治理水平的差距会直接反映在答案的专业度上,而且这种差距随时间拉大:治理好的系统知识持续保鲜,治理差的系统噪声持续累积。选型采购时别只问"用什么模型",多问"知识库怎么治",后者才是长期胜负手。
把五步路径与四个治理动作合起来看,还能读出一个时间维度的信息:五步是"建"的部分,以周计就能完成;四个治理动作是"养"的部分,要贯穿系统整个生命周期。多数失败的医疗 RAG 项目不是建得不行,是养得不行——上线时评估分数漂亮,一年后指南更新了三版、药品目录换了两轮,知识库却没人动,答案质量随时间平滑衰退,没有报警、没有突变,直到某次医疗纠纷复盘时才暴露。给知识库运营设定明确的负责人与巡检节奏,是五步搭建完成后的第一个组织动作,也是成本最低的保险——把"谁来养"写进项目章程的那一刻,这个系统才真正从一次性交付物变成了长期运转的基础设施,它的生命周期也因此与业务同频。
⚠️ 医疗场景的最大风险不是技术是责任:模型给出错误建议、医生采纳、患者受损,这条责任链上每个环节都说不清。免责声明、证据强制标注、面向医生而非患者的前端设计,三件事一件都不能省。
💡 隐私脱敏有个易漏点:病历文本里除了姓名身份证号,还有"床号加科室加日期"这类组合信息,单独看无害、拼起来能定位到人。脱敏规则要按组合可识别性设计,不能只删显式标识。
五、垂直场景的共性挑战
医疗模板套到其他领域,四类挑战反复出现:
数据获取与质量。 领域数据难获取(不公开、有版权)、质量参差。医疗文献权威性分级、法律法条版本管理的本质是同一件事——给数据建立可信度秩序。
知识表示与融合。 领域知识怎么表示(纯文本向量够不够、要不要图谱)与多源知识怎么融合(指南与病历冲突听谁的),是持续的研究问题。务实的起点是"文本向量加来源元数据加过滤规则",别一开始就追全景图。
模型微调与优化。 领域术语密集时,嵌入模型的领域微调收益明显(第 3 章已述),生成模型的微调则要谨慎——数据敏感、成本高,先穷尽提示词与检索优化。
伦理与安全。 医疗的隐私、法律的合规、金融的适当性义务,每个领域都有自己的红线,方案设计之初就要过一遍,而不是上线前补票。
本节要点回顾
- 四项优势:知识精准、语义深入、生成专业、可定制——全部来自知识库的领域化治理,而非算法翻新。
- 五场景要点:金融重时效与数字精确、医疗重溯源与隐私、法律重条文精确与版本、教育重个性化、技术支持重版本过滤与多轮对话。
- 医疗五步:数据准备(含脱敏与权威分级)、知识库构建、检索(语义加术语双路)、生成(低温加强制引用加免责)、流程整合与灰度。
- 三条红线:隐私脱敏(含组合可识别性)、证据出处、辅助定位声明。
- 共性挑战:数据获取、知识融合、模型微调、伦理安全,四项都要在立项阶段给出答案。
把医疗案例的做法迁移到别的领域时,先回答三个问题再动手:这个领域的知识更新节奏是什么(决定库的更新机制)、错误答案的代价多大(决定要不要强制引用与人工复核)、监管红线画在哪(决定数据能不能出本地)。三个答案不同,同一套管线要做的加法也不同——领域落地的本质不是换一批文档,而是把这三问的答案工程化。任何一个问题答不清楚就贸然开工,项目多半会在中途被迫补课,代价远高于开工前想清楚。
行业维度看完,下一节换到系统维度:问答、摘要、代码、对话四类产品,怎么在同一套管线上长出来。详见第 2 节。