5.1 热力图 heatmap
5.1 热力图 heatmap
heatmap 把矩阵的每个单元格映射为一块颜色,行列由位置通道占用、数值由颜色通道承载,是"两个类别维度 x 一个数值维度"的满屏比较工具。
第 4 章收官时说颜色成为唯一主角,本节兑现这句话。热力图的语法极简——一个矩阵进去、一张色块图出来——但用好它的功夫全在数据加工和色板选择上。
原料加工:从长表到矩阵
import seaborn as sns import matplotlib.pyplot as plt flights = sns.load_dataset('flights') print(flights.head(3)) # 输出: # year month passengers # 0 1949 Jan 112 # 1 1949 Feb 118 # 2 1949 Mar 132 # 透视:行=月份、列=年份、值=乘客数 pivot = flights.pivot(index='month', columns='year', values='passengers') print(pivot.shape) # 输出:(12, 11) —— 12 个月 x 11 年的矩阵,热力图的原料就绪
第 1.3 节的 pivot 在这里落地:index 定行、columns 定列、values 定颜色。heatmap 只接受这种"已聚合"的矩阵——它自己不做任何统计,长表里若有重复的行列组合,透视就会报错提醒你先聚合。
ax = sns.heatmap(data=pivot, cmap='YlGnBu', annot=True, fmt='d', linewidths=0.5, cbar_kws={'label': '乘客数'}) ax.set_xlabel('年份') ax.set_ylabel('月份') # 输出说明:颜色从左下浅到右上深,纵向(夏季行)明显更深; # annot=True 在每格标数值,fmt='d' 控制整数格式
相关系数矩阵:热力图最高频的战场
penguins = sns.load_dataset('penguins').dropna() corr = penguins.select_dtypes('number').corr() print(corr.round(2)) # 输出: # bill_length_mm bill_depth_mm flipper_length_mm body_mass_g # bill_length_mm 1.00 -0.24 0.66 0.60 # bill_depth_mm -0.24 1.00 -0.58 -0.47 # flipper_length_mm 0.66 -0.58 1.00 0.87 # body_mass_g 0.60 -0.47 0.87 1.00 ax = sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r', vmin=-1, vmax=1, center=0, square=True, linewidths=0.5) # 输出说明:翻翅长与体重 0.87 深蓝醒目;喙长与喙深 -0.24 呈浅红—— # 第 2.3 节 jointplot 里看到的"分组后正相关、全体负相关"在这里只留下全体口径的浅红
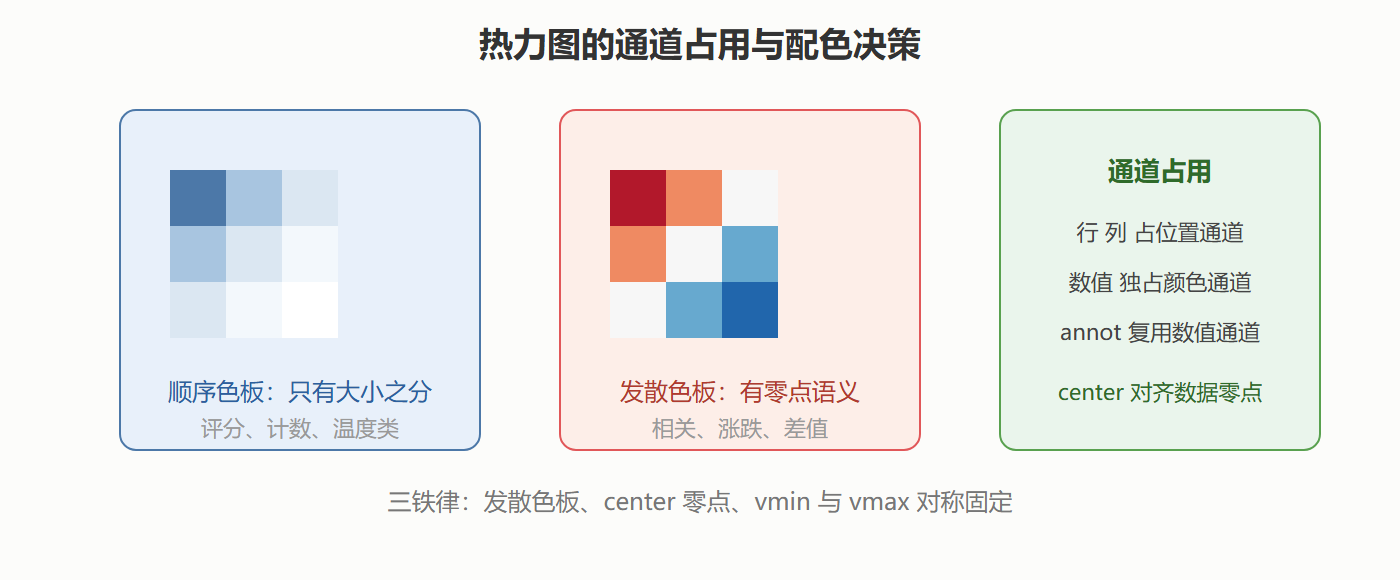
相关矩阵配色的三条铁律:必须发散色板(RdBu_r、coolwarm 一类)、必须以零为中心(center=0)、必须固定两端(vmin=-1、vmax=1)。违反任何一条,负相关与弱相关可能在视觉上无法区分。此外别忘了第 2.3 节辛普森悖论的教训:相关矩阵给出的是全体口径,混入分组变量(物种)前先做分组检查。
筛选流程也固化下来:绝对值低于 0.3 的格子直接忽略,0.3 到 0.7 之间注明样本量与分组检查,0.7 以上才进入建模或汇报的核心特征清单。
案例:评分矩阵的构成分析
背景:一份用户对四类内容的历史评分均值表(行=用户分群,列=内容类型),运营想找出各分群的内容偏好。
操作:
import pandas as pd import numpy as np rng = np.random.default_rng(11) score = pd.DataFrame( rng.normal(3.5, 0.4, (5, 4)).round(2), index=['新用户', '轻度', '中度', '重度', '沉默'], columns=['短视频', '图文', '直播', '长视频'], ) score.loc['重度', '长视频'] += 0.8 # 注入一个偏好信号 score.loc['新用户', '直播'] -= 0.6 ax = sns.heatmap(score, annot=True, fmt='.2f', cmap='viridis', vmin=2.5, vmax=4.5, linewidths=0.5) ax.set_xlabel('内容类型') ax.set_ylabel('用户分群')
结果解读:viridis 顺序色板下,重度群的长视频格子明显发亮、新用户的直播格子发暗,两处结构性偏好一眼定位。注意这里用的是顺序色板而非发散——评分没有自然的"负到正"语义,发散色板的中心(比如 3.5 分)反而暗示"低于均值是另一件事",语义不符。变式:想强调"各分群内部的相对偏好"而非绝对分值时,按行标准化再画(每行减均值除标准差),色板换发散型、中心为零,图形问题从"谁分高"变成"谁偏好偏离"。
# 按行标准化的实现 z = score.sub(score.mean(axis=1), axis=0).div(score.std(axis=1), axis=0) ax = sns.heatmap(z, annot=True, fmt='.1f', cmap='coolwarm', center=0)
⚠️ 常见坑一:annot=True 配 fmt 默认格式会输出一长串小数,务必给 fmt('d' 整数、'.2f' 两位小数)。坑二:行列类别数悬殊(3 行 50 列)时图形极扁,先用
figsize或转置调整比例,别让单元格变成面条。
💡 关键直觉:色板语义对齐数据语义——有零点的数据用发散色板居中,只有大小之分的用顺序色板,类别标签永远不用渐变。
本节要点回顾
- heatmap 不做统计:原料必须是透视或聚合后的矩阵,重复组合会在透视时报错;
- 相关矩阵三铁律:发散色板、center=0、vmin 与 vmax 固定为正负一;
- 双门槛筛相关:绝对值 0.3 以下忽略,0.7 以上才当核心证据;
- 标准化改变问题:行标准化把"绝对高低"换成"相对偏好",色板语义跟着换;
- annot 配 fmt:数值标注必须显式控制格式。
下一节给热力图装上聚类引擎,行列自动重排之后,矩阵里隐藏的块结构自己浮出来。