5.2 聚类热力图 clustermap
5.2 聚类热力图 clustermap
clustermap 在热力图的基础上对行与列分别做层次聚类,按聚类结果重排行列并绘制树状图——让矩阵里"哪些行彼此相似、哪些列总是同涨同落"的块结构自己显形。
5.1 的 heatmap 行列顺序由你给定(月份、年份天然有序)。但很多矩阵的行列没有自然顺序,比如基因表达、用户商品评分——这时按相似度重排,结构感完全不同。clustermap 干的就是这件事。
一次调用看懂结构
import seaborn as sns flights = sns.load_dataset('flights') pivot = flights.pivot(index='month', columns='year', values='passengers') # 列标准化后聚类:消除逐年增长的量纲影响,专注季节形态的相似性 g = sns.clustermap( pivot, standard_scale=1, # 1=按列(年份)标准化,让每年同一尺度 cmap='viridis', figsize=(7, 7), ) # 输出说明:行聚类把 6-9 月聚成一支、冬季月份聚成另一支; # 列(年份)聚成两支,分界大致在 1955 年前后——增长加速期前后形态不同; # 顶部与左侧的树就是聚类过程的可视化,枝长代表合并的距离
standard_scale=1 是这次调用的灵魂:乘客数逐年上涨,不做标准化时聚类只会按"总量大小"分(早年一支晚年一支);按列标准化后每列变成"当年各月相对高低",聚类才开始回答"哪些月份形态相似"。聚类结果强烈依赖标准化与距离度量,这是本节要反复敲的警钟。
树状图怎么读
树状图(dendrogram)的读法只有两条:
- 竖直高度是合并距离:两支在很低处合并说明高度相似,在顶部才合并说明只是"比和其他组更像";
- 横向顺序无意义:同一支内部左右翻转不影响聚类结论,别把相邻两列直接当作"最相似"。
# 控制聚类的距离度量与连接方法 g = sns.clustermap(pivot, standard_scale=1, metric='correlation', # 用相关系数当距离:只看形态不看幅度 method='average', # 平均连接法,抗链式效应 cmap='mako') # 输出说明:换 correlation 距离后,月份的聚类更贴合"季节形态": # 盛月与淡月各自成簇,边界比欧氏距离版更干净
参数变式与排错
z_score 与 standard_scale 常被混用:前者对指定维度减均值除标准差,结果有正有负,配合发散色板看偏离方向;后者减最小值再除最大值,压进 0 到 1,只保留相对序。想让聚类回答与谁同涨同落,z_score 配相关型度量更贴切;只想比较序结构,standard_scale 就够。行列聚类还能单独关:row_cluster=False 保留你给定的行序、只让列自适应重排——月份这类天然有序的维度就该锁住,flights 若锁月份、只聚年份列,前文那个 1955 前后的分界反而更醒目。
两个报错点提前记下:矩阵含 NaN 时 scipy 的层次聚类直接抛错,先 fillna 或 dropna,并把处理方式写进图注;method='ward' 只接受欧氏距离,配 correlation 度量不会拦你但树毫无意义——ward 的合并准则建立在欧氏几何上,度量和连接方法不是可以自由组合的独立旋钮。
案例:评分矩阵的用户分群发现
背景:延续 5.1 的评分表思路,这次行是 24 个用户、列是 6 类内容,运营想知道是否天然存在"内容口味分群"。
操作:
import numpy as np import pandas as pd rng = np.random.default_rng(21) users = [f'U{i:02d}' for i in range(24)] cats = ['短视频', '图文', '直播', '长视频', '播客', '专栏'] # 注入两个口味群:前 12 人偏爱长内容,后 12 人偏爱短内容 base = rng.normal(3.4, 0.25, (24, 6)) base[:12, [3, 4, 5]] += 0.7 # 长内容偏好群 base[12:, [0, 2]] += 0.7 # 短内容偏好群 score = pd.DataFrame(base.round(2), index=users, columns=cats) g = sns.clustermap(score, standard_scale=0, # 按行标准化:只看每个用户内部的偏好结构 cmap='coolwarm', center=0, figsize=(8, 8), dendrogram_ratio=0.15, cbar_pos=(0.02, 0.8, 0.03, 0.15))
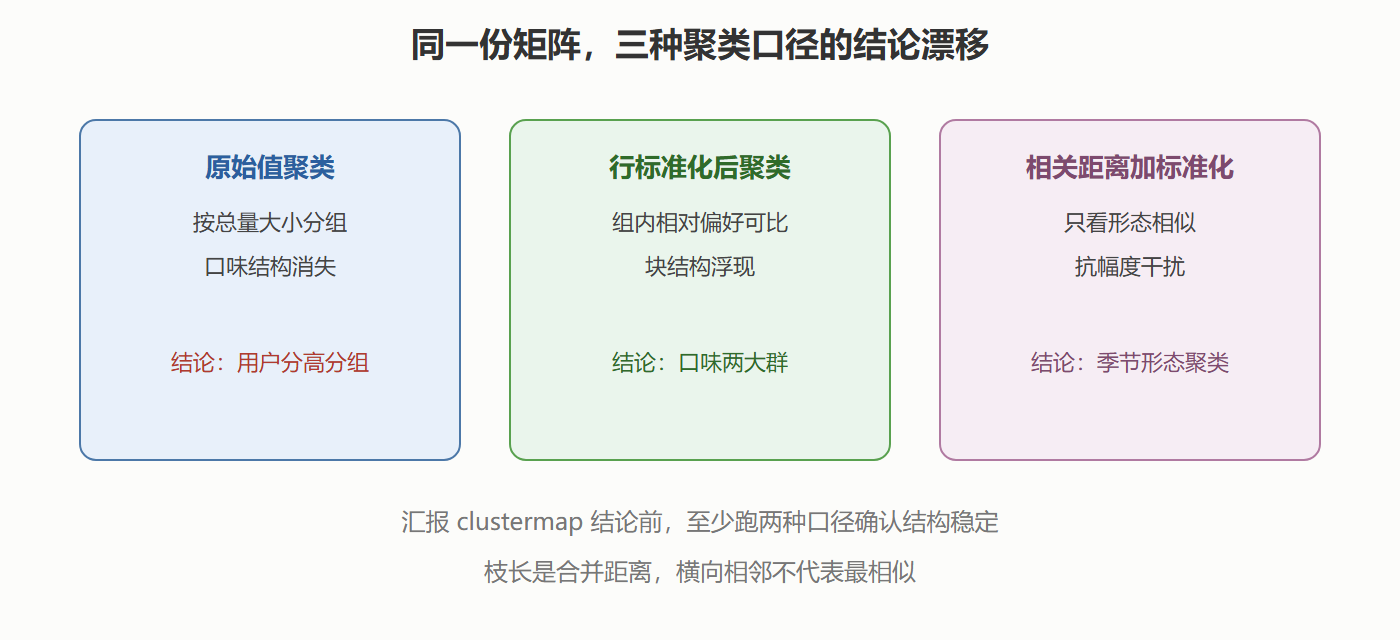
结果解读:行聚类干净地分出两大支,一支在长视频、播客、专栏三列整体偏暖,另一支在短视频、直播偏暖——注入的两个口味群被完整找回;列聚类同样把六类内容分成"长内容组"与"短内容组",与行聚类互相印证。变式与边界:把注入幅度从 0.7 降到 0.3 重跑,两大支开始互相渗透,簇边界不再干净——这说明聚类发现的"分群"强度依赖效应量,样本几百以下、差异 0.3 以内的结构,clustermap 给不出可信结论。换 metric='euclidean' 且去掉标准化重跑,聚类直接按用户整体评分高低分,口味结构消失——同一个工具、同一样本,三种答案。
⚠️ 常见坑:clustermap 返回的不是 Axes 也不是常规 FacetGrid,而是 ClusterGrid,
plt.title等接口统统失效。总标题用g.fig.suptitle,字体尺寸调整也要走g.fig。另外它默认新建一张画布,无法像 heatmap 那样用 ax 参数嵌入已有子图布局。
💡 关键直觉:clustermap 是假设生成器而非验证器——它发现的块结构要交给第 4 章的分类比较或正式的聚类评估去确认,树状图本身不提供显著性。
本节要点回顾
- 行列无序才需要聚类:月份年份天然有序的矩阵,heatmap 已足够;
- 标准化决定聚类问题:standard_scale=0 看组内偏好,=1 看形态相似,不标准化看总量大小;
- metric 换语义:correlation 距离只看形态,欧氏距离混入幅度;
- 枝长有意义、顺序无意义:读树只看合并高度;
- 双口径验证:聚类结论对口径敏感,至少两种口径同向才汇报。
矩阵家族两节拆完。第 6 章把颜色与风格系统化,前五章"细节层"欠的账一并清算。