2.8 拣选路径:索引与检索链
2.8 拣选路径:索引与检索链
本节摘要:索引与检索把 2.6、2.7 两站的零件接成完整的知识供给线:切分决定货架颗粒度,检索器决定拣货策略,检索链把拣到的料喂给模型。本节讲透切分参数的工程权衡与检索链的两种组装法。
切分:决定货架的颗粒度
整篇文档直接入库效果很差:段落太长,检索命中一段五十句的话,模型要在一大堆无关句里找答案。切分器把长文按语义边界剁成小块,每块独立入库。最常用的是递归字符切分器——先按段落切,段落太长再按句子,句子太长才硬切:
from langchain_text_splitters import RecursiveCharacterTextSplitter long_text = """ 彩色袜子保养指南。第一次洗涤建议用冷水手洗。 植物染料初次洗涤会有轻微浮色,属正常现象。 避免与浅色衣物混洗,防止串色。 晾晒时避免暴晒,阴干可保持色彩鲜艳。 长期存放建议卷起收纳,避免橡筋过度拉伸。 """ # 块大小300字符,相邻块重叠30字符 splitter = RecursiveCharacterTextSplitter( chunk_size=300, chunk_overlap=30 ) chunks = splitter.split_text(long_text) print(len(chunks)) # 输出:1(短文整体一块,切分器只在超限时才动手)
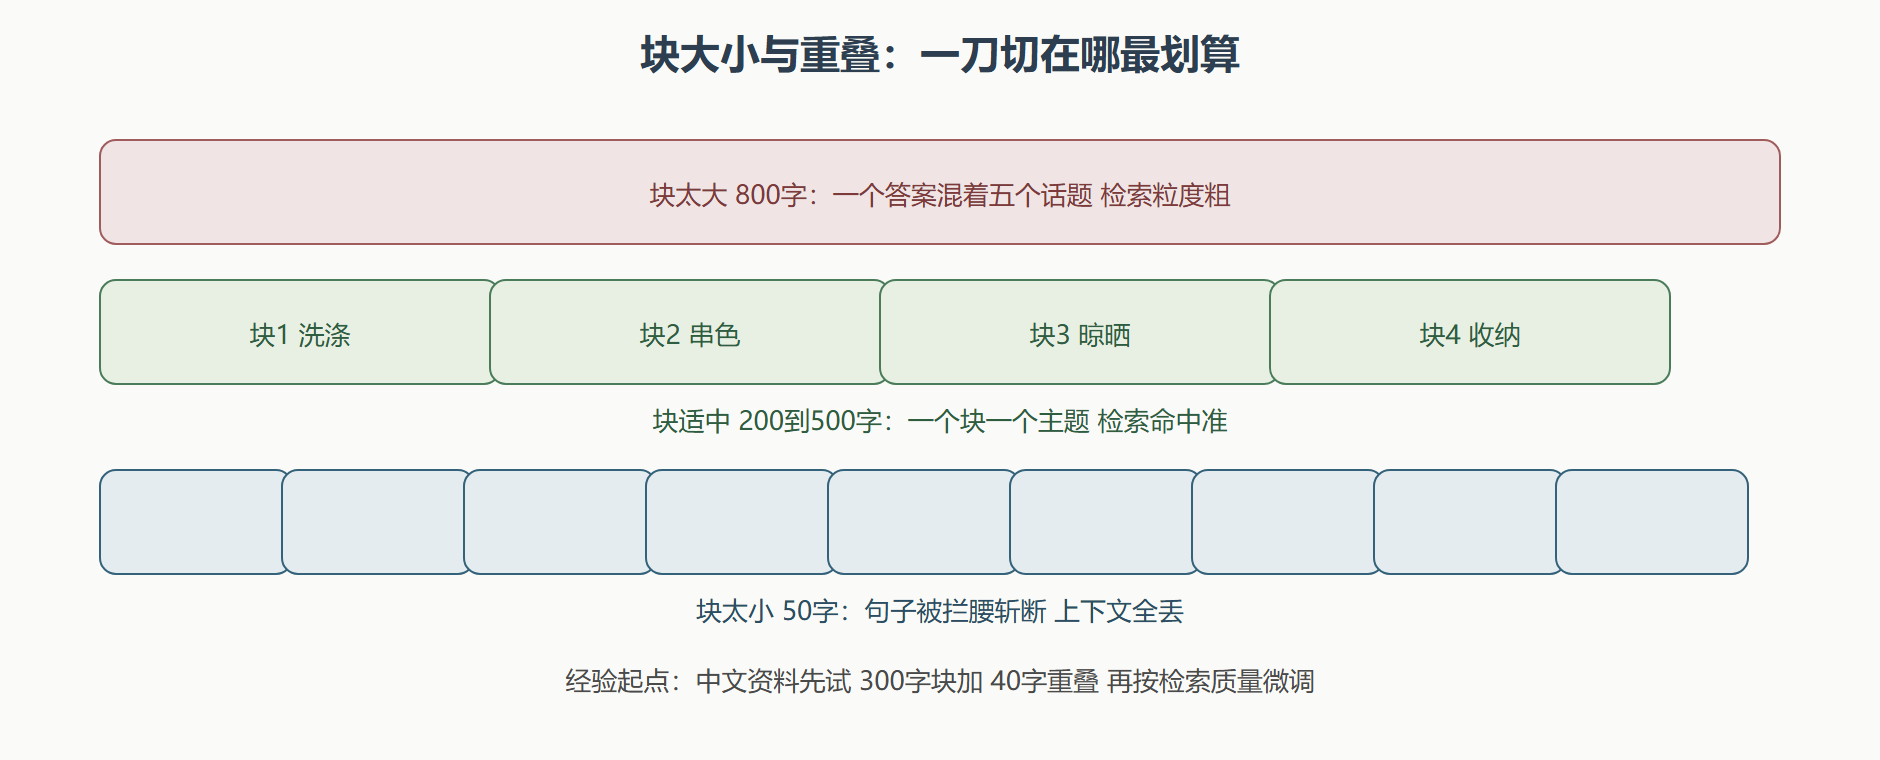
两个参数是一对矛盾:块大则上下文完整但检索粒度粗、容易掺入无关句;块小则命中精准但语义被切断。重叠区是用来缝补切断伤害的——相邻块共享一段文本,跨块的语义不至于完全丢失。
切分参数的权衡图
从文档到入库的完整动作串起来就是"索引":
from langchain_community.document_loaders import TextLoader from langchain_openai import OpenAIEmbeddings from langchain_community.vectorstores import FAISS # 供料线三连:加载 → 切分 → 入库 docs = TextLoader("socks-care-guide.txt", encoding="utf-8").load() chunks = RecursiveCharacterTextSplitter( chunk_size=300, chunk_overlap=30).split_documents(docs) vs = FAISS.from_documents(chunks, OpenAIEmbeddings()) print("入库块数:", len(chunks)) # 输出示例:入库块数:12
拣货策略:检索器的三种口味
仓库的 as_retriever 默认走"最近邻",但拣货还有更讲究的策略:
# 口味一:最大边际相关——既要近邻又要彼此不重复 retriever = vs.as_retriever( search_type="mmr", fetch_k=8, search_kwargs={"k": 3}) # 口味二:相似度门槛——只要够近的,宁缺毋滥 retriever2 = vs.as_retriever( search_type="similarity_score_threshold", search_kwargs={"score_threshold": 0.8}) # 口味三:多查询改写——把用户问题换个说法多查几遍再合并 from langchain_community.retrievers import MultiQueryRetriever from langchain_openai import ChatOpenAI mq = MultiQueryRetriever.from_llm( retriever=retriever, llm=ChatOpenAI(temperature=0))
三者的适用分歧:语料话题重叠多时用边际相关防"三块讲同一件事";答不上来比答错好时用门槛策略;用户问法口语化严重时用多查询改写。
把供给线接上主传送带
知识料最终要进提示词。旧式写法用 RetrievalQA 一键装配,内置提示模板自动把拣到的文档拼进去:
from langchain.chains import RetrievalQA from langchain_openai import ChatOpenAI qa = RetrievalQA.from_chain_type( llm=ChatOpenAI(model="gpt-3.5-turbo", temperature=0), retriever=vs.as_retriever(search_kwargs={"k": 2}), ) print(qa.invoke("袜子第一次洗要注意什么")["result"]) # 输出示例:建议冷水手洗,植物染料初次洗涤的浮色属正常现象。
新式写法用 LCEL 自己拼装,每个环节看得见摸得着:
from langchain_core.prompts import ChatPromptTemplate from langchain_core.output_parsers import StrOutputParser from langchain_core.runnables import RunnablePassthrough def format_docs(docs): # 拣到的块拼成一段供料文本 return "\n".join(d.page_content for d in docs) prompt = ChatPromptTemplate.from_template( "依据以下资料回答问题,资料里没有就直说不知道:\n" "{context}\n\n问题:{question}") rag_chain = ( {"context": retriever | format_docs, "question": RunnablePassthrough()} # 用户原话原样放行 | prompt | ChatOpenAI(temperature=0) | StrOutputParser() ) print(rag_chain.invoke("袜子第一次洗要注意什么")) # 输出示例:建议冷水手洗,植物染料初次洗涤的浮色属正常现象。
检索链的完整流向
⚠️ 检索链最常见的质量事故不是"检索不准",而是"模型嘴硬":资料里明明没有,模型仍然凭训练记忆作答。工艺单里那句"资料里没有就直说不知道"不是客套话,是护栏——没有它,检索增强会退化成"检索装饰"。
💡 调检索链先调检索再调提示:把拣到的块打印出来人工看一遍,若料本身不对,提示词写得再花也没用。上游十分钟的检查,胜过下游十轮的调参。
本节要点回顾
- 切分三件:递归切分器、块大小、重叠区,参数起点 300 加 40 按效果微调;
- 索引三连:加载、切分、入库,是知识供给线的标准动作序列;
- 检索三口味:最近邻、边际相关、门槛与改写,按语料特点选;
- 两种组装:RetrievalQA 快速原型,LCEL 管道全透明可控;
- 护栏在提示:没有"不知道就说不知道",检索增强名存实亡。
至此知识供给线全线贯通。下一节给整个车间装监控——回调如何看到每个工位的每个动作。
评论区
(0)
U