2.7 立体仓库:向量存储
2.7 立体仓库:向量存储
本节摘要:向量存储把文本连同其嵌入向量存进货架,按语义距离而非关键词做检索。本节用 Chroma 与 FAISS 演示入库、相似检索、带分检索、持久化与元数据过滤,并给出五类仓库的选型对照。
为什么检索要绕道向量
关键词检索的老毛病:问"退货政策"搜不到写着"不支持退换"的段落——字面不重合,语义相同。向量仓库的思路是把每段文本压成一个高维坐标(嵌入),语义相近的文本在空间中位置相近,检索就变成了"找最近的几个坐标",与字面用词脱钩。
立体仓库的拣货逻辑
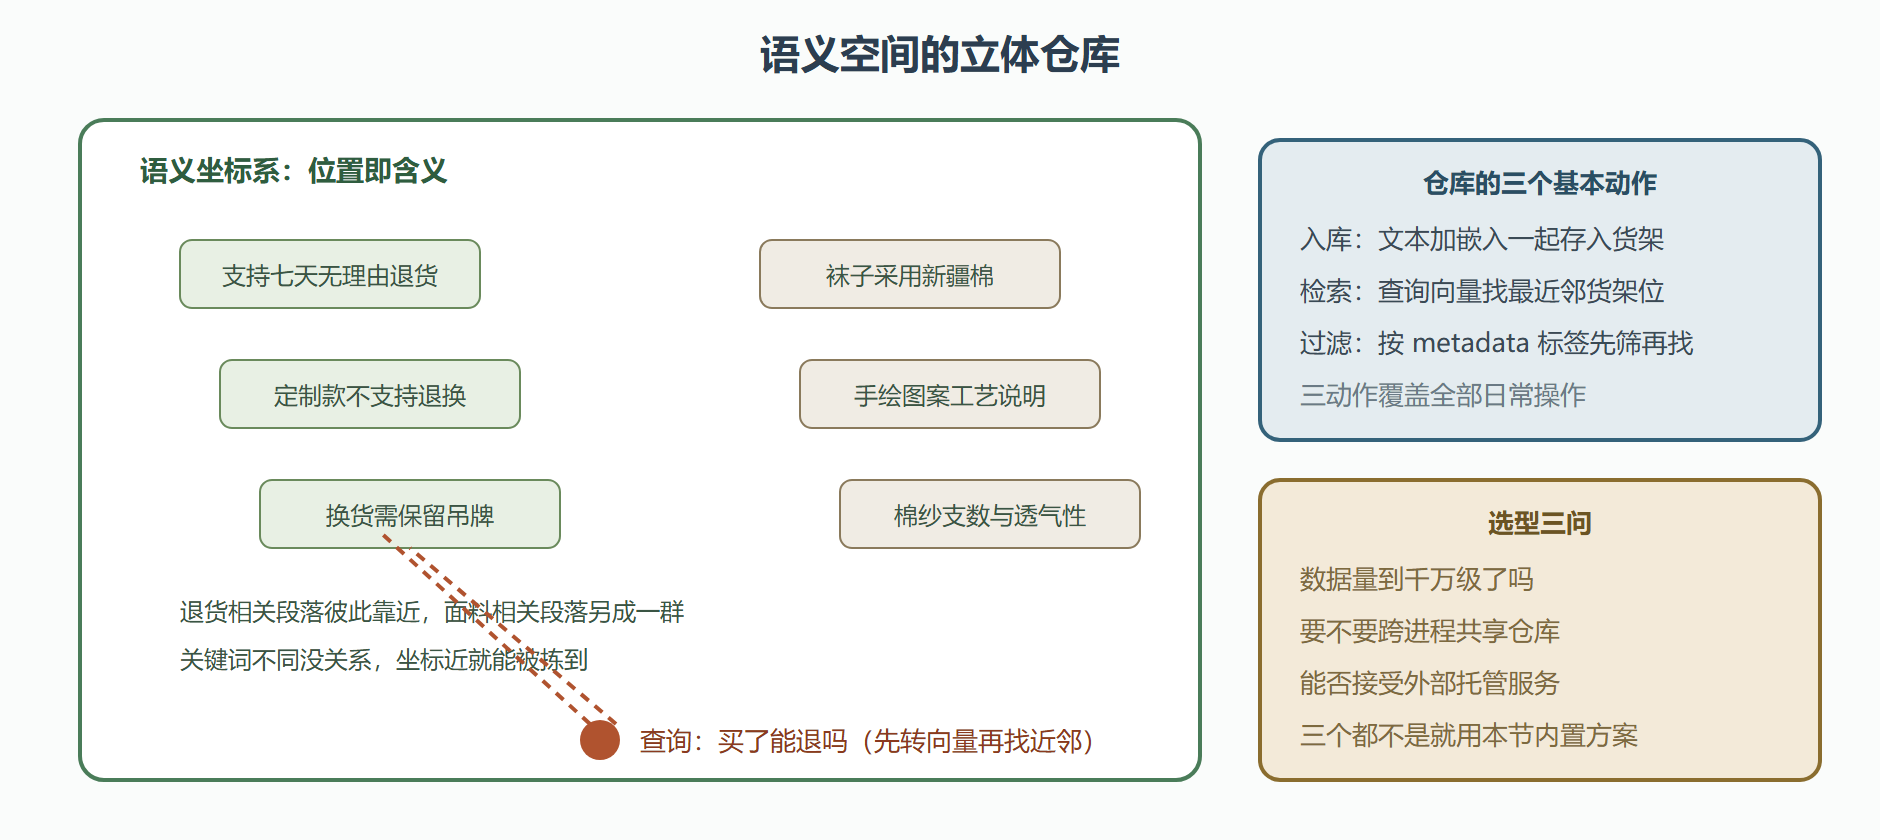
三个基本动作实操
用 Chroma 走完入库、检索、带分检索:
from langchain_openai import OpenAIEmbeddings from langchain_community.vectorstores import Chroma # 指定嵌入引擎:进仓库的度量衡必须前后一致 embeddings = OpenAIEmbeddings() texts = [ "支持七天无理由退货", "定制款不支持退换", "换货需保留吊牌", "袜子采用新疆长绒棉", "手绘图案为纯植物染料", ] # 入库:文本与嵌入一起存入内存货架 vs = Chroma.from_texts(texts, embeddings) # 检索:语义近邻,问法不同也能命中 print([d.page_content for d in vs.similarity_search("买了能退吗", k=2)]) # 输出示例:['支持七天无理由退货', '定制款不支持退换']
带分版本能看出"有多近",分数是距离,越小越近:
# 带分检索:返回 文档 距离 对,距离越小语义越近 pairs = vs.similarity_search_with_score("面料怎么样", k=2) for doc, score in pairs: print(round(score, 3), doc.page_content) # 输出示例: # 0.212 袜子采用新疆长绒棉 # 0.318 手绘图案为纯植物染料
持久化让仓库在程序重启后仍在——把目录路径传进去即可:
# 持久仓库:指定目录,重启后从同一目录加载 persist_vs = Chroma.from_texts( texts, embeddings, persist_directory="socks_kb") # 下次运行:只挂载不重建 loaded = Chroma(persist_directory="socks_kb", embedding_function=embeddings) print(len(loaded.similarity_search("退换", k=1))) # 输出:1
FAISS 是另一个高频选择,接口完全同构,换了仓库代码几乎不改:
from langchain_community.vectorstores import FAISS # FAISS:内存更快,适合单机大批量 fvs = FAISS.from_texts(texts, embeddings) print(fvs.similarity_search("退换政策", k=1)[0].page_content) # 输出示例:支持七天无理由退货
仓库直接当拣货员用
向量仓库自带一个"转检索器"的出口,转完就能接到 2.8 节的检索链上——这是仓库与传送带之间的标准接口:
# as_retriever:仓库一键转拣货员 retriever = vs.as_retriever(search_kwargs={"k": 2}) print([d.page_content for d in retriever.invoke("买了能退吗")]) # 输出示例:['支持七天无理由退货', '定制款不支持退换']
带 metadata 的入库与过滤,是"先筛货架区再找近邻"的精确打法:
from langchain_core.documents import Document docs = [ Document(page_content="支持七天无理由退货", metadata={"category": "售后", "year": 2025}), Document(page_content="2026年新品支持试穿后退", metadata={"category": "售后", "year": 2026}), Document(page_content="新疆长绒棉透气性好", metadata={"category": "面料", "year": 2025}), ] vs2 = Chroma.from_documents(docs, embeddings) # 先按标签过滤,再做语义检索 found = vs2.similarity_search( "退货", k=1, filter={"category": "售后"}) print(found[0].page_content) # 输出示例:支持七天无理由退货
五类仓库选型对照
| 仓库 | 部署形态 | 强项 | 适用 |
|---|---|---|---|
| Chroma | 嵌入式 | 零部署、可持久化 | 原型到中型项目 |
| FAISS | 内存库 | 单机检索速度 | 大批量、单机批处理 |
| Pinecone | 云托管 | 免运维、弹性 | 不想管基础设施的团队 |
| Milvus | 自建集群 | 海量高并发 | 亿级向量、重检索业务 |
| Redis | 复用缓存 | 与记忆共设施 | 已有 Redis 的系统 |
⚠️ 换仓库前先换脑子里的度量衡:不同嵌入模型算出的向量空间互不兼容,仓库里的数据用什么模型建的,查询就必须用同一个模型,混用会得到"看起来能跑、结果全是噪声"的诡异故障。
💡 建库是一次性成本、查询是永久成本:入库慢点无妨(走 batch、挑夜间时段),但 k 值与过滤条件值得反复调——它们直接决定每次问答的质量与延迟。另一个常被忽略的长期成本是重建:换嵌入模型、改切分参数都会触发全量重建,仓库越大越是伤筋动骨,所以建库前把度量衡和切分方案定稳,是给未来的自己省加班。
动手实验
把上面五个句子换成你自己的业务文档(先手工分成短句),分别用"买了能退吗"和"面料透气吗"各查一次,再故意用另一个嵌入模型建库后查询,观察结果如何崩坏。体会过"度量衡一致"这条铁律,2.8 节的检索链就能放心组装了。
顺带记录一个实验现象:把 k 从 1 逐步调到 5,观察每次命中内容的变化。多数业务库里,k 在 3 附近是性价比拐点——再大只会把不相关段落也拼进提示,既拖慢速度又稀释答案浓度。这个手感数字与你自己的数据分布强相关,值得在动手时亲手量一遍,而不是照抄别人的配置。