2.6 上料口:文档加载器
2.6 上料口:文档加载器
本节摘要:文档加载器把各色原料(文本、表格、网页、PDF)统一转成标准 Document 对象——正文加元数据两张标签。本节覆盖六种常用加载器的实操、懒加载策略与自定加载器的编写规范。
上料口的唯一职责
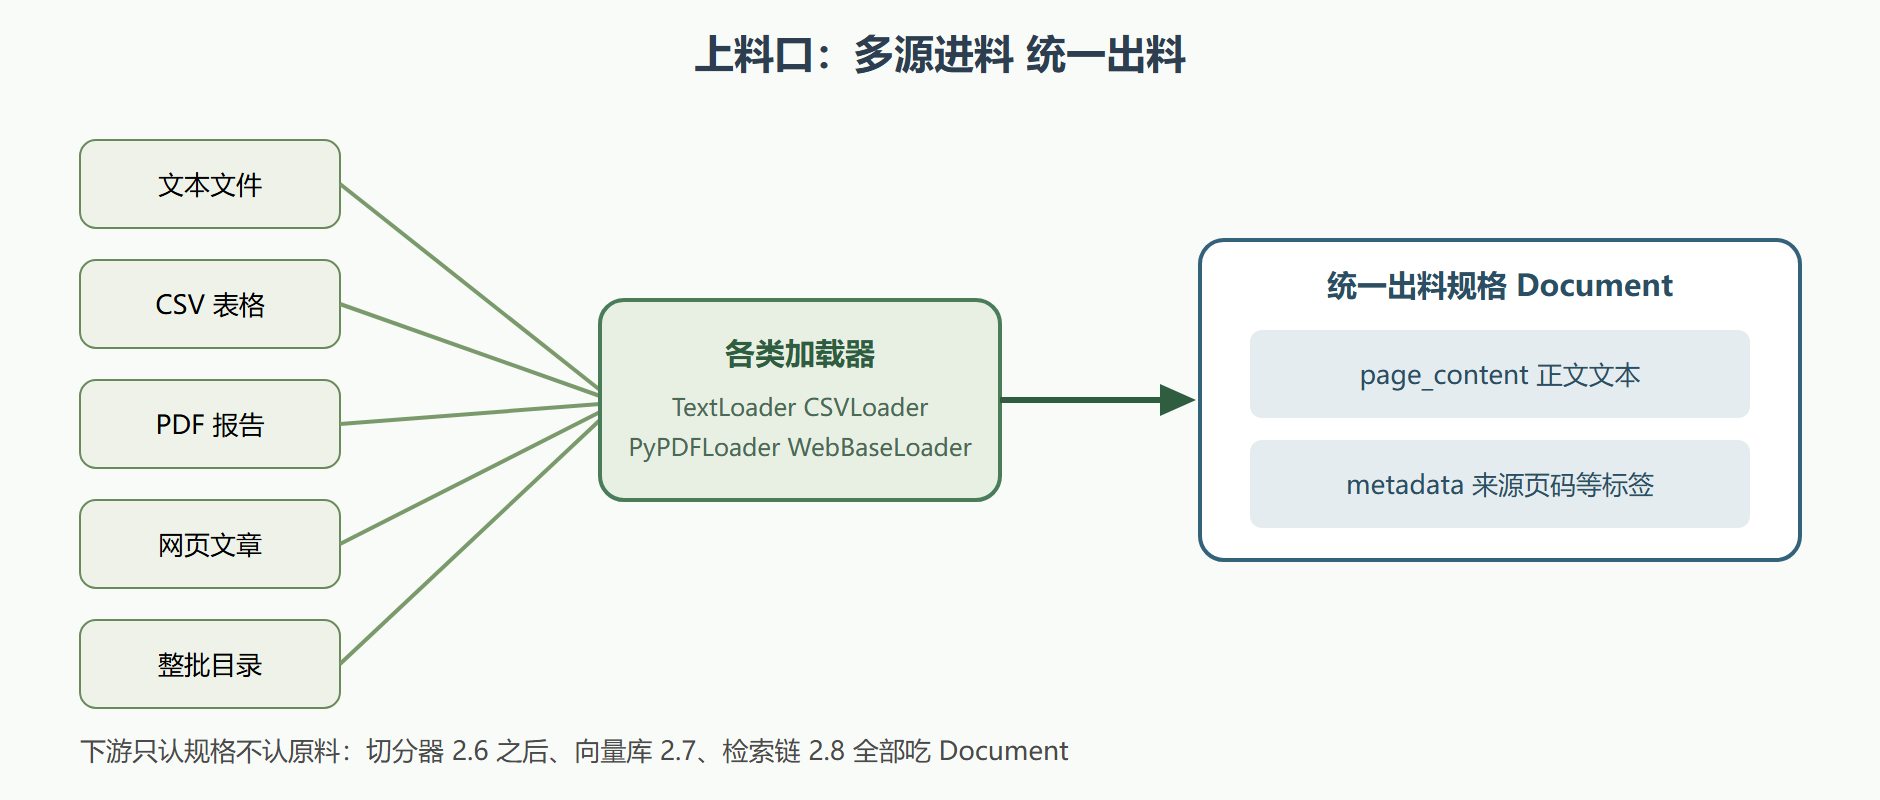
检索增强产线的第一站不是"教模型知识",而是"让知识以统一规格进线"。无论原料是 PDF 报告、网页文章还是 CSV 明细,加载器的出料规格只有一个:Document 对象,正文装在 page_content,来源信息装在 metadata。下游的切分器、向量库只认这个规格,不关心原料长什么样。
加载器家族与统一出料规格
六种常用加载器实操
先用最简单的文本加载器看清楚出料形态:
from langchain_community.document_loaders import TextLoader # 最小上料:一个文本文件 loader = TextLoader("notes.txt", encoding="utf-8") docs = loader.load() print(len(docs)) # 输出:1(单文件单文档) print(type(docs[0]).__name__) # 输出:Document print(docs[0].page_content[:30]) # 原文件前30字 print(docs[0].metadata) # 输出示例:{'source': 'notes.txt'}
CSV 这类"一行一记录"的原料,加载器会按行拆成多个 Document,metadata 记录行号——这个细节决定了检索时你能精确回答"第几条记录":
from langchain_community.document_loaders import CSVLoader # 表格进料:每一行变成一个独立 Document loader = CSVLoader(file_path="sales.csv") rows = loader.load() print(len(rows)) # 输出:数据行数 print(rows[0].page_content[:60]) # 输出示例:date: 2026-01-03 # product: 彩色袜子 print(rows[0].metadata) # 输出示例:{'source': 'sales.csv', 'row': 0}
PDF 按页出料,网页自动抽正文,目录整批进料:
from langchain_community.document_loaders import ( PyPDFLoader, WebBaseLoader, DirectoryLoader) # PDF:一页一个 Document,metadata 带页码 pdf = PyPDFLoader("annual-report.pdf").load() print(len(pdf), pdf[0].metadata) # 输出示例:42 {'source': 'annual-report.pdf', 'page': 0} # 网页:自动抽取正文标签,剥掉导航与广告 web = WebBaseLoader("https://example.com/socks-care-guide").load() print(web[0].page_content[:40]) # 目录:批量抓取指定后缀,glob 是文件名模式 bulk = DirectoryLoader("./docs", glob="**/*.md").load() print(len(bulk)) # 输出:目录下 md 文件总数
原料特别大时用懒加载:先拿到"传送指令",真正要用了才逐件上料,避免一次把内存打爆:
# 懒加载:返回迭代器而非列表,逐个处理 lazy = DirectoryLoader("./docs", glob="**/*.txt") count = 0 for doc in lazy.lazy_load(): count += len(doc.page_content) print("总字数:", count) # 输出示例:总字数: 528310
自制上料口
遇到框架没有的原料(内部接口、专有格式),自己写一个加载器,规范只有两条:继承 BaseLoader、实现 load 方法、出料必须是 Document 列表:
from langchain_core.documents import Document from langchain_community.document_loaders.base import BaseLoader class ChatLogLoader(BaseLoader): """把客服聊天日志按会话切成 Document 的自制上料口""" def __init__(self, logs: list[dict]): self.logs = logs def load(self) -> list[Document]: docs = [] for i, session in enumerate(self.logs): # 把一轮会话拼成正文,会话号写进 metadata text = "\n".join( f"{m['role']}: {m['text']}" for m in session["messages"]) docs.append(Document(page_content=text, metadata={"session": i, "source": "chatlog"})) return docs logs = [{"messages": [ {"role": "user", "text": "袜子会起球吗"}, {"role": "agent", "text": "纯棉款轻微起球属正常现象"}, ]}] for d in ChatLogLoader(logs).load(): print(d.metadata["session"], d.page_content) # 输出:0 user: 袜子会起球吗 # agent: 纯棉款轻微起球属正常现象
⚠️ 编码问题是上料口的头号故障:中文文本默认按系统编码读,Windows 下常炸出解码错误。TextLoader 与 CSVLoader 都记得显式传 encoding 参数,一劳永逸。
💡 metadata 是检索质量的隐藏杠杆:来源、页码、日期、部门这些标签现在多存一份,2.8 节的元数据过滤就能多一个筛子。上料时偷的懒,拣货时加倍还。
本节要点回顾
- 统一出料规格:一切加载器最终产出 Document 对象(正文加元数据);
- 按原料选型:文本单件、CSV 按行、PDF 按页、网页抽正文、目录整批;
- 懒加载:大原料走迭代器,内存安全;
- 自定加载器:继承 BaseLoader 实现 load,两条例程搞定私有数据源;
- metadata 前置设计:它是后续过滤检索的伏笔。
原料上了线还是整块的,发动机吃不下。下一节先建立体仓库——把文档压成向量存进货架;2.8 节再规划从货架拣料的路径。
评论区
(0)
U