1.1 一段JavaScript的引擎之旅
1.1 一段JavaScript的引擎之旅
本节摘要:JavaScript 源码在执行前要经过词法分析、语法分析、字节码生成三道编译工序,再由解释器逐条执行,热代码交给优化编译器升级成机器码。理解这条流水线,你就能解释语法错误为何「一行都不跑」、类型错误为何「跑一半才炸」,以及为什么同一行代码越跑越快。本节用可复现实验逐站拆解。
现场直击:一行加法的四次变身
以这段十行不到的代码为例:
const price = 99.5; const count = 3; const total = price + count; console.log(total); // 102.5
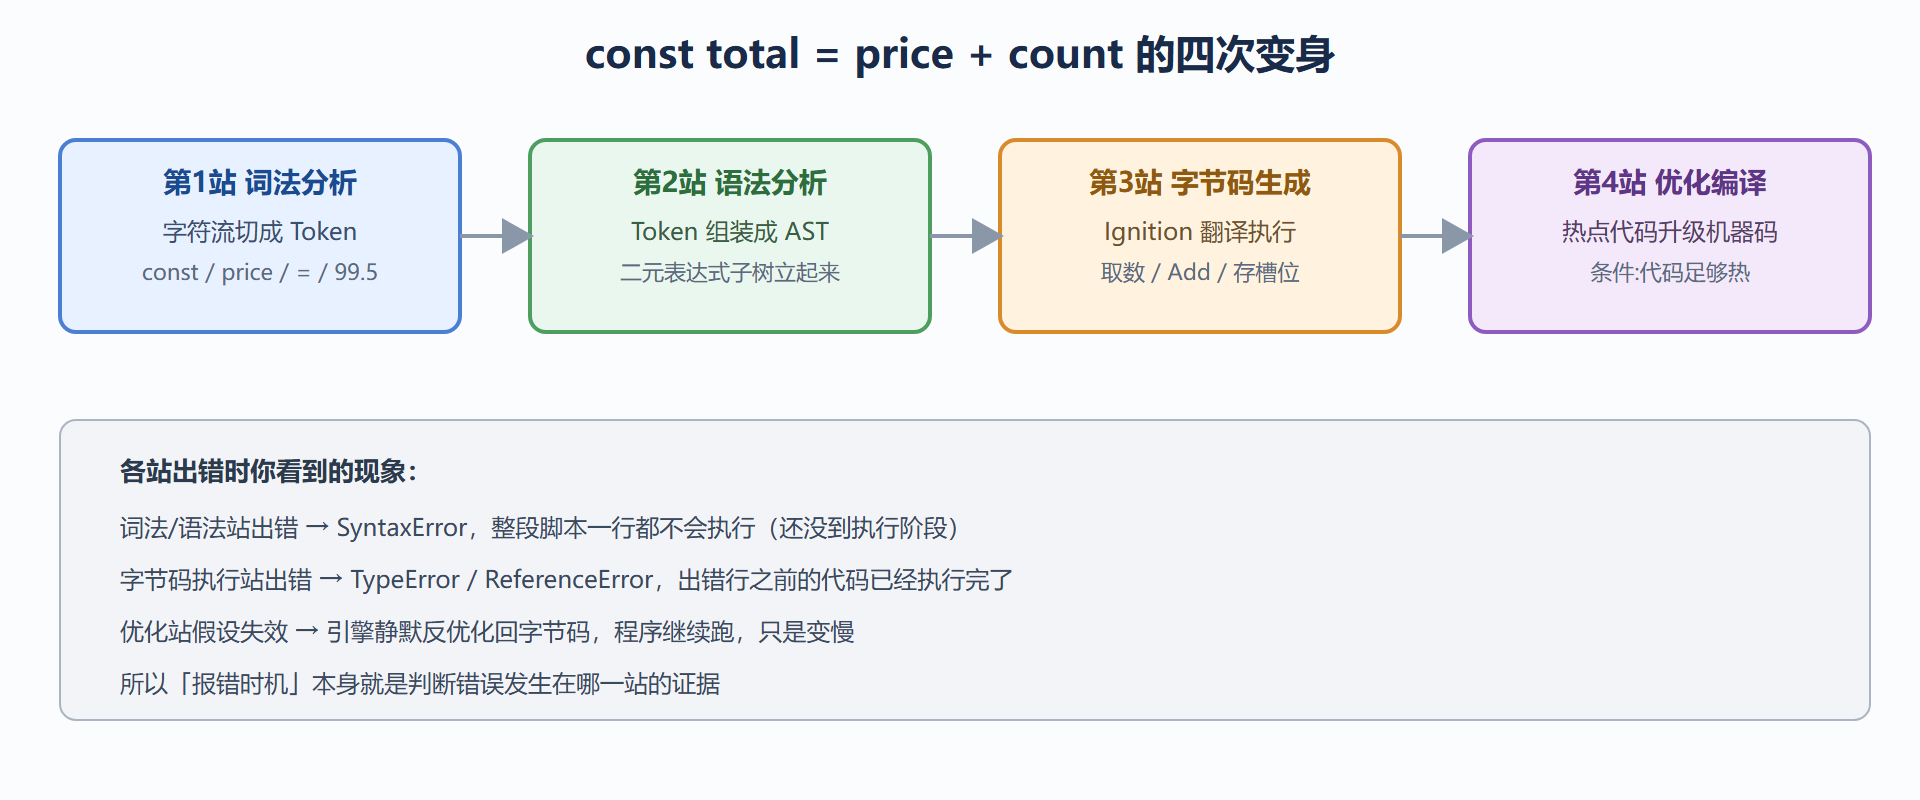
你看到的是一行加法,引擎看到的是四次变身。第一次变身发生在词法分析站:扫描器把这行字符流切成一个个 Token——const 是关键字,price 是标识符,= 是运算符,99.5 是数字字面量。第二次变身发生在语法分析站:解析器把 Token 流组装成抽象语法树(AST),price + count 成为一棵「二元表达式」子树,左子树是变量 price,右子树是变量 count。第三次变身在字节码生成站:Ignition(V8 的解释器)把 AST 翻译成字节码指令序列,大意是「从寄存器取 price,从寄存器取 count,执行 Add,把结果放进 total 对应的槽位」。第四次变身不一定发生——只有当这段代码足够热,优化编译器才会把它升级成直接操作寄存器的机器码。
图 1.1-1 一行加法在引擎里的四次变身
「解释型语言」这句话过时在哪
教科书常把语言二分为「编译型」和「解释型」,JavaScript 被归入后者。这个说法在 2008 年以前基本成立,当年引擎确实是一边念 AST 一边执行。但现代 V8、SpiderMonkey、JavaScriptCore 全部走了即时编译(JIT)路线:先快速生成通用的字节码立刻执行,同时收集运行时反馈,把反复执行的热代码交给优化编译器生成机器码。
这个设计解决了一对矛盾:JavaScript 没有静态类型信息,无法像 C 那样提前一次编译到位;但纯解释执行又太慢。JIT 的思路是「先跑起来,跑热了再加码」。代价是优化必须基于猜测——比如引擎观察到 price + count 这里的操作数十次都是数字,就赌它下次还是数字,生成「按数字加法」的机器码;一旦赌输(下次来了个字符串),就丢弃机器码退回字节码,这个过程叫反优化(deopt)。第 6 章会专门讨论怎么写代码才不容易把引擎的赌注打翻。
V8 目前的编译分层大致是:Ignition 负责生成并解释字节码,Sparkplug 生成朴素的机器码,Maglev 做中层优化,TurboFan 做深度优化。分层的目的同样是省钱:不是所有代码都值得花时间深度优化,页面初始化代码可能只跑一次,为它生成机器码纯属浪费。你不需要记住每个层级的名字,但要记住一个事实:同一行代码在不同时刻可能以不同的形态在跑。
用实验感受一下「越跑越快」:
function add(a, b) { return a + b; } console.time('cold'); for (let i = 0; i < 100000; i++) add(i, i); console.timeEnd('cold'); // 实测约 2.8 ms(未优化阶段) console.time('warm'); for (let i = 0; i < 100000000; i++) add(i, i); console.timeEnd('warm'); // 实测约 61 ms,摊到每次明显更快(已被优化)
冷段和热段在同一个函数上测,热段每次调用的平均耗时低了一个数量级还多。这正是引擎在循环过程中把 add 升级成机器码的效果。不同机器数字不同,但「同一段代码第二次更慢的量级被摊平」的趋势稳定可见。
语法错误的时机:一条判别证据
理解流水线后,「错误发生在哪一站」可以从报错行为反推。看这段:
console.log('第一步'); let x = = 5; console.log('第二步');
实测输出:
Uncaught SyntaxError: Unexpected token '='
注意:连「第一步」都没打印。因为语法分析在执行之前,整段脚本压根没获得执行资格。这是 JavaScript 与 Python 这类逐行解释语言的一个显著差异——整段先过编译站,过了才开始跑。
对比另一段:
console.log('第一步'); null.x; console.log('第二步');
实测输出:
第一步 Uncaught TypeError: Cannot read properties of null (reading 'x')
「第一步」打印了,错误在执行站才发生。以后遇到「为什么我的 console.log 没输出」,先想想它是不是被语法错误连坐了。
字节码长什么样(概念版)
字节码不必会读,但看一眼有助于建立「执行是取指令-执行-取下一条」的循环感。伪化后的形态:
LdaGlobal [console] ; 取全局对象 console Star0 ; 存进 0 号寄存器 LdaNamedProperty [log] ; 取 log 方法 Star1 LdaConstant ['total'] ; 取常量字符串 CallProperty1 r0, r1 ; 调用 Return
每一行都是一次「取指令、操作寄存器或槽位」的动作。解释器就是把这个循环转起来,同时给每条字节码挂一个反馈向量(feedback vector),记录「这个加法见过的操作数类型」。这些记录就是后面优化编译器下注的依据。你在第 3 章会看到反馈向量如何配合隐藏类让属性访问提速,在第 6 章会看到打赌失败的反优化现场。
从流水线看开发者的四个推论
推论一:语法层面的差异可能毫无运行时差异。 箭头函数、解构赋值、模板字符串在字节码层面往往殊途同归。面试问「箭头函数比普通函数快吗」,从流水线视角看答案是:调用开销没有本质差别,差别在 this 绑定与 arguments 对象的创建,且微乎其微。性能敏感场景真正该关心的是第 3 章的形状稳定和第 6 章的内存分配。
推论二:eval、new Function 会让优化失效。 它们在运行时动态产生新源码,意味着流水线前几站要在执行中途重新开工,引擎对包含它们的函数倾向于放弃深度优化。写框架的同学尤其要注意,配置驱动的代码生成可以用对象映射替代字符串拼接求值。
推论三:报错的行号来自源码映射。 引擎执行的形态已经和源码不同,报错能给出准确行号,靠的是各站保留的映射信息。生产环境压缩混淆后报错行号对不上,就是因为压缩工具改了行号而映射没配好——部署时启用 source map 是流水线视角下的必然要求。
推论四:启动阶段少做一次性工作。 初始化代码只跑一次,引擎不会为它优化,却有解析、编译的固定成本。超大依赖包拖慢首屏,一部分就是「编译站太忙」。这也是tree-shaking、代码分割这些工具存在的引擎层理由,第 7 章讲模块加载时会呼应这一点。
收束:流水线是全书的坐标系
本节建立的四个站点——词法、语法、字节码、优化——是后续所有讨论的坐标系。下一节我们把镜头对准「执行即将开始、还没开始」的那个瞬间:引擎创建执行上下文、登记变量。为什么 var a 声明前访问不报错而 let b 会报错,答案就藏在这个瞬间的登记表里。
- 要点:源码必经词法分析、语法分析、字节码生成,然后才执行;SyntaxError 意味着整段未执行,TypeError 意味着执行到一半;
- 要点:现代 JavaScript 引擎是 JIT 分层架构,热代码升级为机器码,赌错就反优化;
- 要点:同一行代码可能同时存在字节码和机器码两份形态,性能测量必须区分冷热;
- 要点:反馈向量记录运行时类型信息,是优化的下注依据,也是形状稳定的伏笔。
观测优化的两个现场
想亲眼看到优化与反优化,有两个低成本的观测位。
观测位一:断点处的变量面板。 在一段循环了上万次的函数里打断点,开发者工具的局部变量面板偶尔会显示某变量为「optimized out」——不是丢失,而是优化后的机器码把这个变量彻底装进了寄存器甚至被编译器消除,调试器找不到它的存储位置。看到这行字应该高兴:说明这函数已经被优化编译接管了。想看到真实值,可以在断点设置里关掉附近代码的优化,或临时改写成防止优化的形式调试完再改回。
观测位二:冷热两段的耗时比。 前文的 console.time 实验就是最小版本。更规范的做法是把同一段逻辑各测三轮:第一轮是冷态(解释执行),第二轮是过渡态(可能正在优化),第三轮才是稳态。对比三轮的耗时曲线,能看出优化「上线」的时刻。工程上做性能对比务必在稳态测——在冷态比较两个写法的快慢,得出的结论可能与线上相反。
function work(arr) { let s = 0; for (const v of arr) s += v; return s; } const big = Array.from({ length: 1e6 }, (_, i) => i); for (let round = 1; round <= 3; round++) { console.time(`第${round}轮`); work(big); work(big); work(big); console.timeEnd(`第${round}轮`); } // 实测形态:第1轮约 9ms,第2轮约 6ms,第3轮约 5ms —— 逐轮走低即优化上线
常见问答
为什么我打了断点,页面上半部分的代码还是执行了?
断点拦的是「执行到这一行」,而解析、编译在你触达断点前就完成了。更常见的情况是:你断点的那段代码根本还没被调度(在等事件、等定时器),第 4 章的队列模型会解释「代码什么时候才有机会执行」。
eval 到底能不能用?
语言层面能,工程上仅剩两个合理场景:把用户输入的表达式当计算器求值(要先做严格校验),以及极少数动态代码生成的框架内部。除这两类外,任何「用 eval 解决」的问题几乎都有对象映射、查表、动态属性访问的正解,而且不用放弃优化、不用背安全风险。
AST 这个词在业务开发里会用到吗?
会,而且越来越频繁:代码压缩、lint 规则、代码高亮、AST 查询与改写(自动化重构)、模板编译,全部建立在语法树的产物上。你不需要会手写解析器,但「代码在工具眼里是一棵树」这个心智模型,能让你理解这些工具为什么能做到「改代码不跑代码」。
直接跑源码和跑打包产物,行为会有差异吗?
语义不会(规范保证),性能与报错体验会。产物经过压缩与合并,解析更快、缓存更友好,但报错行号需要 source map 还原;产物里的模块已被拍平,某些依赖「文件级加载顺序」的老代码行为可能显形差异。这也是为什么本地调试与线上排障要分别确认「跑的到底是哪份代码」——流水线视角下,它们是同一棵 AST 的两种物理形态。
性能面板里能看到 Ignition 或 TurboFan 这些名字吗?
常规面板不直接展示编译器层级,但能间接观测:JavaScript 火焰图里函数旁偶尔标注的「已优化」徽记、以及本节实验里冷热两段的耗时台阶,都是优化上线的痕迹。想看引擎内部细节,需要带调试标志启动浏览器或 Node,属于引擎开发者的工具。对应用开发者,「优化存在且会动态变化」这个认知本身,比看见它更重要——它解释了为什么任何测量都要预热、任何对比都要稳态。