1.3 类型转换与双等号的仲裁现场
1.3 类型转换与双等号的仲裁现场
本节摘要:双等号的宽松比较遵循一条固定的仲裁流程——先判类型相同与否,类型相同时直接比较(注意 NaN 与数字 0 的特例),类型不同时引用类型先经 ToPrimitive 转成原始值,再按 null/undefined、数字、字符串的通道归一。本节把这条流程写成可执行的判定步骤,配合一批实测输出,让
[] == false、null == 0这类「怪题」变成可推导的普通题。
一道面试题的现场还原
先接受四连击,全部为真实控制台输出:
console.log([] == false); // true console.log([] == ![]); // true console.log(null == 0); // false console.log('0' == 0); // true
第三行尤其反直觉:null「明明是假的」,跟 0 比却是 false;而空数组跟 false 比反而相等。如果靠背对照表,这类题目永远背不完,因为组合是类型数的平方量级。正确姿势是把仲裁流程本身学会——引擎不是查表,而是走流程,每一步都有明确的分支条件。
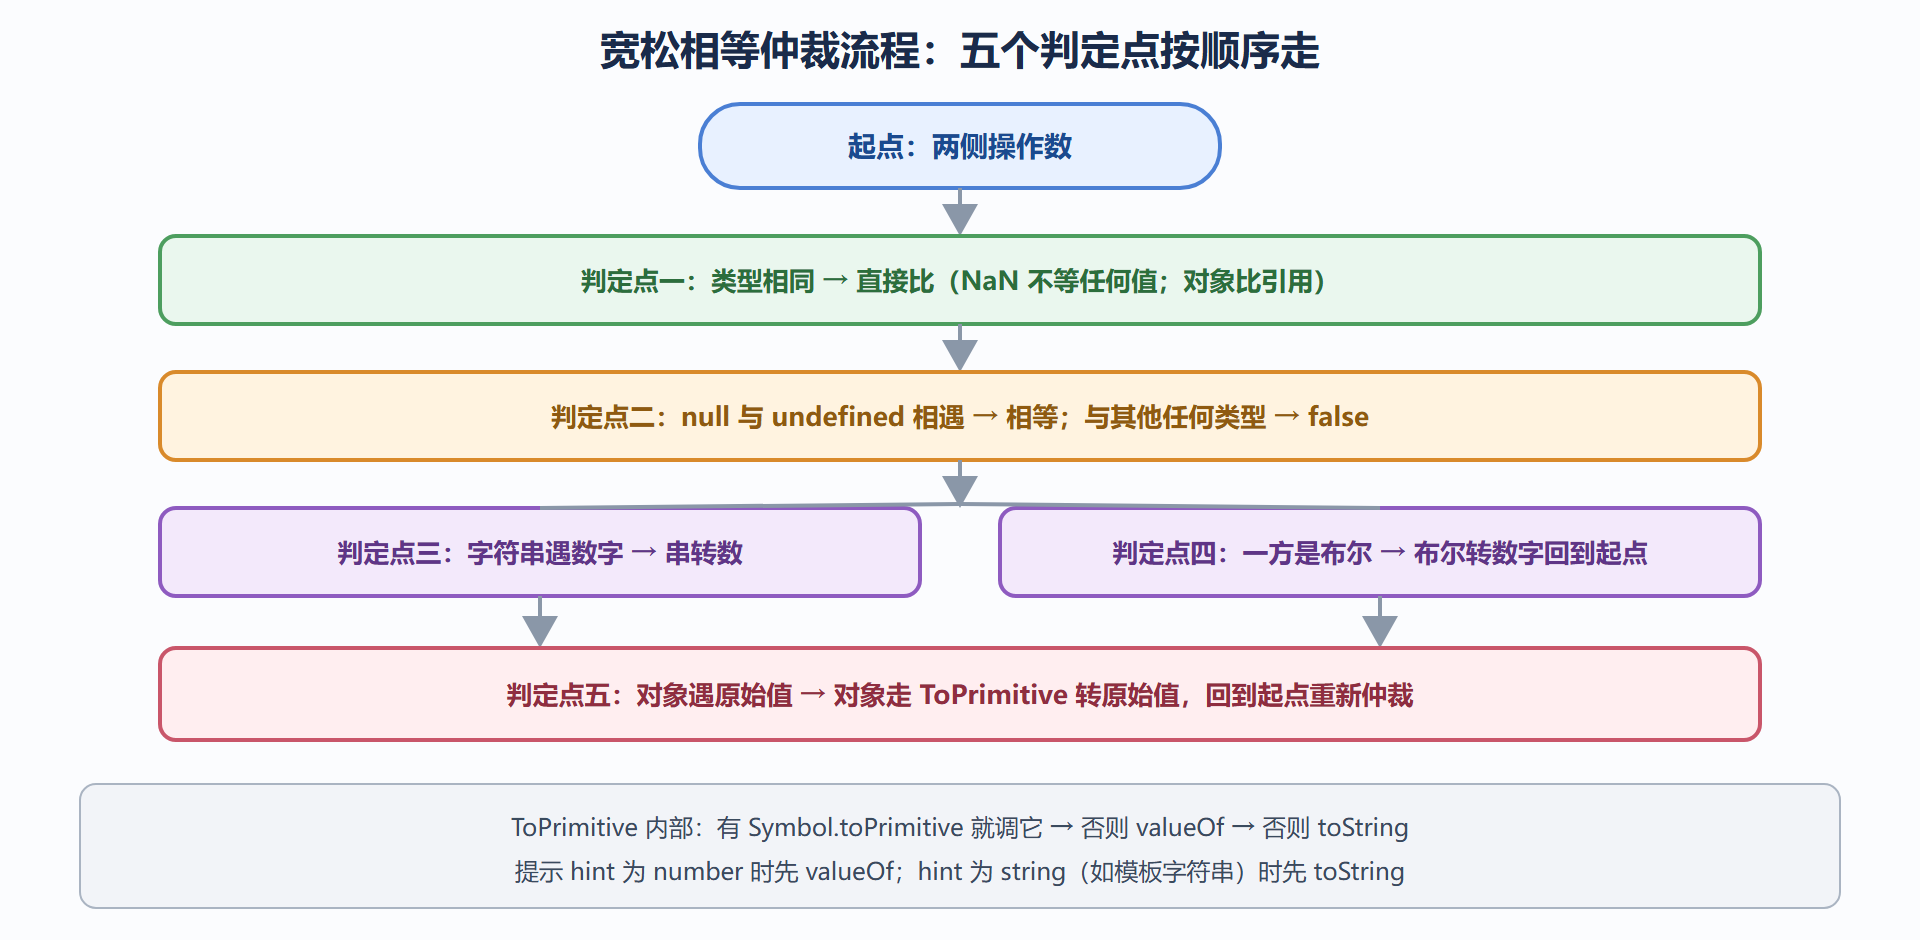
仲裁流程的五个判定点
把引擎的宽松相等算法翻译成中文流程,一共五个判定点,按顺序执行:
判定点一:类型相同吗? 相同则直接比值。数字比数字注意 NaN 不等于任何值(包括自身);对象比对象比较引用(是不是同一个东西,而不是内容是否一样)。
判定点二:null 与 undefined 相遇吗? null 和 undefined 宽松相等(互相都为 true),且它们不与任何其他类型相等。这就是 null == 0 为 false 的出处——流程走到这个判定点直接返回 false,根本轮不到数值转换。
判定点三:有一方是数字,另一方是字符串吗? 字符串转数字再比。'0' 被转成 0,于是 '0' == 0 为 true。字符串转数字的规则是「先去首尾空白,再按数字语法解析,解析不了就是 NaN」——' '(纯空格)转 0,'abc' 转 NaN。
判定点四:有一方是布尔吗? 布尔先转数字(true 转 1,false 转 0),然后回到流程开头重新仲裁。注意这一步只转布尔自己,不动对方。
判定点五:对象遇到原始值了吗? 对象先经 ToPrimitive 转成原始值,然后重新仲裁。ToPrimitive 的细节是下一小节的重头戏。
现在用流程重做开头的四连击。[] == false:类型不同(对象 vs 布尔)→ 判定点四,false 转 0,变成 [] == 0 → 判定点五,[] 经 ToPrimitive:先调 valueOf 得到数组自身(不是原始值),再调 toString 得到空字符串 '',变成 '' == 0 → 判定点三,'' 转数字 0 → 0 == 0,true。[] == ![]:先算右边,对数组取反走 ToBoolean(任何对象都是 true),![] 即 false,问题退化成上一题。null == 0:判定点二直接判 false。'0' == 0:判定点三,true。
图 1.3-1 双等号仲裁流程卡
ToPrimitive:对象交出原始值的三道门
判定点五是大多数「怪题」的孵化器,值得单独拆开。引擎要让对象变成原始值时,依次尝试三道门:
const obj = { valueOf() { return 42; }, toString() { return '我是个对象'; } }; console.log(obj == 42); // true(valueOf 交出 42) console.log(`${obj}`); // "我是个对象"(模板字符串走 string 提示,先 toString)
数值语境(比较、算术)下先敲 valueOf 的门,字符串语境(模板字符串、String())下先敲 toString 的门。数组没有自定义 valueOf,继承自 Object.prototype 的默认实现返回数组自身(不是原始值,等于没交卷),于是轮到 toString——把元素用逗号连接:
console.log([1,2] == '1,2'); // true([1,2].toString() 是 "1,2") console.log([] + {}); // "[object Object]"('' + "[object Object]") console.log([] + []); // ""('' + '')
[] + {} 输出 [object Object] 而不是很多人猜的报错,就是这个链条:空数组转空字符串,空对象调 Object 原型的 toString 得到 [object Object],两个字符串拼接。顺带一提,一元加号会把整个表达式变成数字语境:+[] 是 0,+[1] 是 1,+[1,2] 是 NaN('1,2' 解析不成数字)——JSFuck 这类把代码压缩到只剩方括号的黑魔法,原料全是本节的转换规则。
还有一个常被忽略的细节:Date 对象是唯一默认 valueOf 返回数字的内置对象,所以 new Date(0) == 0 为 true。自定义类型如果两道门都交不出原始值,引擎直接抛 TypeError——{} + 1 在语句位置不报错是历史包袱(被解析成空语句加表达式),用括号包起来 ({} + 1) 仍是字符串拼接,而真正会抛错的是把对象用在需要原始值的严格算术场景。
数字精度:不是转换,是存储
另一类「诡异相等」跟转换无关,跟浮点存储有关:
console.log(0.1 + 0.2 === 0.3); // false console.log(0.1 + 0.2); // 0.30000000000000004 console.log((0.1 + 0.2).toFixed(2) === '0.30'); // true
JavaScript 的数字是 IEEE 754 双精度浮点,0.1 和 0.2 在二进制里是无限循环小数,存储时被截断,相加的误差在十进制第 17 位显形。这不是 JavaScript 独有的缺陷,Python、Java 的 double 同样如此。工程上的处理办法有三个层次:展示层用 toFixed 或 toPrecision;金额计算先乘以进制倍数转整数再算;高精度场景用 BigInt(整数)或专门的十进制库。另外注意 NaN === NaN 为 false,判断 NaN 用 Number.isNaN 而不是自己写相等比较。
加号还有一个分工陷阱:只要一侧是字符串,加号就走拼接通道,另一侧被转成字符串:
console.log(1 + 2); // 3 console.log(1 + '2'); // "12" console.log('1' + 2); // "12" console.log(1 + 2 + '3'); // "33"(先算 1+2,再拼接) console.log('1' + 2 + 3); // "123"(从左到右,'1'+2 先变 "12")
而其他算术运算符没有拼接通道,一律转数字:'6' * '7' 是 42,'abc' * 2 是 NaN。所以「从用户输入拿到的数字」必须先做显式转换(Number、parseInt 或一元加),这是把隐式转换的地雷主动拆除的做法。
工程取舍:什么时候可以放心用 ==
主流规范推荐一律用 ===,这在小团队是零成本的好规则。但在一个场景里 == 反而是更正确的工具:判断「空值」。x == null 能同时命中 null 与 undefined,等价于 x === null || x === undefined。由于引擎保证 null 与 undefined 只互相相等,这个写法没有其他副作用。框架源码里常见的判空写法 if (value == null) skip() 就是取这条窄通道。
除此之外的比较,尤其是与 0、空字符串、数组、对象相关的,一律用 ===。再用一张对照表把本节的关键实测收敛一下:
| 表达式 | 结果 | 依据的判定点 |
|---|---|---|
null == undefined |
true | 判定点二 |
null == 0 |
false | 判定点二直接终止 |
NaN == NaN |
false | 判定点一(数字比较 NaN 不等) |
'0' == 0 |
true | 判定点三 |
[] == false |
true | 判定点四 + 五 + 三 |
[] == ![] |
true | 取反后退化成上一行 |
[1,2] == '1,2' |
true | 判定点五(toString) |
new Date(0) == 0 |
true | Date 的 valueOf 交出数字 |
- 记住流程而非表:五个判定点按序走,任何宽松比较都能现场推导;
- 对象交卷有三道门:Symbol.toPrimitive、valueOf、toString,数值语境与字符串语境的敲门顺序不同;
- 浮点误差是存储问题,与转换无关,金额场景转整数运算;
- 判空可用 == null,其余场景统一
===,把隐式转换限制在明确知道引擎会走哪条通道的地方。
隐式转换排雷清单
三个真实事故形态,全部来自「引擎的转换通道」与「程序员的直觉」错位。
雷区一:真值判断吞掉合法值。 表单与配置场景的经典事故:
function showBadge(count) { if (count) { // 想判断「有没有」 render(count); } } showBadge(0); // 什么都不渲染 —— 0 是合法值但被当成了「没有」
修法是问清楚语义:「有没有」用 count !== undefined,「是否为正数」用 count > 0。同雷区的还有空字符串(用户清空输入框)、NaN(一次失败的计算)。
雷区二:加号拼接数字。 电话号码、证件号、ID 一旦以字符串形式出现(输入框的 value 永远是字符串),与数字相加就变成拼接:
const areaCode = '010'; const number = 8623; console.log(areaCode + number); // "0108623" —— 拼接 console.log(Number(areaCode) + number);// 8833 —— 先归一再算
ID 类字段(超出安全整数范围的)更该全程按字符串处理,只做拼接与比较,绝不转数字。
雷区三:比较运算的字符串通道。 两个字符串比较走字典序,不是数值序:
const v1 = '9', v2 = '10'; console.log(v1 > v2); // true(字典序:'9' 排在 '1' 后面) console.log(Number(v1) > Number(v2)); // false
版本号比较是此雷区的变体:'1.10' 与 '1.9' 的字典序结果与版本语义相反,正确做法是按点分段转数字逐段比。清单收成一句话:从外部世界(输入框、URL、接口字段、存储)进来的值,先显式归一到程序想要的类型,再进业务逻辑——把仲裁流程从「引擎暗走」变成「代码明走」。
常见问答
既然 === 更安全,为什么语言不干脆去掉 ==?
兼容性锁死:1995 年的语义已随数以亿计的页面固化,去掉等于折断整个 Web。规范采取的路线是「保留机制、社区自律」——风格规则统一 ===,只在判空窄通道用 ==。理解机制的价值在于读老代码:存量里大量 == 不是原作者无知,而是当年社区的常见写法。
Symbol.toPrimitive 在业务里用得上吗?
低频但精致:给值对象定义统一的转换行为(比如一个金额类,转字符串带格式、转数字去格式),测试断言里输出友好的失败信息也是它。用之前先确认这个类型真的会被引擎转换(比较、拼接、模板字符串),否则自定义了也无人调用。
Object.is 和 === 有什么区别?
Object.is 把 NaN 与 NaN 判为相等、把正零与负零判为不等,在这两个特殊值上比 === 更「数学正确」。日常比较用 ===,涉及 NaN 判断(比如检测计算是否产出 NaN)或区分正负零的边缘场景用 Object.is。
一元加号、Number()、parseInt 取值有什么差别?
三个都是「变数字」,通道不同:一元加号与 Number 走完整强制转换(空字符串转零、纯数字字符串转数字、含小数点十六进制都能处理、失败得 NaN);parseInt 从头解析、遇非数字字符停(能解析 '12px' 得 12),还接受第二参进制。经验法则:纯数字形态的规范化用 Number;从混杂文本里抠数字('宽度:33px')用 parseInt 加进制参数;一元加号是 Number 的短写,团队里选一种统一风格即可。parseFloat 同 parseInt 的浮点版,注意它会解析到第一个非法字符为止。
为什么 typeof null 是 object?还能修吗?
1995 年的实现里类型标签用低位区分,对象标签是零,而 null 在内存上是空指针、低位也是零——于是 null 被判成了对象。这个 bug 只有一次修复机会(被否决了,因为会破坏依赖该行为的存量代码),从此成为语言化石。工程上的应对是判断 null 用全等(value === null),或用 Object.prototype.toString 系的精确类型判定。它和本节主题的关系在于提醒我们:看到的每个行为背后都是一次具体的实现决策,可追溯、可解释,只是不一定合理。
null 加数字、undefined 加数字,结果为什么不同?null + 1 是 1,undefined + 1 是 NaN——两条数值转换通道对「空」的翻译不同:null 转数字得零(「明确的空」按零处理),undefined 转数字得 NaN(「缺失」拒绝参与运算)。这个差异在求和累加里最伤:初始值没给、接口字段缺失,一串加法直接产出 NaN 且静默传播。防御姿势是累加前显式兜底(total += (item.count ?? 0)),空值合并运算符正是为这类「给缺失一个明确默认」的场景生的。
比较运算里的字符串什么时候会转数字?
仅当两侧都是字符串才走字典序;一侧是数字,另一侧字符串就转数字(数字语境优先)。所以 '9' > '10' 为 true(字典序)而 '9' > 10 为 false(数字比较)。记忆锚点:看两侧类型是否一致——不一致时几乎总是数字语境赢,除了 null 与 undefined 那对特殊通道。
日常编码里,隐式转换哪些可以放心用,哪些必须显式?
可以放心的三处:真值判断里对明确「对象或空」的值(元素查到了没有);字符串模板里的自动转字符串(展示用途);空值合并与可选链(它们是显式的语法,不是隐式转换)。必须显式的三处:数值运算前(输入框与接口来的字符串一律先转数字);与零、空字符串的比较(语义歧义区);对象参与相等比较(一律严格等)。这条分界线的底层判据就一条——你能否一句话说清引擎在这走哪条通道;说不清的地方,就把它写成显式转换,让下一个读代码的人不用猜。