5.1 可观测性与排障实战
5.1 可观测性与排障实战
本节摘要:Serverless 把基础设施藏进黑盒,可观测性就是你在黑盒上的探照灯。本节讲三件套的搭建要点(结构化日志、分布式追踪、指标告警)、黑盒环境特有的排障方法(按请求生命周期的检查点定位)、以及三类高频故障的标准定位路径。核心观点:托管化越深,观测越要前置——观测不是上线后的补救,是架构的一部分。
学习目标
阅读完本节,你应当能够:
- 为函数应用设计统一的结构化日志规范与追踪标记
- 读一条分布式追踪链,说出每段的健康判据
- 用"生命周期检查点法"定位延迟类与错误类故障
- 建立分级的告警策略,避免告警泛滥
一、为什么观测在 Serverless 里更重要
传统应用排障的终极手段是"登机看现场"——登上服务器,看进程、看内存、抓包,物理访问给你兜底。Serverless 收走了这台机器,你的排障手段只剩观测数据本身。这不是劣势,是逼着你把"事后登机"的懒惰习惯换成"事前埋点"的工程习惯——观测做得好的传统团队早就这么干了,Serverless 只是把这个好习惯变成了生存必需。另一个特殊性是实例的短命:出问题的实例可能已经被回收,现场转瞬即逝——日志必须在产生的那一刻就输出到外部系统,任何"稍后导出"的方案都赶不上实例的死亡。这两个特殊性合起来推出本节的总纲:观测三件套要在写第一行业务代码之前就位,它们和业务代码是同时代的产物,不是两代的。
二、三件套的搭建要点
2.1 结构化日志:事件的证词
函数日志的第一原则是结构化:每行日志是带上下文字段的对象(时间、请求 ID、函数名、级别、事件、关键业务字段),不是自由文本。两个实战要点:其一,请求 ID 贯穿——入口生成的请求 ID 要透传到所有下游调用与日志行,这是把散落日志串成故事的线头;其二,级别有纪律——正常流程用信息级、需要人看的异常用警告级、真正故障用错误级,级别的意义是给告警与检索提供过滤维度,全错误级的日志等于没有级别。日志量与成本成正比(多数平台按量计费),所以第三条纪律是采样与分级留存:错误全量留存、正常流量低比例采样、调试日志默认关闭按需开。
2.2 分布式追踪:请求的路线图
追踪解决"一次请求经过了谁、每段花了多久"的问题。Serverless 的多函数编排场景里,追踪的价值被放大——一次业务操作跨越五六个函数与三四个 BaaS 是常态,没有追踪的排障等于盲人摸象。搭建要点:选用平台原生集成或通用追踪标准的方案(注入与透传自动完成)、确保跨函数的追踪上下文不断链(异步触发的场景要显式传递)、在追踪里标注业务语义(哪个函数是哪个业务环节的名称要对得上)。读链的健康判据三条:总时长分布(尾部有没有离群点)、单段耗时排行(最贵的一段是不是业务上合理)、错误标记的位置(链在哪一步断的最清楚)。
2.3 指标与告警:健康的警戒线
指标是日志与追踪的聚合视图:调用次数、错误率、延迟分位数、并发水位、冷启动比例——五个核心指标覆盖函数健康的主体。告警设计的三条纪律:分级(错误率与可用性类立即告警、延迟类同比异常告警、趋势类进周报)、去重(同一根因的多条告警合并通知,告警风暴比故障更伤团队)、可行动(每条告警写明"看到后做什么",指向预案文档——不能行动的告警是噪音的种子)。
三、黑盒排障的方法论
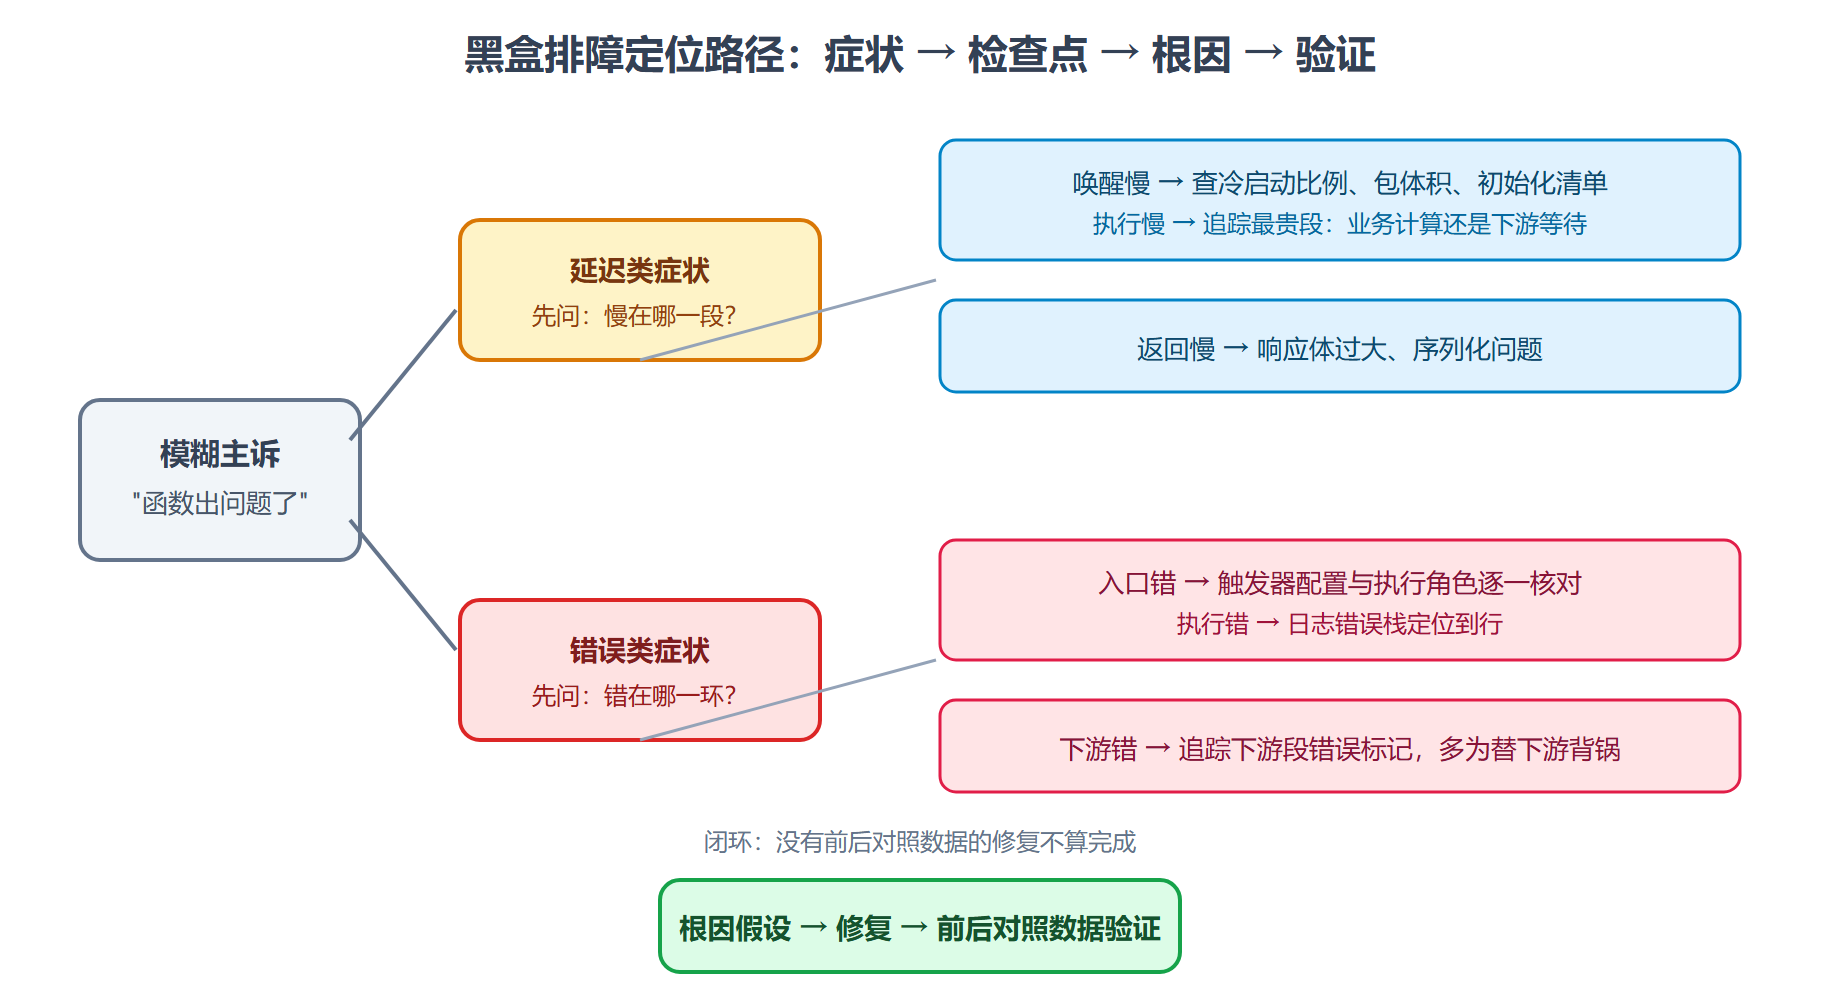
先把整条定位路径画成一张图——从"函数出问题了"这个模糊主诉出发,沿生命周期检查点收敛,最后落到根因验证的闭环:
图:Serverless 黑盒排障定位路径
3.1 生命周期检查点法
排障的第一步是把症状映射到请求生命周期的检查点上(第 4 章的六步图):延迟类故障先问"慢在哪一段"——唤醒慢(冷启动比例高,查包体积与初始化清单)、执行慢(追踪看最贵段,是业务计算还是下游等待)、返回慢(响应体过大或序列化问题)。错误类故障先问"错在哪一环"——入口权限(触发器配置与角色)、执行异常(日志的错误栈)、下游失败(追踪的下游段错误标记)。检查点法的价值是把"函数出了问题"这个模糊主诉,快速收敛到"哪一段的哪种问题"——每一步都有对应的工具与数据,排障从玄学变成查表。
3.2 三类高频故障的定位路径
故障一,偶发的超时:先看超时请求的共性(特定输入?特定时段?特定并发水位)——追踪加日志按共性过滤;常见根因是下游服务在特定负载下的劣化传导(函数本身没病,是替下游背锅)。故障二,权限类报错:报错信息里的资源与动作,对照函数的执行角色逐一核对——多数权限事故是"改了资源名但没改策略"或"角色的策略被别的流程覆盖";预防靠权限的版本化与变更审计。故障三,冷启动尖刺:监控里延迟分位数的周期性毛刺对齐扩容事件——确认是冷启动后按对策清单治理(精简依赖、预热、或架构兜底)。三条路径的共同结构:症状分类 → 数据定位 → 根因假设 → 验证——这又是第 1 章方法论在观测领域的投影。
四、观测的投入产出账
观测的三个投入层级,按回报排序:第一层(必做):结构化日志加错误告警——没有它,任何故障都是盲调,投入一两天,回报无限大。第二层(强烈建议):分布式追踪加延迟告警——多函数体系没有它,排障时间以倍数计,投入一周。第三层(成熟期):业务指标的自定义面板与容量预警——把技术观测升级为业务观测,投入持续但回报是决策质量的提升。三层递进、不必一步到位——但第一层是道德底线,从第一个函数上线起就要有。本节的收尾一句话:在 Serverless 的世界里,观测数据是你唯一能完全掌控的东西——代码会被平台接管,机器会被平台接管,但日志里写了什么、追踪里标了什么、告警怎么设计,全是你说了算——把你能控制的做到极致,是黑盒时代的生存艺术。
本节要点回顾
- 黑盒环境里观测前置是生存必需:实例短命与无法登机,决定了观测必须与业务代码同时诞生。
- 结构化日志三纪律:请求 ID 贯穿、级别有纪律、分级留存控制成本。
- 追踪读法三判据:总时长分布、单段耗时排行、错误标记位置。
- 告警三纪律:分级、去重、可行动——不能行动的告警是噪音。
- 检查点法是排障的第一步:先定位症状在生命周期哪一段,再选工具下钻。
五、观测配置的速查表
| 观测件 | 核心配置 | 常见错误配置 | 验证方法 |
|---|---|---|---|
| 结构化日志 | 统一 schema 加请求 ID 贯穿 | 自由文本无结构 事后 grep 靠猜 | 随机抽一条日志 能否还原请求上下文 |
| 分布式追踪 | 入口采样加跨函数透传 | 异步边界断链 只看总时长不看分段 | 抽一次跨三函数的调用 链路完整且分段合理 |
| 指标告警 | 错误率与延迟分位数为核心 | 只配平均值告警 尾部恶化不可见 | 人为注入一次慢请求 告警是否按时触发 |
| 日志留存 | 错误全量 正常采样 | 全量留存吃成本 或全采样吃预算 | 核对月度日志账单 与留存策略一致 |
一个日志语句的正确形态
import json, time def log_event(level, event, request_id, **fields): # 统一结构:时间、级别、事件、请求ID、业务字段 entry = { "ts": time.time(), "level": level, # info / warn / error 三级纪律 "event": event, # 动词短语:"thumbnail_generated" "rid": request_id, # 贯穿全链的线头 } entry.update(fields) # 业务字段:尺寸、耗时毫秒、产物大小 print(json.dumps(entry, ensure_ascii=False))
这个十行的辅助函数是观测纪律的最小落地:每条日志都是同构对象、请求 ID 显式传递、字段名统一——三个月后排查问题时,"按 rid 聚合出完整时间线"这一步能否秒级完成,就取决于今天这个函数是否被每一处调用遵守。观测的功力不在平台多强,在纪律多稳。
六、排障时间线示例
补一个真实风格的排障记录作收尾。现象:周五晚图片流水线错误率突增至百分之五。时间线:告警触发(错误率阈值)——查日志聚合,错误集中在"下载原图超时";查追踪,超时的请求全部指向同一个源桶分区;查变更记录,当晚有一批大图批量上传(运营活动),单图体积从两兆变成三十兆。根因:处理函数的超时配置按小图预算设定,大图下载加处理超了预算。处置:临时调高超时与内存档位(大图需要更多处理时间),错误率回落;根治:上传侧加客户端压缩引导、处理函数按图片大小分两条流(大图走高配置函数),并给"输入体积"加了告警前置。这个案例的教学点:排障的每一步都是"下一层证据"(告警→日志→追踪→变更记录),而根治的动作永远包括"让下次的发现更早"——观测体系就是这样在一次次事故里长大的。
最后补一个观测的自检仪式:每月随机抽一条生产故障(或人为注入一次),计时走完"告警触发到根因定位"的全流程——月度抽检的定位时长趋势,就是观测体系健康度的真实成绩单;体系是为故障而生的,定期让它见见真故障,才知道三件套的螺丝有没有松。
最后再补一个观测的度量指标:MTTR(平均恢复时长)应该作为观测体系的核心 KPI 挂在团队看板上——它把"观测好不好"翻译成业务听得懂的语言(故障少了多久);围绕 MTTR 做季度复盘(哪次恢复快、为什么,哪次慢、卡在哪),观测建设的方向就永远与业务价值对齐——不被使用的观测是成本,被 MTTR 引用的观测才是资产。
再补一条观测的扩展点:业务级的自定义指标(处理成功率、队列深度、业务耗时)应与技术指标并列在同一面板——故障影响评估与根因定位都离不开业务维度的坐标;纯技术面板看得见错误率看不见"影响了多少订单",补上业务指标这层,观测才算真正服务于决策。
最后一句:观测体系的建设没有终点,但有里程碑——第一个里程碑是"任何故障两小时内定位",第二个是"一小时",第三个是"十五分钟";每个里程碑的达成都是三件套某处的一次升级——把里程碑挂在团队看板上,观测建设就从抽象工程变成了有刻度的攀登。